Вопросы на собеседовании DevOps: диагностика сбоя по логам и метрикам
Quick Overview
Оригинальный учебный инцидент checkout: 5xx, метки ревизии, счётчики, очередь пула и условный откат; проверенные числа и границы вывода.
На вопрос «после релиза выросли ошибки — что делать?» полезнее ответить проверяемой последовательностью, чем списком команд. Сначала определите, какие запросы страдают, затем сопоставьте версии и время, выберите наблюдение, которое различит гипотезы, и объясните условия безопасного восстановления. Низкая загрузка CPU сама по себе не подтверждает исправность сервиса.
Разберём авторский учебный инцидент: новая ревизия checkout возвращает больше ошибок, хотя процессор почти не изменился. Для самостоятельного ответа откройте Triage a Suddenly Slow Production Service и объясняйте следующий шаг через ожидаемый результат проверки.
Граница доказательств: официальная документация определяет поведение метрик и Deployment; числа, логи и условия отката ниже придуманы для упражнения. Локально проверена арифметика пакета, а не работа Kubernetes или Prometheus. Отчёты кандидатов не используются; это не обещание конкретных вопросов работодателя.
Как начать ответ: влияние, окно, знаменатель
Уточните, что означает «ошибки»: HTTP 5xx, отказ бизнес-операции, тайм-аут клиента или запись ERROR. События могут пересекаться и при этом описывать разные неудачи. Спросите о маршруте, регионе, ревизии, времени начала и количестве завершённых запросов. Без знаменателя восемьдесят ошибок не показывают долю пострадавших операций; без окна нельзя сравнить интенсивность.
В нашем пакете каждое окно длится пять минут и содержит ровно тысячу завершённых запросов. Ошибка — ответ checkout с HTTP 5xx. Клиентские отмены и незавершённые запросы в этот счётчик не входят. Поэтому рассчитанная доля описывает выбранный сигнал, а не весь пользовательский ущерб. Если клиент повторяет запрос, необходимо отдельно проверить, не превращается ли одна неудачная покупка в несколько событий.
Скажите вслух: «Сначала сравню одинаковые маршруты и интервалы, затем отдельно проверю повторы и незавершённые операции». Это полезнее мгновенного вывода о базе данных. Даже корректно посчитанная метрика может отвечать на слишком узкий вопрос. Не меняйте её определение посреди ответа, иначе сравнение до и после потеряет смысл.
Пакет инцидента: наблюдения до объяснений
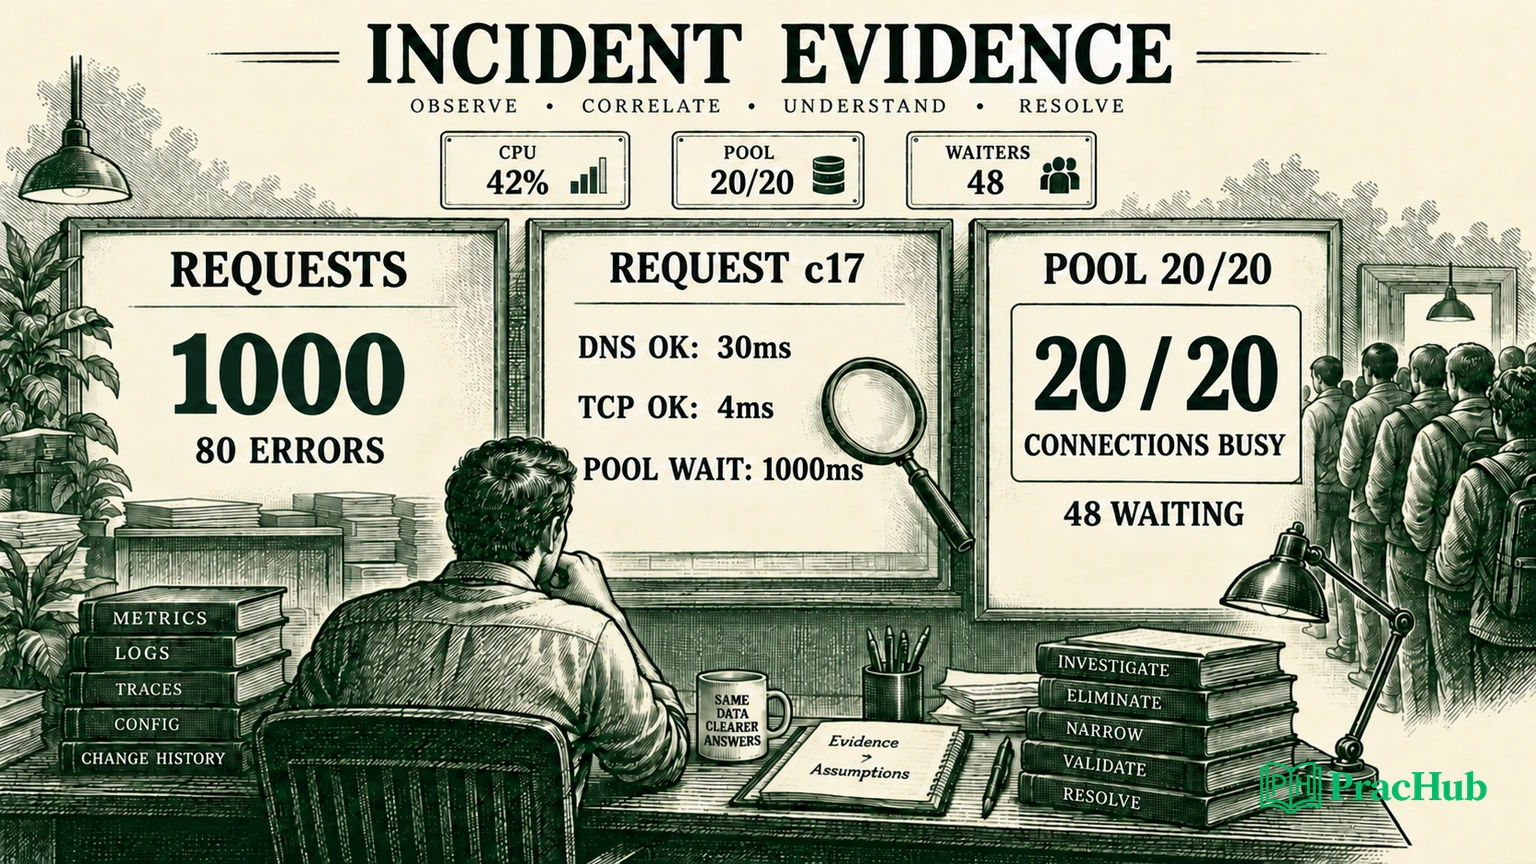
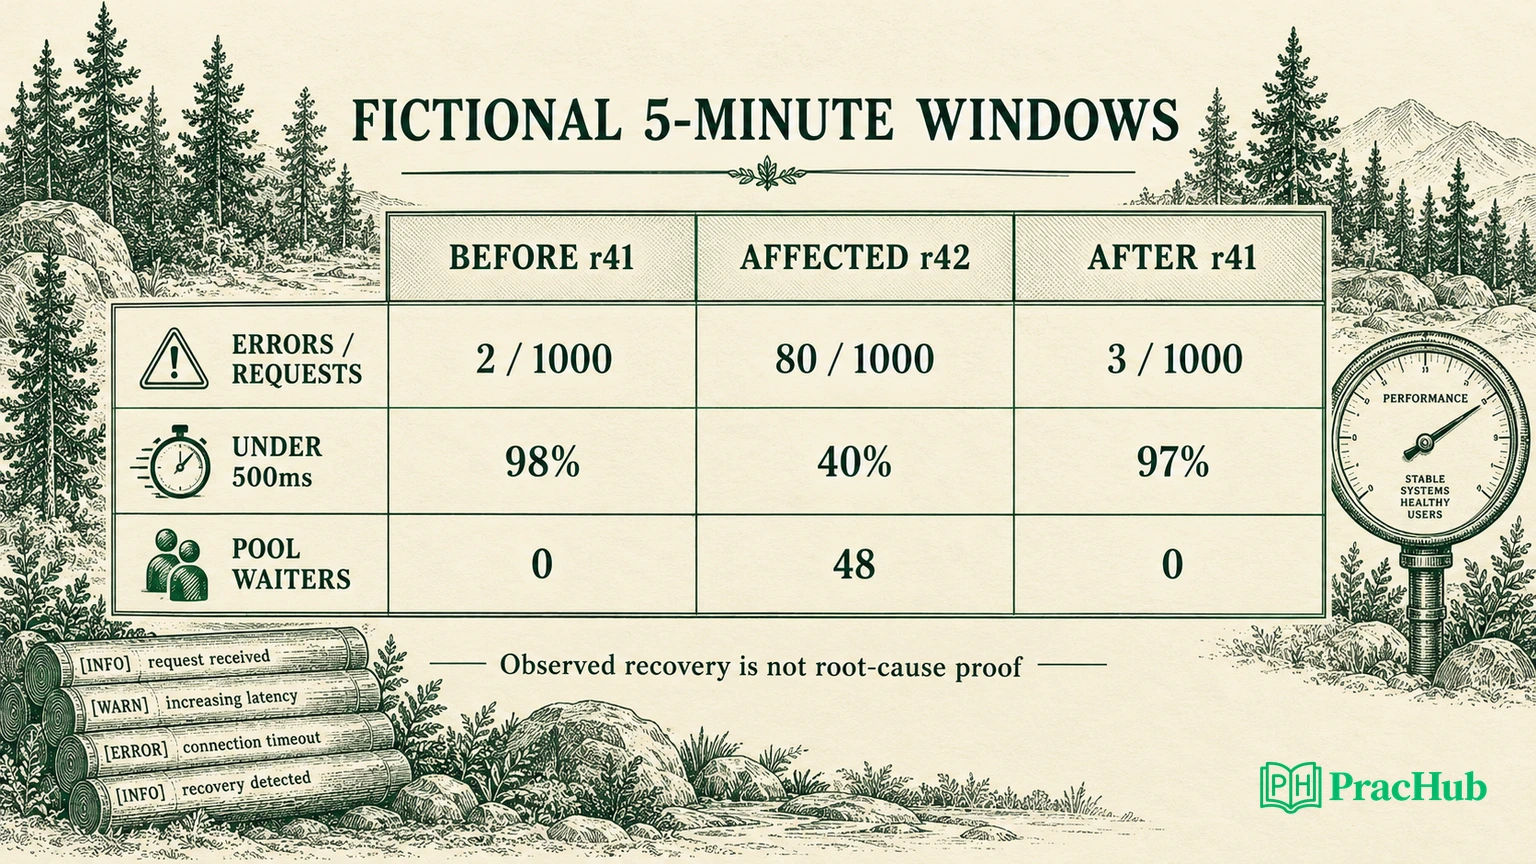
Перед релизом обслуживает r41. В 10:02 UTC начинается выкладка r42; в 10:03 появляется связанный с запросом c17 тайм-аут получения соединения; в 10:05 срабатывает учебный сигнал роста ошибок. Таблица содержит отдельные пятиминутные окна, а не мгновенные значения на одной шкале времени.
| Окно и ревизия | Ошибки / запросы | Ответы быстрее 500 мс | Ожидающие соединения |
|---|---|---|---|
| До, r41 | 2 / 1000 = 0,2% | 980 / 1000 = 98% | 0 |
| Нарушение, r42 | 80 / 1000 = 8% | 400 / 1000 = 40% | 48 |
| После учебного восстановления, r41 | 3 / 1000 = 0,3% | 970 / 1000 = 97% | 0 |
Для затронутого окна CPU равен 42%, память — 60%, заняты 20 из 20 соединений. До релиза соответствующие значения составляли 40%, 58% и 10 из 20. Пакет не содержит OOM-событий и ошибок DNS. Наблюдения относятся к заданному окну и набору сигналов; другие сетевые или ресурсные проблемы ещё не исключены.
Первый вывод можно сформулировать осторожно: «У новой ревизии хуже пользовательские сигналы; одновременно насыщен пул». Следующий, более сильный вывод — «релиз вызвал утечку соединений» — пока не обоснован. Совпадение времени задаёт направление расследования, но не заменяет проверку механизма. Например, длительный запрос к базе способен занять весь исправный пул.
Какие вопросы задать по логам
У c17 сохранена короткая последовательность: dns_ok за 30 мс, db_tcp_ok за 4 мс, затем pool_acquire_timeout после 1000 мс. Идентификатор запроса связывает события внутри упражнения. В реальной системе сначала уточните, что именно измеряет каждая запись: установка TCP-соединения, получение готового соединения из пула или выполнение SQL — разные этапы.
Из этих логов следует, что зарегистрированное разрешение имени и проверка TCP для c17 завершились. Не следует, что все сетевые пути исправны, что аутентификация базы прошла или что запросы выполняются быстро. Один удачный сетевой пробник не исключает кратковременный сбой на другом узле. Отсутствие записи тоже требует проверки полноты сбора и уровня логирования.
Спросите о согласованности часов и месте формирования timestamp. Если агент доставки логов задержался, порядок поступления в хранилище отличается от порядка событий. Для данного пакета время уже приведено к UTC и последовательность задана явно. В ответе на незнакомую систему это должно быть уточнением, а не молчаливым предположением.
Полезный результат первого просмотра — небольшая временная линия с источником каждой записи. Не переписывайте весь журнал: выберите события, связывающие начало изменения, первый симптом, пользовательский сигнал и восстановление. Сохраняйте идентификаторы без паролей, токенов и содержимого пользовательских запросов.
Как различить ресурсную и сетевую гипотезы
Составьте несколько конкурирующих объяснений и назовите наблюдение, способное изменить ваше решение. В официальном руководстве Google SRE по диагностике расследование строится вокруг гипотез и их проверки. Применение этого подхода к нашему пулу — авторский разбор, а не опубликованный инцидент Google.
| Гипотеза | Что поддерживает её в пакете | Следующая различающая проверка |
|---|---|---|
| r42 удерживает соединения дольше | Пул 20/20, очередь 48, тайм-аут получения | Сравнить длительность владения соединением и путь release у r41/r42 |
| База медленно выполняет запросы | Может объяснить занятый пул | Проверить длительные запросы, блокировки и время исполнения за то же окно |
| Проблема сети или DNS | Тайм-аут сам по себе неоднозначен | Сопоставить ошибки соединения и разрешения имён по тем же Pod и запросам |
| CPU или память ограничивают работу | Возможны и при неполных агрегатах | Проверить throttling, лимиты, перезапуски и распределение по Pod |
В этом пакете насыщение пула заслуживает первой проверки. Это выбор первой проверки, а не установленная причина. Чтобы предпочесть утечку медленным запросам, нужны дополнительные данные: соединения возвращаются после завершения обработки или остаются занятыми? Есть ли рост времени SQL? Как ведёт себя старая ревизия при сходном трафике?
Не увеличивайте сразу размер пула с двадцати до ста соединений. Увеличение с двадцати до ста соединений может лишь перенести насыщение на базу, если её допустимая нагрузка неизвестна. Обоснуйте, какое ограничение защищает настройка и как будете следить за общим числом соединений нескольких реплик. Исправление, скрывающее симптом на одном графике, ещё не улучшает систему.
Почему общий график способен скрыть проблему
Если объединить два окна по тысяче запросов, получится 82 ошибки на 2000 запросов, то есть 4,1%. Арифметика верна, но исчезает различие между 0,2% у r41 и 8% у r42. Для сравнения ревизий нужны соответствующие метки и одинаковая область наблюдения. Среднее по сервису отвечает другому вопросу.
Официальная документация Prometheus описывает rate для счётчиков с учётом сбросов; сначала вычисляйте скорость по исходным сериям, затем агрегируйте. Такой порядок сохраняет возможность обнаружить сброс отдельного экземпляра. Пример ниже показывает форму запроса, но не выполнялся в Prometheus:
sum by (revision) (rate(checkout_requests_total{status=~"5.."}[5m]))
/
sum by (revision) (rate(checkout_requests_total[5m]))
Уточните, существуют ли эти метки в вашей системе и включает ли знаменатель нужные статусы. Нулевая нагрузка требует отдельной обработки; пустая серия не должна автоматически превращаться в здоровый ноль. Метка revision должна действительно отражать обслужившую запрос версию, а не значение, добавленное позднее без связи с экземпляром.
В учебном примере счётчик был 980, затем перезапустился, а после нового старта достиг 120. Простое вычитание даёт −860. Если отдельно известно, что до сброса добавилось двадцать событий, а после — сто двадцать, итог равен 140. Это проверка заданной арифметики; редкие реальные измерения могут не позволить точно восстановить все события.
Как обсуждать задержку без выдуманного p95
В пакете известно число ответов быстрее 500 мс: 980, 400 и 970. Поэтому можно сравнить доли 98%, 40% и 97%. Нельзя получить точный p95 только из этой границы. Не подписывайте график «p95 восстановился»: в пакете известна только доля ответов быстрее 500 мс. Убедительное объяснение сохраняет название того, что действительно измерено.
Официальное руководство Prometheus по гистограммам объясняет различие между гистограммами и summary, включая ограничения агрегации квантилей. Для упражнения достаточно одного практического следствия: не усредняйте готовые p95 разных Pod, чтобы объявить p95 всего сервиса. Запрос, границы bucket и распределение нагрузки должны соответствовать поставленному вопросу.
Спросите, входят ли ошибки в измерение длительности и что происходит с тайм-аутами. Если самые медленные запросы исключаются, красивый график успешных ответов может сосуществовать с ухудшением опыта пользователя. В нашем пакете быстрые ответы и 5xx — разные сигналы с одним заданным знаменателем; их совместный просмотр полезнее единственной линии задержки.
Когда предложить откат
Предложение должно содержать условие, действие и критерий остановки. Например: «Если r41 совместима с текущей схемой данных, артефакт доступен, а r42 продолжает давать 8% ошибок, предлагаю вернуть трафик на r41 по принятой процедуре, наблюдая те же сигналы». Это условный ответ для кейса; фактического отката здесь не выполнялось.
В пакете специально задано, что схема совместима, нового формата записей нет, а предыдущий артефакт известен. В настоящем инциденте это нужно проверить. Откат приложения не отменяет уже совершённые внешние действия, миграцию данных или изменение конфигурации другого сервиса. Если возврат создаёт больший риск, рассмотрите ограничение проблемной функции или направленное исправление и объясните цену выбора.
Согласно официальному описанию Deployment, превышение progress deadline отражается условием ProgressDeadlineExceeded; контроллер не выполняет автоматический откат только из-за этого статуса. Не обещайте автоматическое восстановление без проверки вашей системы доставки. Статус rollout и доля успешных покупок также измеряют разные вещи.
Назовите ответственного за решение и наблюдение, если в задаче участвует команда. Одновременные несогласованные изменения мешают понять результат и могут усилить сбой. В ответе достаточно обозначить журнал действий, одну согласованную гипотезу на проверку и понятный способ остановить неудачную попытку. Не придумывайте универсальную корпоративную цепочку согласований.
Как доказать восстановление и не объявить причину
В третьем окне ошибки снизились до 3/1000, быстрые ответы выросли до 97%, очередь стала нулевой. Это согласуется с восстановлением выбранных показателей после возврата r41. Числа не доказывают, что устранена утечка: могла измениться нагрузка, закончиться блокировка или восстановиться зависимость. Такую неопределённость следует сохранить в отчёте.
Проверьте, сопоставимы ли маршрут, регион, объём и состав запросов. Отдельно посмотрите зависшие операции, повторные попытки и очередь фоновой обработки. Зелёное окно после остановки всего трафика не является восстановлением обслуживания. Если данных недостаточно, сформулируйте, какое дополнительное окно или независимый сигнал нужен, вместо выдуманного срока «пять минут всегда достаточно».
Для окончательной причины потребуется воспроизведение механизма или достаточно сильная совокупность доказательств. Например, сравнение путей освобождения соединений и контролируемый тест может проверить гипотезу удержания. Такой эксперимент здесь не проводился. Отличайте временное снижение ущерба, подтверждение восстановления и анализ причины: они могут завершиться в разные моменты.
Как отвечать, если данных для решения не хватает
Если собеседник не даёт длительность владения соединением, попросите один конкретный срез: число занятых соединений и время их возврата по ревизии за сопоставимое окно. Объясните развилку заранее. Если у r42 соединения остаются занятыми после завершения запросов, усилится гипотеза ошибки освобождения. Если время владения растёт вместе с длительностью SQL у обеих ревизий, сначала исследуйте базу. Это ещё не автоматический диагноз, но следующий шаг уже способен изменить выбор.
Если дополнительный сбор дорогой, оцените его влияние и доступную безопасную альтернативу. Не включайте подробное логирование всех запросов без ограничения объёма и проверки состава данных. Для учебного ответа можно предложить краткий ограниченный срез по уже существующим безопасным идентификаторам. Скажите, кто наблюдает ошибки во время проверки и какое ухудшение заставит её остановить.
Отдельно назовите то, что не будете ждать перед снижением ущерба: окончательного посмертного анализа при продолжающемся нарушении обслуживания. При проверенной совместимости возврат версии может быть разумной временной мерой до установления причины. Решение остаётся условным: если совместимость неизвестна, сначала нужна эта проверка. Такой ответ показывает управление неопределённостью без притворной уверенности и без бесконечного сбора метрик ради самих метрик.
Что проверено локально
Пакет содержит incident-packet.json и Python-скрипт с двенадцатью проверками. Он воспроизводит три доли ошибок, три доли быстрых ответов, заполнение пула, агрегат 4,1%, значение после восстановления, отрицательное простое вычитание, известные приращения после сброса и порядок событий c17. Все двенадцать проверок прошли в Python 3.12.14; результат сохранён отдельно от исходного пакета.
Ни одна из них не запускала кластер, PromQL, реальную базу или нагрузочный генератор. Проверка чисел помогает исключить ошибку учебного ответа, но не подтверждает эксплуатационную безопасность предлагаемого действия. Для практики измените знаменатель r42 или уберите связь request_id и объясните, какие выводы придётся ослабить. Не сохраняйте прежнюю уверенность после удаления доказательства.
Пять вопросов для тренировки следующего шага
Эти страницы проверены как доступные вопросы PracHub. Их формулировки английские; русскоязычный разбор выше помогает подготовить ход рассуждения. Набор отличается от соседнего общего DevOps-руководства и выбран для диагностики, связи сигналов и проверки гипотез, а не для заучивания названий инструментов.
| Вопрос PracHub | Что обосновать в ответе |
|---|---|
| Triage a Suddenly Slow Production Service | Какой пользовательский сигнал и следующий тест определяют действие |
| Cloud Connection Issue Triage | Какие наблюдения различают DNS, соединение и прикладное ожидание |
| Diagnose overloaded Kubernetes cluster | Почему средняя загрузка недостаточна без лимитов и распределения |
| Diagnose why a scaled system became slow | Как рост реплик меняет общий спрос на ограниченный ресурс |
| Debug a cache incident end-to-end | Как связать симптом, проверку, временное восстановление и причину |
Закончите тренировку коротким ответом на Triage a Suddenly Slow Production Service: что наблюдаете, что предполагаете, чем опровергнете предположение и при каком условии измените систему. Сильный результат — решение, границы которого другой инженер способен проверить по тому же пакету.
Comments (0)