Entretien technique Data Engineer : concevoir un pipeline et gérer les reprises
Quick Overview
Exercice original de pipeline Data Engineer en français : fichiers snapshots révisés, identité de fichier/événement/tentative, intervalle UTC et données tardives. SQLite staging/contributions/total/manifeste dans une transaction,28vérifications CPython3.12.14/SQLite3.53.4, deuxexceptions avantcommit etconnexionréouverte. SQLROW_NUMBER etchronologie300/350/370/380/180; pasAirflow/PostgreSQL/transactiondistribuée/concurrence/crashbrutal exécutés.
Pour préparer un entretien technique Data Engineer, entraînez-vous à expliquer le résultat attendu après un replay, un fichier tardif et une correction. Précisez l’identité des données, l’intervalle traité et les écritures validées ensemble : votre interlocuteur pourra alors vérifier le pipeline sur un petit exemple.
Nous allons traiter des fichiers de commandes révisables. Le piège est double : une nouvelle tentative ne représente pas de nouveaux événements, et une nouvelle version de fichier ne doit pas simplement s’ajouter à l’ancienne. Pour élargir la pratique, utilisez les questions Data Engineer de PracHub avec ces mêmes contraintes.
Preuves et limites : les sources officielles étayent les mécanismes cités. Les données, les identifiants et la chronologie sont un exercice original fictif. Le laboratoire exécute Python et SQLite localement ; les questions rapportées du PracHub ne prédisent ni une prochaine épreuve ni le processus d’une entreprise.
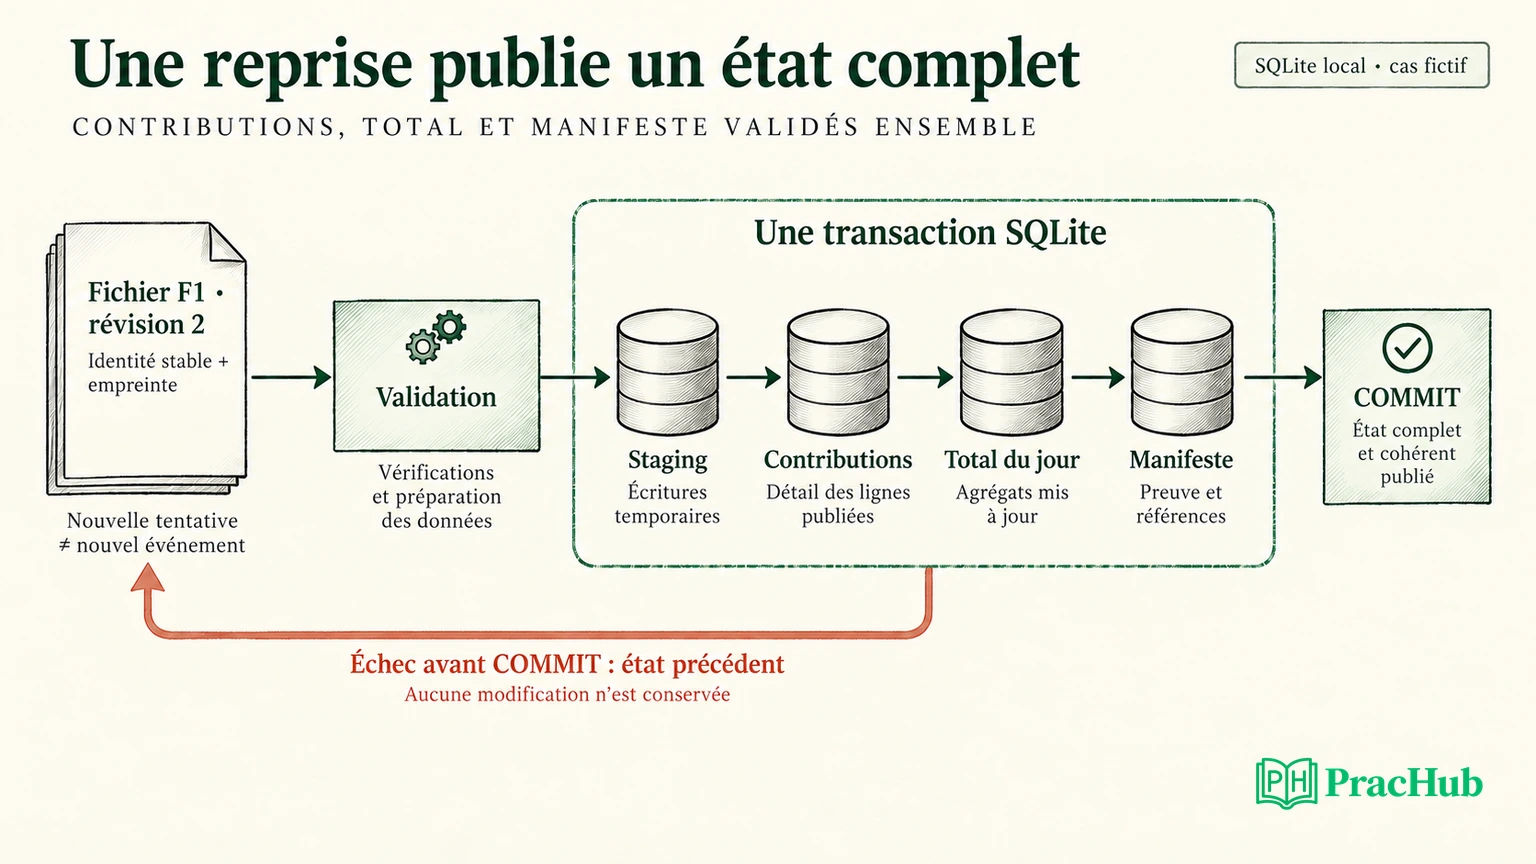
Fixez le grain et le contrat de correction
Le résultat demandé est un total en centimes par jour UTC, calculé à partir de l’état courant de chaque événement. Un événement possède un identifiant stable, une version positive, un instant et un montant entier non négatif. Dans ce cas, ses versions conservent le même jour : déplacer un événement entre partitions nécessiterait un autre contrat.
Un fichier logique conserve lui aussi son identité et son jour. Sa révision supérieure représente un snapshot complet : elle remplace toutes ses contributions précédentes. Un delta, au contraire, demanderait de distinguer insertion, modification et suppression. Confondre ces deux formats peut conserver des lignes retirées ou effacer des lignes encore valides.
Demandez donc qui produit les versions et ce que signifie une ligne absente. Ici, l’absence retire seulement la contribution de ce fichier. Elle n’efface pas globalement un événement encore présent dans un autre fichier. Nous ne modélisons pas un journal CDC avec tombstones, ni un système de paiement réel.
Cette précision choisit déjà une architecture : nous conservons l’origine de chaque contribution avant de construire le résultat. Une table contenant seulement le dernier total ne suffit pas à expliquer quelle partie doit être remplacée lorsqu’un fichier est corrigé.
Séparez fichier, événement et tentative
L’identité logique F1 désigne ici source/A/2026-08-01/part-1. Sa révision 1 contient e1 à 100 centimes et e2 à 200. Une seconde tentative du même fichier doit conserver le total de 300. Générer un nouvel identifiant métier à chaque retry ferait compter 600.
Le manifeste enregistre l’identité du fichier, sa révision, son jour et une empreinte SHA256 de sa représentation JSON canonique. L’identifiant de tentative reste une information opérationnelle : il ne modifie pas cette empreinte. Il faut distinguer cette représentation du laboratoire des octets d’un véritable objet CSV ou Parquet.
Notre politique est explicite : une révision de fichier inférieure est ignorée ; une révision identique avec empreinte identique est un replay ; une révision identique avec contenu différent est rejetée. Pour les événements, une même identité et une même version exigent le même instant et le même montant.
Deux fichiers peuvent contenir le même événement. Nous gardons leurs contributions séparées, puis retenons une seule fois la version d’événement la plus élevée. Une contrainte unique sur le nom du fichier ne résout donc pas la déduplication métier, et une contrainte sur l’événement seul ne conserve pas nécessairement sa provenance.
Délimitez l’intervalle indépendamment de l’arrivée
Fait officiel : la documentation des Dag Runs d’Airflow distingue l’intervalle de données associé à une exécution de l’instant où elle tourne. La date logique représente le début de cet intervalle dans les cas décrits. Ce vocabulaire aide à poser un périmètre reproductible ; il ne prouve pas que notre code a été exécuté dans Airflow.
Notre journée est l’intervalle demi-ouvert [2026-08-01T00:00:00Z, 2026-08-02T00:00:00Z). L’événement e3, à 23:59:59 le 1er août, appartient à cette journée même si le fichier F2 est présenté comme arrivé le 3 août. Le total passe de 300 à 350. La date d’arrivée sert au suivi du retard, pas au choix du jour métier.
À l’inverse, un événement de 40 centimes à minuit le 2 août appartient au lendemain. Le laboratoire rejette sa présence dans un fichier déclaré pour le 1er août, puis l’accepte dans le bon intervalle. Accepter silencieusement le mauvais jour pourrait préserver un total global tout en faussant les deux partitions.
La documentation Airflow sur les bonnes pratiques recommande des entrées et sorties liées à des partitions précises et des tâches capables de produire le même résultat lors d’une reprise. Application à notre exercice : fixer les révisions d’entrée et les règles de transformation, plutôt que lire un chemin « latest » dont le contenu change entre deux tentatives.
Remplacez une contribution, puis réconciliez
Après F2, nous avons trois événements et un total de 350. F1 révision 2 corrige e1 : sa version 2 vaut maintenant 120. Le fichier conserve e2 à 200. Le résultat devient 370, car l’ancien montant de e1 est remplacé ; ajouter tout le fichier corrigé produirait un résultat faux.
Le code charge un staging temporaire, vérifie les conflits, retire les contributions de F1 et insère son nouveau snapshot. Il reconstruit ensuite le total du jour en classant les contributions par identité d’événement et version décroissante. Les lignes de F2 restent présentes ; lorsque F3 arrive, leur provenance reste distincte de celle de F1. Voici le calcul utilisé, avec le jour fourni comme paramètre :
WITH ranked AS (
  SELECT event_id, event_time, amount,
         ROW_NUMBER() OVER (
           PARTITION BY event_id ORDER BY event_rev DESC, file_id
         ) AS rn
  FROM contributions
)
SELECT COALESCE(SUM(amount), 0), COUNT(*)
FROM ranked
WHERE rn = 1 AND substr(event_time, 1, 10) = ?;
La documentation officielle de SQLite sur ROW_NUMBER décrit la numérotation des lignes dans chaque partition définie par la fenêtre. Ici, cette partition est l’identité d’événement ; le filtre de jour intervient après le choix de sa version.
Lorsque F3 apporte aussi e1 version 2 à 120, le total reste 370. Il existe alors quatre contributions brutes, trois événements distincts et trois fichiers dans le manifeste. Ces trois dénominateurs répondent à des questions différentes : provenance, résultat métier et progression des livraisons.
Mécanisme officiel : SQLite documente UPSERT comme un traitement des conflits de contrainte d’unicité. Notre programme l’utilise pour remplacer le total et le manifeste. Cela ne choisit pas à notre place la bonne identité, la politique des versions ou le comportement face à un snapshot incomplet.
Le fichier ancien F1 révision 1, reçu ensuite, est ignoré. Le laboratoire vérifie aussi le rejet d’un montant contradictoire pour une identité et une version d’événement déjà acceptées. Ces branches empêchent de confondre une arrivée désordonnée, une correction autorisée et une divergence de contenu.
Publiez le manifeste avec le résultat
Un manifeste est ici la table qui indique quelle révision de chaque fichier a été publiée. S’il annonce « traité » avant les données, une reprise peut sauter un travail incomplet. S’il reste en retard après une publication, le fichier peut revenir ; la reprise doit alors reconnaître ce qui a déjà été accepté.
Fait officiel : les transactions PostgreSQL regroupent des opérations avec une validation ou une annulation. Le laboratoire applique cette idée dans une transaction SQLite, dont les règles de transaction doivent être considérées séparément ; nous n’avons pas testé PostgreSQL.
Dans le programme, la lecture du manifeste, le staging SQL, le remplacement des contributions, le total du jour et le manifeste sont dans la même transaction. La validation initiale des champs Python précède cette transaction. Nous injectons deux exceptions : après le remplacement des lignes, puis après l’écriture du manifeste mais avant le commit.
Dans les deux cas, l’état métier et le manifeste restent identiques à l’état précédent. La révision publiée demeure 2 et le total demeure 370. Après fermeture et réouverture de la connexion, ces valeurs sont encore lues. Ce test ferme puis rouvre une connexion ; il ne redémarre pas un processus et ne simule ni coupure électrique ni arrêt brutal. Le gestionnaire de transaction Python annule les écritures lors de nos exceptions.
Prévoyez les sorties avant de relancer
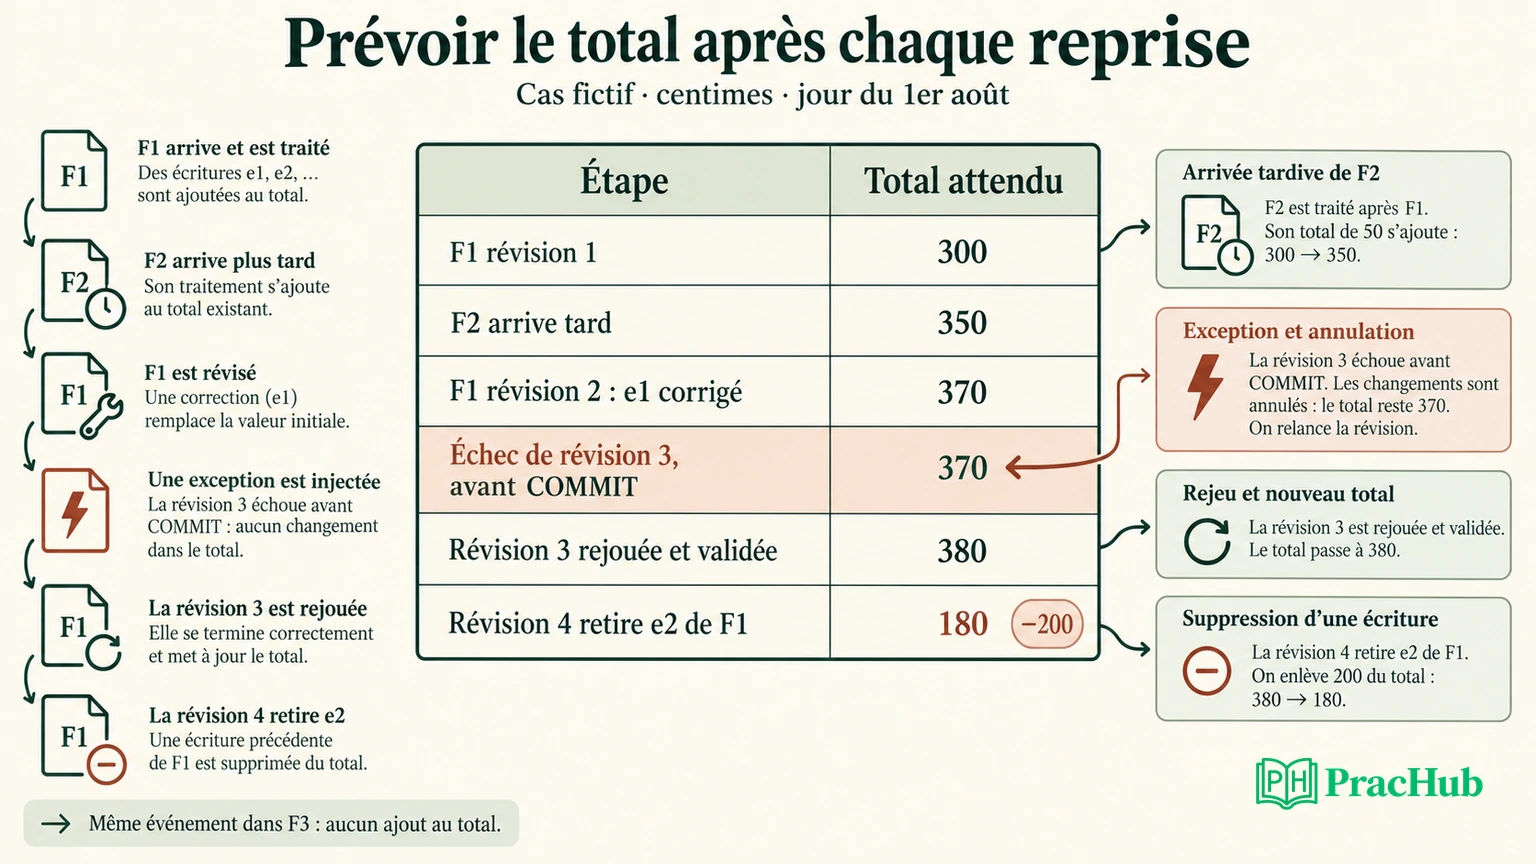
La révision 3 de F1 augmente e1 à 130 tout en conservant e2. Après une tentative validée, le total devient 380. Une quatrième révision retire e2 du snapshot F1 : il reste e1 à 130 et l’événement tardif à 50, soit 180. F3 contient encore une ancienne version de e1, qui ne remplace pas la version 3.
| Étape du dossier fictif | Total du 1er août | Ce que cela vérifie |
|---|---|---|
| F1 initial, puis même fichier rejoué | 300 puis 300 | Tentative distincte, résultat stable |
| F2 tardif | 350 | Partition choisie par l’événement |
F1 corrigé, puis copie de e1 dans F3 | 370 puis 370 | Révision et déduplication métier |
| Deux exceptions avant commit | 370 | Résultat et manifeste annulés ensemble |
| Reprise de la révision 3 | 380 | Correction effectivement publiée |
Révision 4 sans e2 | 180 | Remplacement du snapshot complet |
Le lendemain conserve 40 centimes après la révision 4 : la publication du 1er août ne doit pas effacer le résultat du 2. Une assertion sur le seul total général aurait pu laisser passer un déplacement erroné de 40 centimes entre les deux jours. Comparez les partitions, les événements distincts, les contributions et les révisions du manifeste.
Expliquez la frontière entre systèmes
Tout ce qui est publié par notre exercice réside dans une seule base. Si les données finales sont dans un object storage et le manifeste dans un autre service, la transaction SQLite ne les englobe plus. Une panne entre les deux écritures reste une possibilité du nouveau dessin.
Proposition de conception, non exécutée ici : préparer une sortie sous une identité de version immuable, la valider, puis publier une référence que les lecteurs savent interpréter. Il faut encore déterminer les garanties du mécanisme de publication, les droits de chaque écrivain et le nettoyage des sorties abandonnées. Nommer un dossier temporaire ne suffit pas à garantir une bascule atomique.
Ajoutez la concurrence à la discussion. Deux backfills peuvent viser la même partition avec des snapshots d’entrée différents. Demandez qui possède le droit de publier et comment une version ancienne est empêchée d’écraser une version récente. Notre test ouvre une connexion à la fois ; il ne valide pas un protocole entre workers concurrents.
Enfin, prévoyez la rétention. Conserver les contributions permet d’expliquer les corrections, mais consomme de l’espace. Les supprimer avant la fin de l’horizon de replay peut empêcher la déduplication ou la reconstruction attendue. Le délai acceptable dépend du consommateur, du contrat source et du coût de reprise.
Présentez les limites et une amélioration mesurable
Le laboratoire à télécharger contient le programme, les entrées JSON, la chronologie CSV, les résultats détaillés et le README. Exécutez python3 pipeline.py depuis son dossier. Les 28 vérifications ont réussi avec CPython 3.12.14 et SQLite 3.53.4, sur une base temporaire persistée le temps de l’exercice.
Les vérifications couvrent replay, retard, révision ancienne, conflits de contenu, minuit, remplacement complet, deux exceptions et réouverture de connexion. Elles ne mesurent pas un débit, ne lancent pas Airflow et ne traitent pas un million de documents. La requête de classement parcourt les contributions ; ce choix rend l’exemple lisible, mais son coût doit être analysé avant tout volume important.
En entretien, annoncez une amélioration accompagnée d’un contrôle : limiter le recalcul aux partitions concernées sans casser la déduplication, ou ajouter une version de transformation au manifeste. Chaque amélioration change une hypothèse. Dites quel test doit rester vrai et quelle nouvelle panne vous allez provoquer pour l’évaluer.
Entraînez une réponse qui résiste aux variantes
Les titres complets suivants ouvrent des questions rapportées pour la pratique. Ils permettent de varier sources, formats et exigences ; ils ne justifient pas les étapes actuelles d’un recrutement particulier.
| Question complète PracHub | Variante à ajouter |
|---|---|
| Choose Between Batch and Streaming for a Data Pipeline | Relier fraîcheur attendue et coût de reprise |
| Single-Pass Python Cleaning Pipeline for Million-Document Web Crawl Parquet Files | Séparer notre petit laboratoire du traitement volumineux |
| Implement Election Report and Banking Pipeline | Préciser grain et contrôles du résultat |
| Design a Conversation Log Ingestion Pipeline | Définir identité, retard et confidentialité |
| Design a chargeback ingestion and export system | Examiner la publication vers un système externe |
Commencez par une question Data Engineer sur PracHub, puis dessinez où chaque version devient visible. Faites ensuite changer une contrainte : fichier delta, révision contradictoire ou sortie externe. Expliquez à votre partenaire pourquoi le même total reste valide, ou quel résultat doit changer avec cette nouvelle contrainte.
Comments (0)