Entrevista backend: preguntas de bases de datos, concurrencia y fallos de producción
Quick Overview
Ejercicio original backend en español: un SKU/unaunidad, dos sesiones ReadCommitted y escrituraobsoleta que acepta2pedidos, condiciónUPDATE conesperaLockreal queacepta1.25comprobaciones PostgreSQL18.6/CPython3.12.14/psycopg3.3.6;55P03/25P02 yrollback, productoinexistentevsagotado, excepcióninyectadatrascommit yreplaysecuencial. NoHTTP/pago/caché/replica/APIidempotenteconcurrente/benchmark ejecutados.
En una entrevista backend, saber definir una transacción no basta para explicar por qué se vendieron dos unidades cuando solo quedaba una. La preparación útil conecta una regla de negocio, las escrituras que pueden romperla y la evidencia que distingue un fallo de otro. Empieza por un caso pequeño que puedas ejecutar y defender, antes de ampliar el diseño.
Este artículo propone un ejercicio original de inventario con PostgreSQL y preguntas para relacionarlo con una API y un incidente. Puedes acompañarlo con las preguntas de Backend Engineer en PracHub. Los comportamientos atribuidos a documentación oficial se enlazan al aparecer; los casos y recomendaciones son propuestas de práctica. No usamos testimonios de candidatos para afirmar rondas, duración, baremos ni preguntas futuras de una empresa.
Empieza por la regla que debe sobrevivir
Supón que un servicio recibe peticiones para comprar una unidad del producto S. Inicialmente hay una unidad, no existen cancelaciones ni reposiciones y cada pedido confirmado consume exactamente una unidad. En este caso, el stock restante más el número de pedidos aceptados debe seguir siendo uno. Esa igualdad hace visible una sobreventa que un contador no negativo puede ocultar.
Nuestro modelo tiene stock(sku, units) y orders(request_key, sku). La primera tabla usa sku como clave primaria y exige units >= 0; la segunda usa request_key como clave primaria y referencia stock.sku. El pedido y el descuento deben confirmarse juntos. Un fallo entre ambas escrituras no puede dejar un pedido aceptado sin descuento, ni descontar una unidad sin registrar el pedido.
Esta es una simplificación deliberada. No incluye cantidades variables, almacenes, reservas temporales ni pagos. Si aparece una de esas condiciones, revisa la regla antes de reutilizar el SQL. En una respuesta oral, preguntar qué significa «aceptado» y quién posee el inventario evita diseñar una garantía distinta de la que necesita el negocio.
Traza uno: dos sesiones leen la misma unidad
La documentación oficial de aislamiento de PostgreSQL explica que una consulta en Read Committed observa datos confirmados al comenzar esa consulta. Es el nivel que verificamos en las dos sesiones del laboratorio. Que dos lecturas devuelvan uno no significa que ambas peticiones puedan consumir esa unidad.
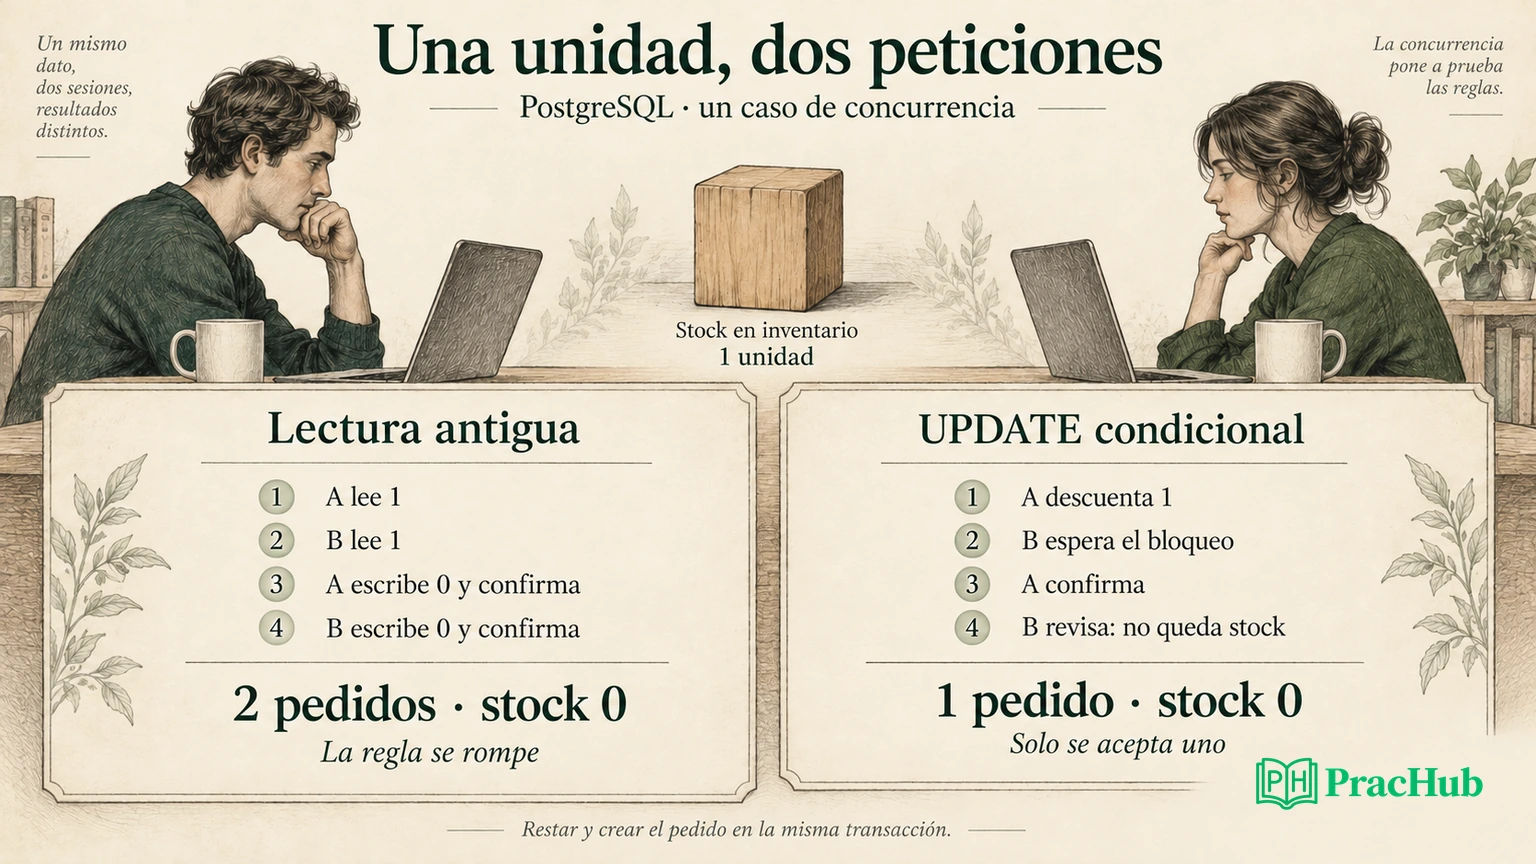
El fallo reproducido es concreto: A lee uno y B también lee uno. Cada aplicación calcula localmente 1 - 1. A escribe cero y registra su pedido; después B escribe también cero y registra otro. Las dos transacciones confirman. El resultado observado es stock cero y dos pedidos. La segunda escritura utiliza un valor calculado antes de la primera confirmación.
No lo llames lectura sucia: ninguna sesión necesitó leer cambios sin confirmar. Tampoco basta señalar que «faltaba una transacción», porque las dos operaciones ya estaban dentro de transacciones. El problema es que leer, decidir en la aplicación y escribir un valor absoluto no protegió la condición compartida. La restricción de stock no negativo también se cumple en el resultado incorrecto.
Explica qué prueba detecta el error. Comprobar solo units == 0 pasaría; contar los pedidos aceptados revela la segunda venta. Explica por qué tu prueba cuenta pedidos además de mirar el stock: así haces visible la regla de negocio que estás protegiendo.
Traza dos: decidir el descuento en la escritura
Para una unidad de un solo producto, nuestro arreglo propuesto es una actualización condicional. La referencia oficial de UPDATE describe la cláusula RETURNING, que permite recuperar las filas actualizadas. El laboratorio ejecuta esta sentencia con el producto como parámetro:
UPDATE stock
SET units = units - 1
WHERE sku = 'S' AND units >= 1
RETURNING units;
Si devuelve una fila, insertamos el pedido dentro de la misma transacción y confirmamos. Si no devuelve ninguna, no creamos el pedido. El valor se calcula sobre la fila que la base de datos actualiza, y la condición comprueba la disponibilidad en esa operación. No reutilizamos el uno leído previamente para escribir un cero absoluto.
El experimento mantiene sin confirmar la actualización de A mientras B intenta la misma sentencia. Consultamos pg_stat_activity y observamos una espera de tipo Lock para B antes de confirmar A. Después, B devuelve cero filas. El estado final es una unidad consumida y un pedido aceptado. El archivo de resultados conserva la espera Lock observada antes del COMMIT de A y las cero filas devueltas por B después.
La documentación de Read Committed describe la espera y la reevaluación de la condición cuando la otra transacción confirma una actualización de la fila. Esa regla explica el resultado, pero no convierte el ejemplo en una solución universal para varios productos o restricciones entre filas. Si una compra necesita dos recursos, debes definir el orden de adquisición y la atomicidad de ambos.
Cero filas no identifica una causa única
El laboratorio también ejecuta la sentencia para un producto inexistente y para S agotado. Ambas operaciones devuelven cero filas. Una consulta posterior distingue que S existe con cero unidades y que MISSING no existe. Por tanto, el número de filas actualizado no basta para decidir por sí solo el mensaje de la API. Si lo interpretas siempre como falta de stock, ocultarás también un identificador inexistente.
Define el contrato: ¿el cliente necesita distinguir «producto desconocido» de «sin disponibilidad»? ¿Puede conocer ese producto? Los códigos HTTP y el contenido del error serían decisiones del servicio, no resultados impuestos por PostgreSQL. Evita filtrar información de recursos a un cliente sin permiso solo para mejorar un mensaje de diagnóstico.
Una lectura adicional tampoco congela para siempre el estado observado. Podría llegar una reposición o una eliminación después de la escritura. En nuestro caso pequeño no existen esas operaciones; en un sistema que sí las permite, decide qué precisión temporal promete la respuesta y qué dato conservarás para explicar el rechazo.
Traza tres: separar dos clases de timeout
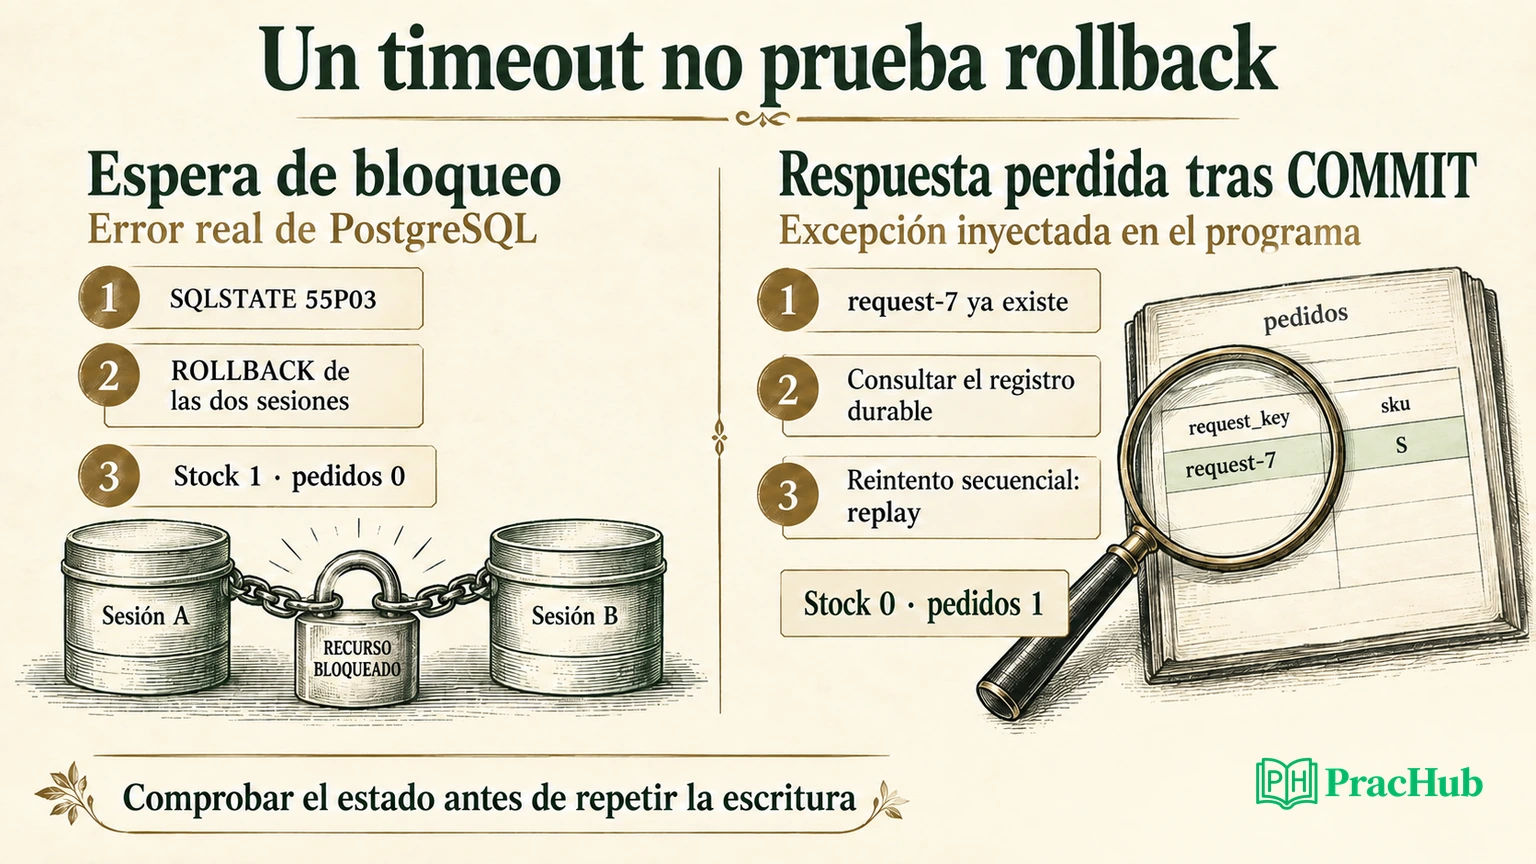
Primero provocamos una espera real de bloqueo. A mantiene la fila y B utiliza lock_timeout = '150ms'. B recibe SQLSTATE 55P03; una consulta posterior en esa transacción falla con 25P02 hasta hacer ROLLBACK. Tras deshacer ambas sesiones, el stock sigue siendo uno y no hay pedidos. Los 150 milisegundos son un valor de prueba, no una recomendación para producción.
La documentación oficial de bloqueos permite estudiar qué operaciones entran en conflicto y cuándo se liberan los bloqueos. Para nuestro diagnóstico importa identificar al bloqueador y cerrar la transacción correctamente. Aumentar el timeout sin investigar por qué una transacción permanece abierta podría prolongar el síntoma.
La segunda variante es distinta: el programa confirma el pedido request-7 y después inyecta una excepción TimeoutError antes de devolver el resultado. No es un timeout HTTP ni una caída de red real. La excepción ilustra la incertidumbre sobre el resultado; el ensayo no mide el comportamiento de un cliente HTTP, un proxy ni una red. La base de datos conserva el pedido aunque la función haya fallado después.
Consultamos el registro durable por esa clave y verificamos que existe. Un reintento secuencial con la misma clave devuelve replay, sin descontar otra unidad; reutilizarla para otro producto devuelve conflicto. Este fragmento no implementa una API idempotente completa para peticiones simultáneas con la misma clave. El experimento demuestra que podemos recuperar un pedido ya confirmado y que ese reintento secuencial no vuelve a descontar stock.
Elegir el siguiente dato durante un incidente
Google SRE identifica latencia, tráfico, errores y saturación como señales centrales de monitorización en su capítulo oficial sobre sistemas distribuidos. Nuestra recomendación de práctica es relacionar esas señales con una petición concreta. «La base de datos va lenta» no distingue una consulta costosa de una conexión esperando un bloqueo.
Usa las trazas del dossier como un incidente ficticio. Para cada una, pide una evidencia que cambie la siguiente acción. El objetivo no es adivinar un servicio culpable ni acumular logs. Mantén separados el síntoma observado, la explicación posible y la comprobación que falta.
| Evidencia del ejercicio | Hipótesis acotada | Siguiente comprobación |
|---|---|---|
| Stock cero y dos pedidos aceptados | Escritura desde una lectura antigua | Reconstruir las dos lecturas y escrituras, contando pedidos. |
B espera Lock mientras A sigue abierta | Contención sobre la fila de S | Identificar la sesión bloqueadora y su transacción. |
UPDATE devuelve cero filas | Producto agotado o inexistente | Verificar identidad y contrato de error. |
Excepción después de confirmar request-7 | Efecto realizado con respuesta no entregada | Consultar el resultado durable antes de repetir. |
En producción, correlacionarías la clave de operación con el identificador de petición y los eventos de inicio, confirmación y respuesta. Registra lo necesario para reconstruir el efecto sin volcar credenciales ni cuerpos sensibles. En este laboratorio las claves son sintéticas; el CSV contiene observaciones del ejercicio, no logs obtenidos de clientes.
Defender los límites de cada solución
Una actualización condicional protege esta fila y esta condición. No coordina un cobro externo, una publicación en una cola ni una caché. Si el siguiente requisito exige notificar un pedido confirmado, plantea cómo conservar la intención de publicación junto al pedido y cómo recuperarla. Es una ampliación de diseño que habría que implementar y probar, no una propiedad que nuestro SQL ya demuestre.
Un bloqueo en memoria tampoco sustituye automáticamente al control en la base de datos: puede proteger un proceso mientras otro proceso sigue escribiendo. Para comparar alternativas, indica qué actores comparten el recurso, cuántas filas participan y cuánto tiempo se mantendría el bloqueo. Así puedes justificar cuándo una sentencia basta y cuándo estudiar un bloqueo explícito o una transacción más amplia.
La guía oficial de AWS sobre timeouts, reintentos y backoff con jitter explica riesgos de amplificar carga mediante reintentos. Nuestra aplicación al caso es limitar los intentos y decidir qué efecto es seguro repetir. Un rechazo por falta de stock no se arregla repitiéndolo inmediatamente; un fallo de bloqueo puede necesitar rollback, nuevo intento acotado y una investigación de la contención.
No prometas que añadir un índice elimina esta carrera. La clave primaria ya localiza S, y el conflicto sigue existiendo porque dos peticiones desean la misma unidad. Un plan de consulta responde a otra pregunta: cuánto trabajo hace la consulta para encontrar filas. La duración de la transacción y la popularidad del producto pueden importar aunque el acceso sea eficiente.
Practicar preguntas con una comprobación observable
Estas cinco preguntas PracHub son material de práctica registrado, no una predicción de tu evaluación. Úsalas para ampliar el caso hacia granularidad de bloqueos, anomalías e identidad de operaciones. Antes de leer una solución, escribe qué intercalado permitiría refutar tu primera respuesta.
| Pregunta PracHub | Relación con el ejercicio |
|---|---|
| Choose lock granularity for concurrent storage | Explicar qué recurso queda protegido y qué peticiones esperan. |
| Improve concurrency beyond a single lock | Comparar un bloqueo global con productos independientes. |
| Classify concurrency anomaly between two transactions | Nombrar la anomalía después de reconstruir lecturas y escrituras. |
| Reason About Indexes, Kafka, and Database Locking | Separar acceso a filas, contención y publicación externa. |
| Design concurrency-safe shared payment account API | Revisar identidad, concurrencia y efectos que no pueden duplicarse. |
Para ensayar la explicación, empieza con la unidad inicial y termina con un resultado que pueda comprobarse. Pide a otra persona que cambie una condición: dos unidades por pedido, dos productos o dos reintentos simultáneos. Indica qué parte de tu prueba sigue siendo válida y cuál requiere otro mecanismo. Cuando tu compañero añade dos productos, localiza con él el primer paso para el que ya no basta la prueba sobre S.
Ejecutar el dossier y describir lo que prueba
El laboratorio descargable incluye código, esquema, resultados y trazas. La ejecución registrada usa PostgreSQL 18.6, CPython 3.12.14 y psycopg 3.3.6 en un clúster local desechable, por socket Unix privado y sin escucha TCP. Pasan 25 comprobaciones, incluida la espera de bloqueo real. No es una prueba de rendimiento, una API desplegada ni una simulación de pagos.
Conserva los resultados esperados junto a la explicación del fallo. El README indica cómo levantar y detener un clúster de práctica separado. Si cambias el aislamiento o el número de recursos, vuelve a ejecutar las pruebas correspondientes; no atribuyas automáticamente al nuevo diseño las garantías observadas con una sola fila.
Continúa con las preguntas de Backend Engineer en PracHub: elige una, dibuja dos peticiones y escribe el estado que queda después de cada confirmación. Si no puedes distinguir una espera, un rechazo y un efecto confirmado, ya tienes un objetivo concreto para la siguiente sesión de práctica.
Comments (0)