SQL面接の問題:重複・NULL・期間条件をデータで確かめる
Quick Overview
SQL面接を、二つのテナントと五件の契約の独自データで練習します。配送とイベントの重複、JSTの期間境界、最新状態を選ぶ順序、複合キー、状態不明とイベントなしを比較。PostgreSQL 18.6の27項目の検証と期待する結果表で、クエリの意味を説明します。
SQL面接の問題で、クエリが実行できても、結果の一行が契約なのかイベントなのか曖昧だと、どの行を残すべきか判断しづらくなります。配送の重複を消したつもりなのに契約を落とす。LEFT JOINを使ったのに、イベントのない契約が消える。日時を指定したのに、日本時間の境界で件数が変わる。こうした違いは、小さなデータと期待する結果表で確かめられます。
この記事では、二つのテナントにある五件の契約を使い、日本時間の基準時刻より前に発生したイベントの最新状態を求めます。先に一行の粒度、イベントの識別方法、時刻の条件を決め、結果が変わる誤ったクエリと比較します。
根拠の区分: JOIN、NULL、ウィンドウ関数、日時型の説明はPostgreSQL公式資料に基づきます。契約とイベントは独自の合成データで、実行結果はPostgreSQL 18.6で確認しました。面接での説明方法はこのケースから導いた提案です。特定企業の出題内容や採点を示す候補者報告は使用していません。他のSQLエンジンでは日時リテラルや集計構文などを確認して移植してください。
何を一行として数える問題なのか
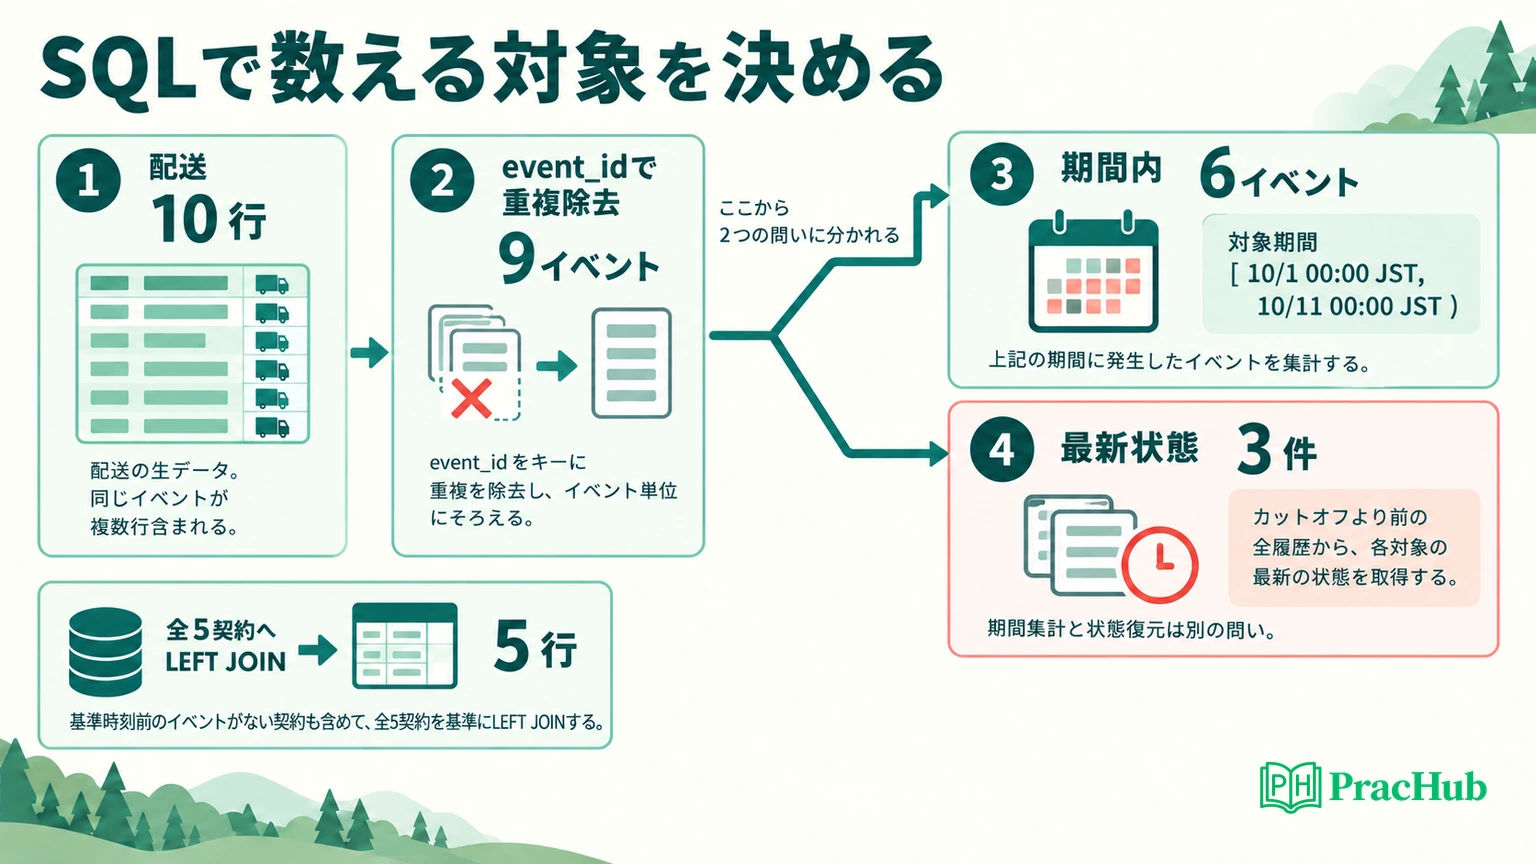
独自ケースの問いは二つあります。一つは、日本時間10月1日0時から10月11日0時までに発生したイベント数。もう一つは、10月11日0時より前の最新イベントから読める各契約の状態です。前者はイベント単位、後者は契約単位なので、同じ件数にはなりません。
ここでの「状態」は、入力された履歴から読める状態です。実際の課金権限、有料会員数、解約率を算出しているわけではありません。イベントの欠落や遅延があれば実際の状態と異なり得るため、「観察した履歴の範囲」として説明します。
契約のキーはtenantとsub_idの組です。Aの契約7とBの契約7は別の契約として扱います。event_idはこのケースでは全テナントを通じて一意の論理イベントを表し、delivery_idは届いた一行を表します。同じイベントが再配送されると、配送行だけが増えます。
最新状態の比較はoccurred_atを基準にします。配送時刻received_atは、同一イベントの代表行を選ぶときに使います。両方を「日時」と呼んで混ぜると、後で届いた古いイベントが最新状態として選ばれる可能性があります。
この問いは、現在手元にある履歴を発生時刻で振り返るものです。基準時刻の当時に受信済みだった情報だけを復元する条件は入れていません。後から届いた過去のイベントも対象になり得ます。当時のレポートを再現する問いなら、受信時刻の上限や保存したスナップショットも検討します。
小さなデータをそのまま実行する
次のデータを同じセッションへ読み込みます。stateのNULLは、イベントは存在するものの状態が不明、という練習上の意味です。イベントがないこととは区別します。契約の履歴は、以下に示したものがすべてという前提です。
CREATE TEMP TABLE subscriptions (
  tenant text NOT NULL,
  sub_id int NOT NULL,
  PRIMARY KEY (tenant, sub_id)
);
CREATE TEMP TABLE deliveries (
  delivery_id int PRIMARY KEY,
  event_id text NOT NULL,
  tenant text NOT NULL,
  sub_id int NOT NULL,
  occurred_at timestamptz NOT NULL,
  state text,
  received_at timestamptz NOT NULL
);
INSERT INTO subscriptions VALUES
  ('A',7),('A',8),('A',9),('B',7),('B',8);
INSERT INTO deliveries VALUES
  (1,'e1','A',7,'2026-09-30 15:00+00','active',
     '2026-09-30 15:01+00'),
  (2,'e1','A',7,'2026-09-30 15:00+00','active',
     '2026-10-02 00:00+00'),
  (3,'e2','A',7,'2026-10-10 15:00+00','cancelled',
     '2026-10-10 15:01+00'),
  (4,'e3','A',8,'2026-10-02 00:00+00','active',
     '2026-10-02 00:01+00'),
  (5,'e4','A',8,'2026-10-09 00:00+00',NULL,
     '2026-10-09 00:01+00'),
  (6,'e5','B',7,'2026-10-03 00:00+00','active',
     '2026-10-03 00:01+00'),
  (7,'e6','B',7,'2026-10-08 00:00+00','cancelled',
     '2026-10-08 00:01+00'),
  (8,'e7','B',7,'2026-10-09 00:00+00','active',
     '2026-10-09 00:01+00'),
  (9,'e8','B',8,'2026-10-11 00:00+00','active',
     '2026-10-11 00:01+00'),
  (10,'e9','A',7,'2026-10-11 01:00+00','active',
      '2026-10-11 01:01+00');
実行前の確認点は、10配送行にe1が二回あること、A/8の最新イベントe4は状態不明であること、A/9にはイベントがないことです。B/8にはイベントがありますが、今回の基準時刻より後です。A/7の取消e2は、ちょうど基準時刻に一致します。
再配送を除く前にイベントIDの契約を確認する
このケースのe1は、配送IDと受信時刻だけが異なり、契約、発生時刻、状態は同じです。論理イベント単位へそろえるため、イベントIDごとに代表行を一つ残します。
CREATE TEMP VIEW events AS
SELECT event_id, tenant, sub_id, occurred_at, state
FROM (
  SELECT d.*,
         row_number() OVER (
           PARTITION BY event_id
           ORDER BY received_at, delivery_id
         ) AS delivery_rank
  FROM deliveries d
) x
WHERE delivery_rank = 1;
公式仕様: row_number()は、ウィンドウ内の行へ順番に番号を付けます。PostgreSQLのウィンドウ関数資料を参照できます。本例で受信時刻の後に配送IDを指定したのは、同じ受信時刻でも代表行を一つに決めるためです。
ローカル検証結果: deliveriesは10行、eventsは9行になりました。さらに、同じ内容のe1配送を一行追加しても、論理イベント数は9のままでした。これは、入力に同じイベントが増えた場合の集計側の性質を確認したものです。
もし同じイベントIDで状態や契約が食い違ったら、このクエリは早い配送を残すだけです。内容の衝突を解決する仕様ではありません。面接では「同じIDの再配送は同一内容という契約ですか」と確認し、食い違いを検出して調査対象へ分ける処理を別に検討します。イベントIDがテナント内でだけ一意なら、重複除去のキーにもテナントが必要です。
単にSELECT DISTINCT *を使うと、配送IDや受信時刻が違う二行は残ります。反対に、状態だけで重複を除くと、別の契約のactiveまで同じ扱いになります。何を同一とみなすかを、列の集合として先に言えると、重複除去の理由を説明できます。
日本時間の期間を半開区間にする
日本時間10月11日0時は、UTCでは10月10日15時です。今回は期間の開始を含め、終了を含めない条件にします。
SELECT event_id
FROM events
WHERE occurred_at >= TIMESTAMPTZ '2026-10-01 00:00+09'
  AND occurred_at <  TIMESTAMPTZ '2026-10-11 00:00+09'
ORDER BY event_id;
e1
e3
e4
e5
e6
e7
ローカル検証結果: 期間内の論理イベントは6件です。同じ条件を配送表へ直接かけると、e1の再配送を含み7行になります。e2は終了時刻と等しいため除外され、次の期間の開始時刻として扱えます。
公式仕様: timestamptzは時差を含む入力を時点として扱い、表示はセッションのタイムゾーンに影響されます。日時型の公式資料が根拠です。本例は比較用リテラルにも時差を明示しており、セッションをAsia/Tokyoへ変えても、この基準時刻での状態表は変わりませんでした。
BETWEENは両端を含むため、同じ二つの時刻を渡すとe2も入り7イベントになります。秒の末尾を手で「23:59:59」へ書き換えるより、次の期間の開始を上限にして<で比較する方が、時刻の精度を変えても境界を説明しやすくなります。これはこのケースで採用した期間設計です。
期間内イベント数と基準時刻時点の状態は別の問いです。もし開始時刻より前にactiveになり、その後変更がない契約を追加したら、期間内イベントは0件でも、基準時刻前の最新状態はactiveです。期間内の変更だけを読むと、この契約を状態表から落としてしまいます。状態復元に期間の下限を無条件に持ち込むと、その履歴を失います。
最新を選ぶ前に基準時刻を適用する
最新状態は、基準時刻より前の履歴すべてを対象に、契約ごとに一件を選びます。期間内イベントを数える条件のうち、ここでは上限だけを使います。
CREATE TEMP VIEW ranked_before AS
SELECT e.*,
       row_number() OVER (
         PARTITION BY tenant, sub_id
         ORDER BY occurred_at DESC, event_id DESC
       ) AS state_rank
FROM events e
WHERE occurred_at < TIMESTAMPTZ '2026-10-11 00:00+09';

CREATE TEMP VIEW latest_before AS
SELECT *
FROM ranked_before
WHERE state_rank = 1;
ローカル検証結果: 最新イベントはA/7のe1、A/8のe4、B/7のe7の三件です。B/7は取消e6の後にactiveのe7があるため、最新の観察状態はactiveになります。A/7の取消e2は基準時刻ちょうどなので、まだ対象に入りません。
同じ発生時刻のイベントがある場合、このSQLはイベントIDの降順で一件を決めます。再現可能な順序ではありますが、実際の業務上の更新順を保証する規則ではありません。イベントIDの文字順が更新順だという証拠は、この入力にはありません。この合成データには同一契約・同一時刻で競合する状態はありません。実際の仕様なら、発行元の連番や優先順位などを確認します。
順番を逆にして、全履歴から最新を選んだ後で基準時刻をかけると、結果が変わります。
WITH ranked_all AS (
  SELECT e.*,
         row_number() OVER (
           PARTITION BY tenant, sub_id
           ORDER BY occurred_at DESC, event_id DESC
         ) AS rn
  FROM events e
)
SELECT tenant, sub_id, event_id
FROM ranked_all
WHERE rn = 1
  AND occurred_at < TIMESTAMPTZ '2026-10-11 00:00+09'
ORDER BY tenant, sub_id;
A | 8 | e4
B | 7 | e7
A/7は未来のe9が一位になり、その一行を後で除外するため、過去のe1へ戻れません。「基準時刻より前の最新」と「全体の最新が基準時刻より前なら残す」は別の条件です。実行結果を二行に並べると、句の順番だけでなく、問いの違いとして説明できます。
複合キーを省くと別テナントの状態が混ざる
五件の契約をすべて残すには、契約表を左側に置き、最新イベントを契約の完全なキーで結合します。
CREATE TEMP VIEW subscription_states AS
SELECT s.tenant, s.sub_id, e.event_id, e.state
FROM subscriptions s
LEFT JOIN latest_before e
  ON s.tenant = e.tenant
 AND s.sub_id = e.sub_id;

SELECT * FROM subscription_states
ORDER BY tenant, sub_id;
| tenant | sub_id | event_id | state |
|---|---|---|---|
| A | 7 | e1 | active |
| A | 8 | e4 | NULL |
| A | 9 | NULL | NULL |
| B | 7 | e7 | active |
| B | 8 | NULL | NULL |
公式仕様: LEFT JOINは一致する右側の行を組み合わせ、一致がない左側の行も右側をNULLとして残します。テーブル式の公式資料で確認できます。
ローカル検証結果: 結合条件をON s.sub_id = e.sub_idだけにすると、結果は五行から七行へ増えました。A/7にB/7のe7、B/7にA/7のe1、B/8にA/8のe4が誤って結びつきます。件数が増えるだけでなく、B/8には本来基準時刻前にない状態が付いてしまいます。
ここで最後にDISTINCTを付けても、間違った結合の意味は直りません。違うイベントIDや状態が付いた行は残り得ますし、列を減らして見かけの重複を消すと、誤った対応関係を隠します。まず「一つの契約に、最大何行の最新イベントが対応するか」を確認し、そのキーで結びます。
NULLが状態不明なのか、結合相手なしなのか
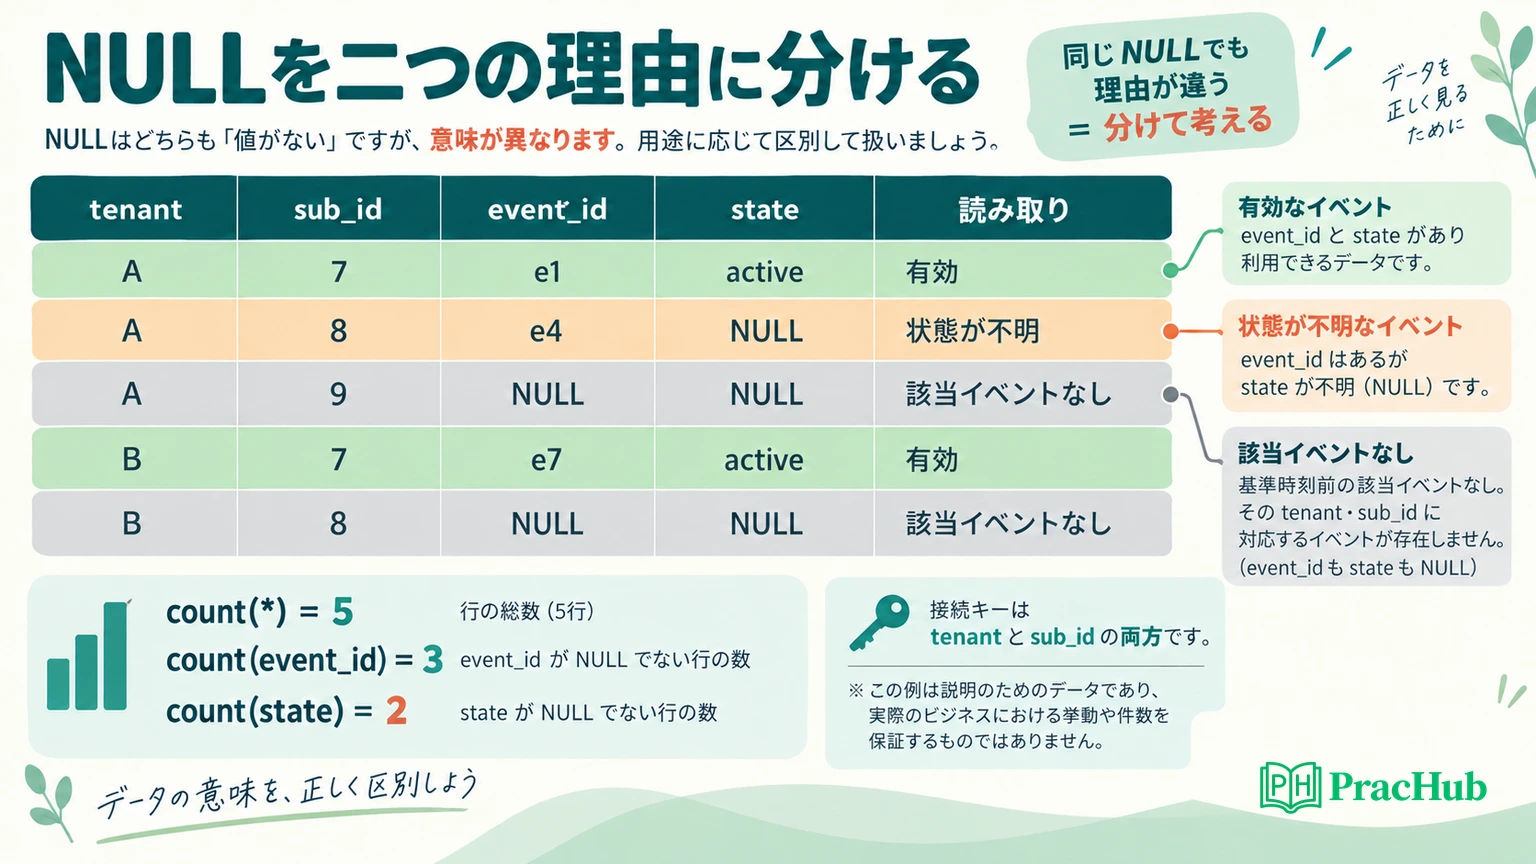
結果表では、A/8もA/9もstateがNULLです。しかしA/8にはe4があり、A/9には基準時刻前のイベントがありません。状態列だけを見ても、この二つの理由は分かりません。
公式仕様: NULLとの通常の比較は未知の結果になり、NULLを調べるにはIS NULLなどを使います。比較演算の公式資料が根拠です。本例でWHERE state = NULLを試すと0行で、WHERE state IS NULLではA/8、A/9、B/8の三行になりました。
一方、WHERE event_id IS NULLならA/9とB/8の二行です。右側のevent_idは元の表でNULLを許さないので、この結合結果では「相手なし」を識別する列として使えます。元の右側キーもNULLを取り得るモデルなら、同じ見分け方が使えるかを見直します。
A/8について、最新を選ぶ前にstate IS NOT NULLで絞ると、e4を落として古いe3のactiveが残ります。これは未知を無視して最後に分かっていた状態を持ち越す設計です。今回の「最新イベントが示す状態」とは違うため、正解として置き換えません。未知の扱いは業務の契約として確認します。
また、WHERE state = 'active'を結合後に置くと、五件の契約のうちA/7とB/7だけになります。有効な契約だけを一覧にする問いなら合いますが、全契約の状態を表示する問いには合いません。条件をONへ移すと五行は残りますが、A/8のe4も結合されなくなり、状態不明という証拠を失います。行数が同じなら同じ意味、とは限りません。
集計する列を変えると分母が変わる
公式仕様: count(*)は行を数え、count(列)はその列のNULL以外を数えます。集計関数の公式資料が根拠です。期待する五行を得てから、テナント別に状態を集計します。ここでは契約総数、イベントがある契約、有効、状態不明、イベントなしを分けます。
SELECT tenant,
       count(*) AS subscriptions,
       count(event_id) AS observed,
       count(*) FILTER (WHERE state = 'active') AS active,
       count(*) FILTER (
         WHERE event_id IS NOT NULL AND state IS NULL
       ) AS unknown,
       count(*) FILTER (
         WHERE event_id IS NULL
       ) AS no_event
FROM subscription_states
GROUP BY tenant
ORDER BY tenant;
| tenant | subscriptions | observed | active | unknown | no_event |
|---|---|---|---|---|---|
| A | 3 | 2 | 1 | 1 | 1 |
| B | 2 | 1 | 1 | 0 | 1 |
ローカル検証結果: 全体のcount(*)は5、count(event_id)は3、count(state)は2でした。最後の2は、この入力ではたまたまactive件数と一致します。cancelledなど別の非NULL状態があれば、それも数えるため、active件数を表す式としては使えません。
集計表では、テナントAの3件は有効1、状態不明1、イベントなし1に分かれます。Bの2件も有効1、イベントなし1に分かれます。この入力の各区分が契約総数へ戻ることと、結合前の五件が失われていないことを確認します。cancelledなどの状態を追加する仕様なら、その区分も集計へ追加し、総数へ戻るか確認します。
割合を求める追加質問が来たら、分母を全契約とするか、観察可能な契約とするかを先に確認します。NULLを0やactiveへ置き換えるだけでは、その判断はできません。この練習は集計の意味を確認するもので、事業上の継続率を推定する問題とは分けて扱います。
正しい結果と間違う条件を一緒に説明する
このケースはPostgreSQL 18.6で27項目を検証しました。配送とイベントの件数、半開区間と境界のe2、最新状態、複合キーを省いた誤結合、NULLの理由、COUNTの差、条件を移動した場合の行数、同じイベントの再配送を含みます。性能測定、実サービスの履歴完全性、取り込み時の衝突解決は検証していません。
面接では「LEFT JOINを使います」で止めず、「契約を五行残し、右側は基準時刻前の最新一件へそろえ、tenantとsub_idの両方で結びます」と説明できます。その後にA/8とA/9を開き、状態不明と相手なしを区別して見せると、結果を読めていることが伝わります。
索引を提案するなら、データ量、抽出範囲、実行計画を確認するところから始めます。この小さな入力で結果が正しいことは、大きな履歴に対して速いことの証拠にはなりません。まず期待する結果表を固定しておけば、後の書き換えでも意味が変わっていないか比較できます。
次の五問では、今回の問いを別のデータへ持ち込んで練習できます。特に、誤った結果が出る最小の二、三行を自分で作ってから、修正理由を日本語で説明してみてください。
| PracHubの問題 | 確かめる点 |
|---|---|
| Reason About Composite Join Keys and Predicate Placement | tenantを省いた誤結合と、ON/WHEREで変わる意味 |
| Compare SQL counts, windows, and NULL semantics | 契約数、イベントのある契約数、非NULL状態数の違い |
| Illustrate SQL Join Results with Duplicate Keys | 結合で増える行をIDの対応関係から説明する |
| Explore Subscription Patterns and Status Transitions with SQL/Pandas | 期間内の変更と基準時刻時点の状態を分ける |
| Order SQL query logical processing steps | 最新を選ぶ前後で条件をかけると何が失われるか |
A/7にB/7のe7が付く誤結合を手元で確認したら、複合キーと条件配置の問題へ進みましょう。件数が一致するだけでは見逃す誤りも、どの左行にどの右行が付くかを書いて確かめられます。
Sources and Further Reading
- PostgreSQL 18: Table Expressions — JOINと条件配置の公式説明。
- PostgreSQL 18: Window Functions — row_numberなどの公式仕様。
- PostgreSQL 18: Comparison Functions and Operators — NULL比較とBETWEENの仕様。
- PostgreSQL 18: Aggregate Functions — COUNTの公式仕様。
- PostgreSQL 18: Date/Time Types — 時差付き日時と表示の仕様。
Comments (0)