機械学習エンジニア面接:評価から推論運用まで一つのケースで説明する
Quick Overview
合成データの決定木を使い、利用可能時刻の漏洩、摂氏と華氏の不整合、モデルと特徴量を組み合わせた復旧を追います。
機械学習エンジニアの面接で「オフライン評価は良いのに、推論結果がおかしい」と聞かれたら、まず一つのリクエストについて、特徴量の取得から判定まで追ってみましょう。モデルを再学習する前に、予測時に使えた情報、特徴量の単位、モデルと前処理の組み合わせを確認すると、どの処理を調べるか、具体的に説明できます。
この記事は、架空の設備データを使うオリジナル練習です。説明用に作った六例で決定木を実際に学習し、別の八例で、遅れて届く修正値とモデルだけのロールバックを再現しました。実設備、Feast、本番API、負荷試験は使っていません。企業の実際の出題や候補者報告でもありません。公式資料の仕様、本ケースの実行結果、運用上の提案を分け、PracHubの特徴量パイプライン問題へ進む準備に使ってください。
最初に予測と業務上の行動を定義する
練習の目的は、設備ごとに「これから24時間以内に故障記録が付くか」を予測し、担当者が点検候補を検討できるようにすることです。モデルの出力1は点検の検討対象、0は対象外とします。自動停止や安全制御に使う仕組みではありません。温度だけで故障を十分予測できるという主張もしていません。
面接では、予測単位、予測時刻、結果を使う人、誤検知と見逃しの扱いを確認します。「精度を上げる」だけでは、点検枠を何件使えるか、設備を止める費用はいくらか、ラベルを何から作るかが分かりません。本ケースでは計算と実装の対応を調べるため、行動による故障の減少まで評価しないと決めます。
学習用は9月の六例、評価用は10月1日10:10:00 UTCに予測する別の八例です。八例の24時間ラベルは、観測期間が終わった後に揃った入力として与えます。実際の故障ログの欠損や遅延を測ったわけではありません。実務なら、24時間経過に加え、ラベル元の取り込み完了や点検による観測の変化を調べます。
この説明を先に置くと、「八例で分かったこと」と「運用開始の判断に必要なこと」を混ぜずに話せます。質問が曖昧なままなら、どの前提で進めるかを一文で合意し、前提が変われば評価を修正すると伝えてください。
六例で学習し、八例は評価だけに使う
学習用の摂氏温度は 10, 20, 30, 50, 60, 70、対応するラベルは 0, 0, 0, 1, 1, 1 です。次のコードは実際に使った学習関数で、深さ1の決定木を作ります。schema は温度の単位と変換規則を識別する文字列です。
def train(schema):
    if any(t + timedelta(hours=24) > FIT_AT for t in TRAIN_AT):
        raise ValueError('immature training label')
    x = [[transform(v,schema)] for v in TRAIN_C]
    return DecisionTreeClassifier(max_depth=1,random_state=0).fit(x,TRAIN_Y)
公式仕様:scikit-learn 1.7のDecisionTreeClassifierは、fit で学習し、max_depth で木の最大深さを制限する分類器です。本ケースの実行環境はCPython 3.12.14、scikit-learn 1.7.2。学習された摂氏側の分岐点は40で、40以下が0、40より大きいと1でした。40は設備の安全基準ではなく、この合成入力から得た境界です。
評価用の八例を見て境界を選び直すことはしていません。ただし、このデータ自体が説明のために作った小さな集合なので、独立した実データでの性能推定とは呼べません。random_state を固定したことも、代表性や将来性能を保証するものではありません。
モデル選択を説明する面接なら、さらに時系列を守った検証期間、比較する既存手法、ハイパーパラメータを決める期間、最後まで触らない評価期間を設けます。本記事は複雑なモデルの優劣を競う課題ではなく、同じモデルがどの情報と変換を受け取ったかを検査する課題です。
イベント時刻と利用可能時刻を別々に見る
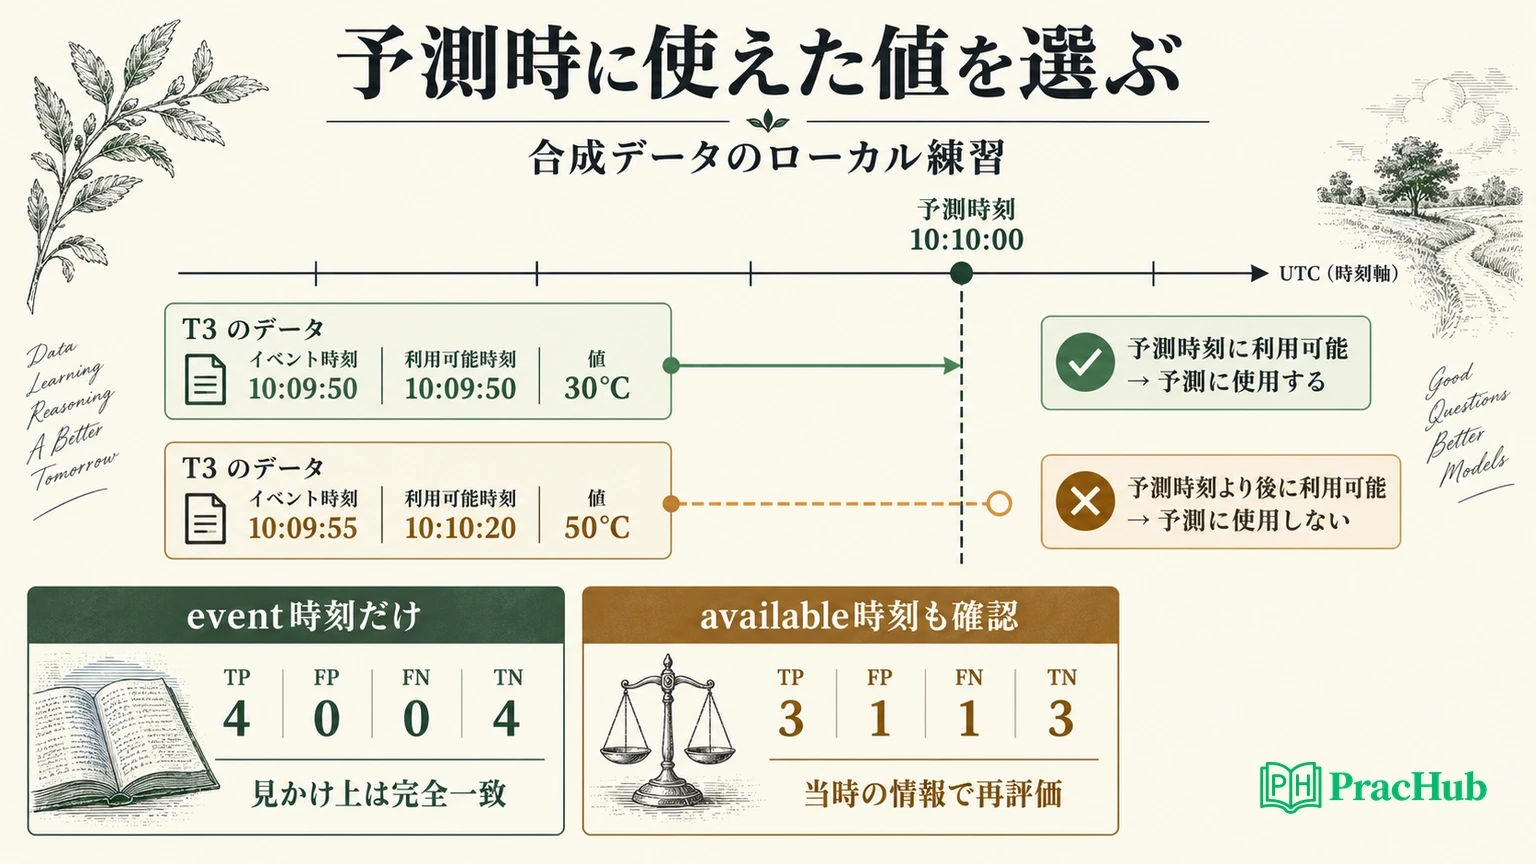
各特徴量レコードには、設備ID、測定対象の時刻 event_at、推論側で値を利用可能になった時刻 available_at、摂氏値を持たせます。評価対象のT3には、二つの記録があります。
| T3の記録 | event_at(UTC) | available_at(UTC) | 摂氏値 | 10:10:00の予測に使えるか |
|---|---|---|---|---|
| 元の値 | 10:09:50 | 10:09:50 | 30 | 使える |
| 後から届く修正値 | 10:09:55 | 10:10:20 | 50 | まだ使えない |
二つ目はイベント時刻だけなら予測より前です。しかし、10:10:20に初めて利用可能になる値を、10:10:00の予測へ渡すことはできません。後日作り直した表で50を選び、「当時のオンライン入力も50だった」と扱うと、オフライン評価の情報が増えてしまいます。
このケースでは、両方の時刻が予測時刻以下で、イベントの経過時間が60秒以内のレコードから選びます。60秒ちょうどは含め、61秒は除外します。同じ設備について候補が複数なら、イベント時刻、利用可能時刻の順に新しいものを選びます。実行した関数は次の通りです。availability=False は比較用の意図的な誤実装を再現するための引数です。
def asof(asset, at, rows, ttl=60, *, availability=True):
    eligible = [r for r in rows if r.asset == asset
                and 0 <= (at-r.event_at).total_seconds() <= ttl
                and (not availability or r.available_at <= at)]
    if not eligible:
        raise ValueError('no eligible reading')
    return max(eligible,key=lambda r:(r.event_at,r.available_at)).celsius
公式資料:Feastのpoint-in-time joinsは、標準ではイベント時刻を制約し、作成時刻は重複排除に使うと説明しています。現在の資料には filter_by_created_timestamp=True による追加条件もあります。ただし、作成時刻がオンラインでの利用可能時刻を表すこと、対応するoffline storeで使えること、NULLの扱いを確認する必要があります。本記事の関数はFeastを実行した結果ではなく、二つの時刻を確認する自作の最小例です。
実システムでは、取り込み完了とオンラインストアへの反映完了が異なる場合があります。available_at という列名だけを信用せず、どの段階の記録かを確認しましょう。また、この関数は選ばれた値だけを返すため、運用版なら元レコードのIDや両時刻も返し、後で入力をたどれる形にします。同時刻・同じキーに相反する値がある場合の扱いも別途必要です。
完全一致に見える評価を八行から点検する
T3に加え、T6にも遅着する修正値を用意しました。T6は予測時には45、後の修正では25です。ほかの六例は変えず、同じ学習済みM1と同じラベルで比較します。
| 設備 | 当時使えた摂氏値 | 後日・イベント時刻だけで選ぶ値 | ラベル | 当時の値でのM1判定 |
|---|---|---|---|---|
| T1 | 20 | 20 | 0 | 0 |
| T2 | 50 | 50 | 1 | 1 |
| T3 | 30 | 50 | 1 | 0 |
| T4 | 60 | 60 | 1 | 1 |
| T5 | 25 | 25 | 0 | 0 |
| T6 | 45 | 25 | 0 | 1 |
| T7 | 15 | 15 | 0 | 0 |
| T8 | 55 | 55 | 1 | 1 |
**本ケースの実行結果:**遅着した修正値を混ぜると、TP4・FP0・FN0・TN4になります。当時利用できた値へ戻すと、TP3・FP1・FN1・TN3です。適合率は 3/(3+1)=0.75、再現率も 3/(3+1)=0.75。陽性は故障ラベル1で、T3が見逃し、T6が誤検知です。scikit-learnのprecision_scoreにある適合率の分母と対応させて説明できます。
評価値が1から0.75へ下がった原因を説明できれば、未来の値で見かけの性能を戻す誤りを避けられます。本ケースでの解釈は、当時の入力条件へ評価を直した結果、もともと見えなかった誤判定が見えた、というものです。モデルを変えた成果とは区別します。
八例では、期間や設備群を変えた性能、確率の校正、点検の有効性は分かりません。実運用の検証では、件数を添えた期間別の結果と、設備・環境・欠損状況ごとの偏りを調べます。後から多くの切り口を試した差を、事前に決めた評価と同じ強さで説明しないことも大切です。
同じ列名でも単位が変われば入力は違う
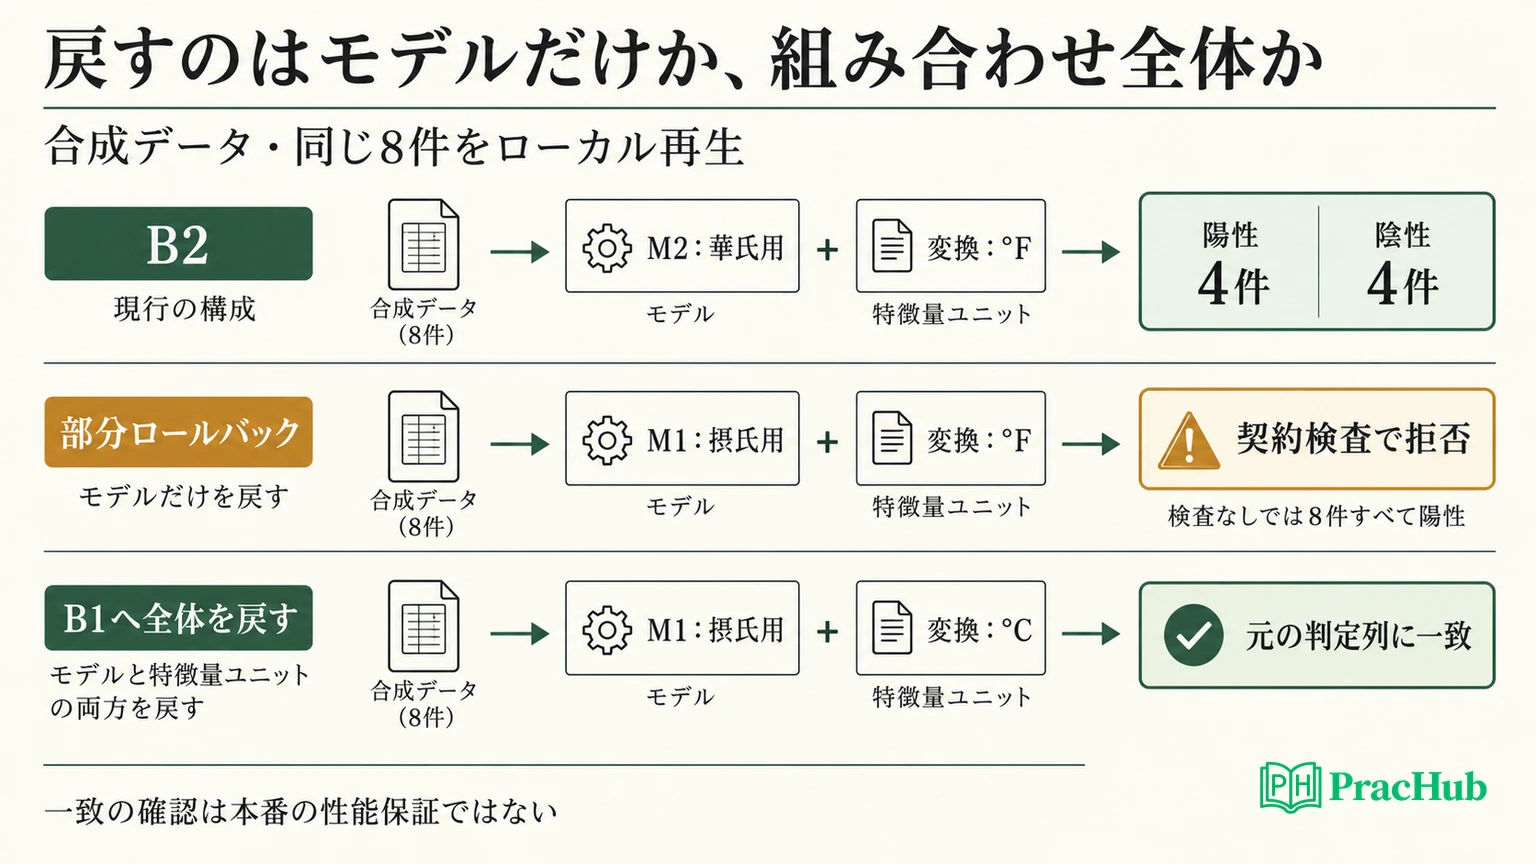
次に、特徴量の単位を摂氏から華氏へ変えるリリースB2を考えます。変換は F=C×9/5+32。M2は同じ六例を華氏へ変換して学習し、分岐点は104になりました。摂氏40と華氏104は同じ温度です。B1はM1と摂氏変換、B2はM2と華氏変換を組み合わせます。
学習済みの二つの組み合わせへ同じ八例を渡した実行結果は、どちらも 0, 1, 0, 1, 0, 1, 0, 1 でした。ここでいう一致は、この入力集合で得た分類結果の一致です。あらゆる浮動小数点境界や、別の前処理にも一致することまで証明したわけではありません。
公式資料:scikit-learnのよくある落とし穴は、学習時に行った変換を評価や推論でも適用すること、前処理の学習に評価データを混ぜないことを説明しています。このケースの単位変換には学習する係数がありませんが、学習側と推論側で同じ入力の意味を守る点は共通します。
モデルのファイル名だけでなく、特徴量の順序、単位、欠損時の扱い、変換コード、予測基準時刻、鮮度条件を記録します。標準化を使うなら、学習済みの平均・分散も同じ成果物へ含めます。「温度」という列名と浮動小数点型が一致していても、摂氏か華氏かは分からないためです。
ここでの推論は、値の分布が変わったという監視通知を、すぐに実世界の変化と解釈しないことです。20が68へ変わった原因が単位変更なら、まず契約の不整合を調べます。その後で、入力条件が同じ期間や設備群でも性能が落ちているかを確認します。
モデルだけ戻すと、ロールバックが故障を作る
B2からM1だけを戻し、華氏変換を残すとどうなるでしょうか。T1の20°Cは68°Fへ変換されます。摂氏を期待するM1へ68という数値をそのまま渡すと、分岐点40を超えて陽性になります。この八例では最も低い15°Cでも59°Fなので、検査なしの部分ロールバックは全件を陽性にしました。
その結果はTP4・FP4・FN0・TN0、適合率0.5、再現率1です。再現率だけ見れば改善に見えても、陰性四例もすべて拾っています。「旧モデルに戻したから安全」とは判断できません。
この誤った組み合わせを防ぐ最小の検査として、temperature-c-v1 と temperature-f-v2 の一致をモデル側と変換側で確認します。以下は実行した関数です。不一致なら推論を拒否します。HTTPサーバーは起動しておらず、ValueError はAPIの実測応答ではありません。
def infer(bundle, celsius):
    if bundle.expected_schema != bundle.transform_schema:
        raise ValueError('model-feature contract mismatch')
    return int(bundle.model.predict([[transform(celsius,bundle.transform_schema)]])[0])
| 組み合わせ | ローカル再生の結果 | この段階の判断 |
|---|---|---|
| B2:M2+華氏変換 | B1と同じ判定列 | 八例では対応する |
| M1+華氏変換、検査なし | 八件すべて陽性 | 誤った組み合わせ |
| M1+華氏変換、契約検査あり | 不一致として拒否 | 予測成功や復旧とは呼ばない |
| B1:M1+摂氏変換へ戻す | 元の判定列に一致 | この再生範囲では元の挙動に戻った |
契約文字列を同じに書き換えるだけでは、中身の変換が正しい証拠になりません。実運用なら、固定入力の期待値、変換実装の版、成果物のハッシュ、展開後に読み込まれた版も照合します。複数インスタンスへの切り替え、進行中のリクエスト、共有ストアの互換性は、このローカル関数では検証していません。
監視では入力・予測・後日ラベルをつなぐ
公式資料:GoogleのRules of MLは、training-serving skewの原因として学習・推論パイプラインの処理差などを挙げ、推論時に使った特徴量の記録や処理の共有、差の測定を勧めています。同じ例の再生で結果が違う場合を、次の期間のデータで性能が落ちる場合と分けて考えます。
本ケースで残したい記録は、リクエストID、設備ID、予測時刻、特徴量の両時刻、選んだ値とschema、変換後の値、モデル版、リリース版、判定です。後日のラベルは別に追加し、予測時点の入力を上書きしません。実際に保存する項目と保持期間は、データ量や機密性、再現に必要な範囲に合わせて決めます。
障害時には、まず同じリクエストを比較します。値を選ぶ段階で違えば時点や鮮度、変換後に違えば単位や前処理、同じ入力ベクトルでも違えばモデルの版や推論実装を確認します。この順序は本ケースの調査提案であり、企業共通の採点基準ではありません。
入力の鮮度、欠損、契約不一致、予測件数、エラー、遅延と、ラベル確定後の適合率・再現率を分けます。すぐ分かる技術的な異常と、24時間以上待つ必要のある性能評価を同じダッシュボードの一数値へ押し込めないことが重要です。ラベルが届く前に「故障予測の性能が回復した」とは言えません。
テスト結果から再開条件を説明する
実行した25のunittestには、利用可能時刻の境界、未来のイベント、60秒の鮮度境界、設備不一致、二つの混同行列、単位変換後の判定一致、部分ロールバックの誤動作と拒否、全体を戻した場合の一致、型や非有限値の拒否を含めました。合格数には、意図した悪い挙動を確認するテストも入っています。25件すべてが本番の正しさを証明するテスト、という意味ではありません。
「再開する条件」を聞かれたら、たとえばこう答えます。「まずモデルと特徴量の組み合わせを固定し、同じ入力の再生と負の対照を通します。次に実際の展開先で版と契約を確認し、入力鮮度やエラー、遅延を見ながら限定的に再開します。後日のラベルが揃ってから、予測時の情報条件を守った性能を評価します」。限定公開の割合や停止条件は、利用者への影響と運用体制に合わせて事前に決めます。
本記事で確認したのは、Python内の学習、入力選択、分類、契約検査です。実APIのタイムアウト、オンラインストアの反映遅延、負荷時の遅延分布、展開の原子性、実設備への効果は未検証です。ローカル再生の合格を根拠にそれらも完了したと話さず、次に必要な観測を示してください。
経験を説明する場合は、自分が担当した層も明確にします。特徴量の取得だけか、前処理の版管理か、配信基盤か、監視と復旧か。「チームでモデルを運用した」のあとに、自分が追加した検査、その検査で見つかった差、残った制約を話せるようにしておきましょう。
次の五題では、同じ入力をどこまで追えるか試す
以下はそれぞれ確認済みのPracHub問題です。問題ページの会社表示を、今後も同じ問題が出る保証として使わないでください。候補者報告による出題頻度や選考順序は、この記事では扱っていません。
| PracHubの問題 | 本ケースから広げる問い |
|---|---|
| Detect Data Leakage in Supervised Learning Pipelines | 予測時に利用できない情報を、どの作成処理で排除するか |
| Design a Feature Store for Offline Training and Low-Latency Online Serving | 履歴の再現と低遅延の取得で、同じ特徴量定義をどう守るか |
| Review a Feature Pipeline PR for Production Risks, Then Serve Features by Freshness | 鮮度・遅着・版の不整合を、レビューと取得時の検査へどう分けるか |
| Optimize Model Serving Under 200ms | 正しさを確認した後、実際の遅延をどの区間で測るか。本文では200msを実測していない |
| Design a Platform for Training and Serving ML Models | 学習成果物、変換、配信、監視とロールバックをどう結び付けるか |
最初は特徴量パイプラインのレビュー問題を開き、予測時刻、選んだ特徴量、契約、再生結果の四点を説明してみてください。判定が違った場合に、再学習の前に何を比較するかまで答える練習になります。
Sources and Further Reading
- scikit-learn 1.7:DecisionTreeClassifier — 学習と木の深さの仕様。
- scikit-learn 1.7:Common pitfalls — 前処理の一貫性とデータ漏洩。
- scikit-learn 1.7:precision_score — 適合率の定義。
- Feast:Point-in-time joins — イベント時刻、作成時刻による制約と対応ストアの注意点。
- Google:Rules of ML — training-serving skewの測定と推論時特徴量の記録。
Comments (0)