データエンジニアの面接:遅延データと再実行をパイプラインで説明する
Quick Overview
データエンジニアの面接を、架空の請求データ八行で練習します。重複イベント、遅延修正、古い版、チェックポイントを分け、日付別の金額と再実行前後の状態を照合します。PythonとSQLiteで33項目を検証し、分散システムでは未確認の境界も説明します。
昨日の取り込みをもう一度実行すると、集計金額が増える。遅れて届いた修正を取り込むと、総額は合っているのに月別の数字が違う。データエンジニアの面接では、こうした状態を小さな入力と出力で説明できると、パイプラインの設計を具体的に話せます。
この記事では、架空の請求データを分析用に取り込むケースを使います。重複、遅延修正、古い版、チェックポイント、失敗後の再実行を順に追い、どの値を照合すれば正しさを確かめられるかを考えます。主題は「重複を消す方法」だけではなく、修正された日付と金額を、再実行しても一貫して公開する方法です。
根拠の区分: AirflowとSQLiteの公式資料は、再実行やSQLの仕組みを説明する根拠として使います。入力、集計対象日の変更、回答例はPracHub独自の練習です。特定企業の面接内容や候補者の体験談を示すものではありません。実験ではPythonとローカルSQLiteを使用し、Airflow、ブローカー、分散ウェアハウスは動かしていません。
まずDesign an idempotent SQL ETL for late dataで考えるように、何を同じ入力とみなし、再実行後に何が変わらないべきかを定義しましょう。
取り込む一行が何を表すかを確認する
今回の一行は、一件の請求データについて、その版の金額と集計対象日をそろえたスナップショットです。金額は円の整数で、差分の加算額ではありません。版2の1,000円は、版1の1,200円に追加するのではなく、現在値を置き換えます。
集計対象日も入力に含まれ、上流の修正版によって変わる契約とします。これは社内分析の練習用ルールです。法的な請求書の発行日や会計処理を変更する指針ではなく、税、決済、返金も扱いません。現実の業務では、どの日付が修正可能かを担当者に確認する必要があります。
面接では、次の四つを分けて聞きます。「明細を追加するイベントか、全体を置き換えるスナップショットか」「同じIDで内容が変わるか」「版番号は誰が保証するか」「遅れて届いた古い日付を処理するか」です。全体像と差分を混同すると、重複排除が正しくても金額が誤ります。
公式のAirflow Best Practicesは、再実行で同じ結果を得ることや、変化する最新データではなく特定の入力範囲を使うことを勧めています。これは設計の参考であり、本実験がAirflow上で動いた証拠ではありません。Airflow公式資料
八つの入力から、最終結果を先に計算する
次の順序は上流が割り当てた安定した取り込み位置です。位置は連続して増え、同じ位置の内容は後から変わらないとします。集計対象日が過去でも、新しい位置で届くデータは確認します。
| 位置 | event_id | 請求ID | 版 | 集計対象日 | 円 | 初回の分類 |
|---|---|---|---|---|---|---|
| 1 | e10 | INV-A | 1 | 2026-09-30 | 1200 | 適用 |
| 2 | e11 | INV-B | 1 | 2026-09-30 | 800 | 適用 |
| 3 | e10 | INV-A | 1 | 2026-09-30 | 1200 | 同じイベントの重複 |
| 4 | e12 | INV-C | 1 | 2026-10-01 | 600 | 適用 |
| 5 | e13 | INV-A | 2 | 2026-10-01 | 1000 | 遅延修正を適用 |
| 6 | e14 | INV-B | 1 | 2026-09-30 | 800 | 同じ版・同じ内容 |
| 7 | e15 | INV-A | 1 | 2026-09-30 | 1200 | 既存より古い版 |
| 8 | e16 | INV-D | 1 | 2026-09-30 | 400 | 遅延到着した新規データ |
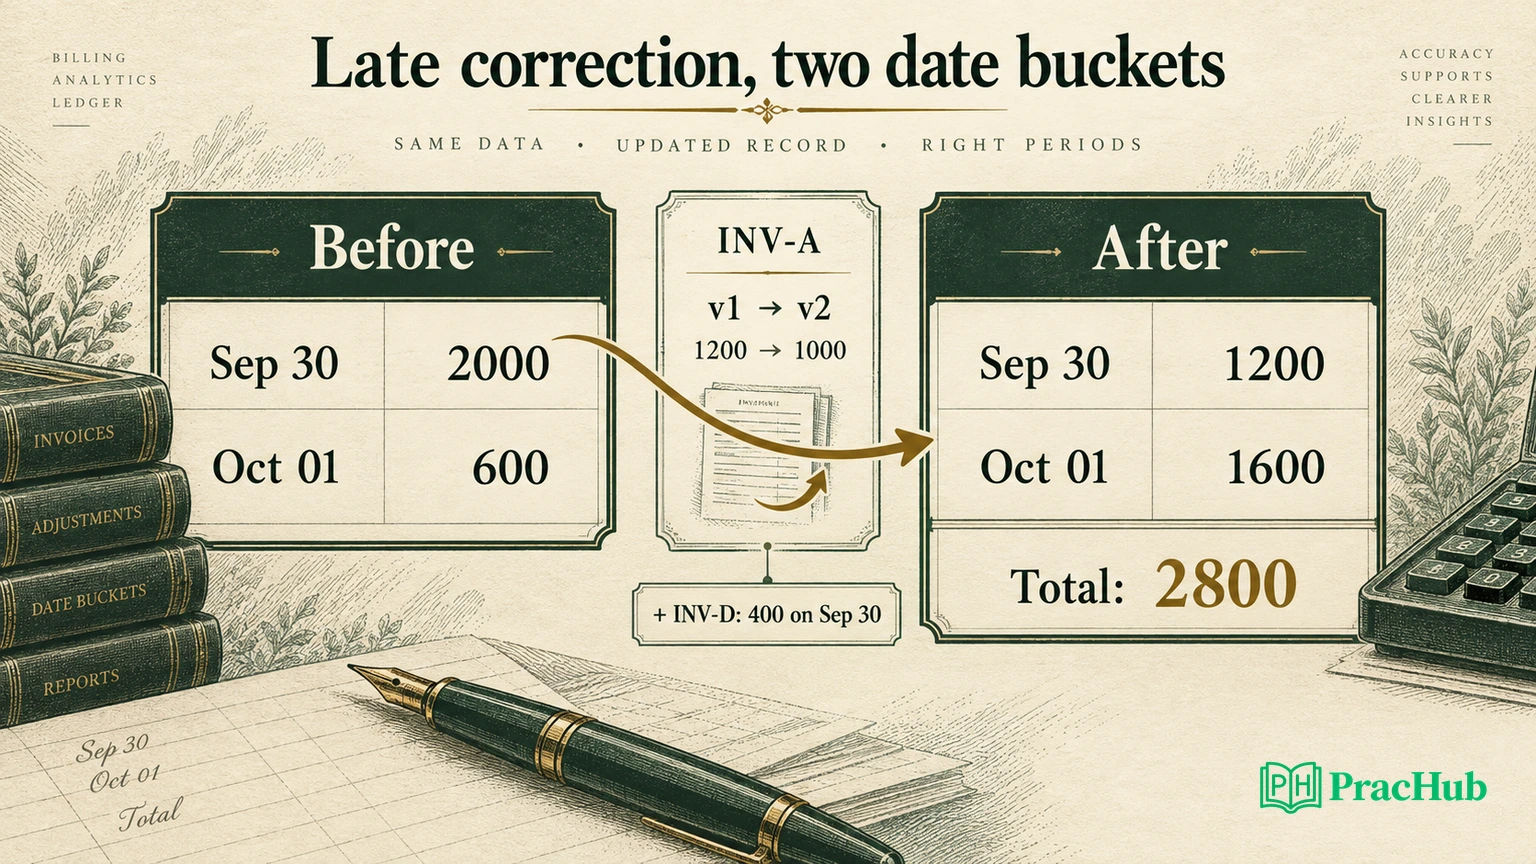
最初に位置1〜4を処理します。現在の請求データはA、B、Cの三件で、9月30日は2,000円、10月1日は600円です。位置3をもう一件として足してはいけません。
次に位置5〜8を取り込みます。Aは版2になり、1,000円で10月1日に所属します。Bは800円のまま、Cは600円のまま、Dが9月30日に400円で加わります。最終結果は四件、9月30日が1,200円、10月1日が1,600円、総額2,800円です。
位置7は未見のevent_idですが、Aの現在値を更新しません。「初めて受け取ったイベント」と「現在値へ適用すべき版」は別です。入力表を眺めるだけでなく、Aの旧版がどこから消え、新版がどこへ入るかを手で書いてから実装を説明します。
取り込み位置、イベント、業務上の版を分ける
このケースは、五つのテーブルで区別を保持します。キーごとに識別する対象を決め、再送と業務上の更新を区別します。
| 保存先 | 主なキー | 保存する理由 |
|---|---|---|
| source_rows | 取り込み位置 | 過去の位置を再読したとき、内容が変わっていないか照合する |
| events | event_id | 同一イベントの再送と内容の矛盾を区別する |
| versions | 請求IDと版 | 別イベントIDでも同じ版の内容が一致するか確認する |
| invoices | 請求ID | 分析に使う最新の一件を保持する |
| checkpoint | 一つの固定行 | どの位置まで同じトランザクションで確定したか記録する |
同じevent_idで同じ内容なら重複です。同じIDで金額が違えば、単に無視せずエラーにして、その取り込み全体をロールバックします。別IDでも同じ請求ID・版なら内容を照合し、同じなら同等の入力、違うなら矛盾として扱います。
本実装の正規化対象は、請求ID、版、集計対象日、円の四つを固定した配列にしたJSONです。名称の表記ゆれ、通貨換算、時刻帯の同値性を解決する仕組みではありません。入力スキーマや日付の厳密な検証は、本ケースでどこまで実装したかを分けて話します。
取り込み位置が飛んだ場合も停止します。今回の処理は「連続した確定位置」を進めるためです。複数パーティションを持つブローカーなら位置の管理単位が変わります。この一つの整数を、そのまま全パーティション共通の進捗にしてはいけません。
新しい版だけを現在値へ適用する
現在値の更新は、次のSQLで行います。古い版と同じ版は、事前の内容検証や分類を経たうえで現在値を変更しません。
INSERT INTO invoices VALUES (?, ?, ?, ?)
ON CONFLICT(invoice_id) DO UPDATE SET
    revision = excluded.revision,
    allocation_day = excluded.allocation_day,
    amount_yen = excluded.amount_yen
WHERE excluded.revision > invoices.revision;
SQLiteの公式資料では、UPSERTは一意性の衝突に応じて更新または何もしない処理を選びます。excluded は挿入しようとした値を参照し、末尾の条件で更新を抑止できます。SQLite UPSERT
ここでは請求IDが現在値の粒度で、版が更新の条件です。到着時刻だけで勝者を選ぶと、後から届いた位置7の古い版がAを版1へ戻してしまいます。実験で版のガードを外した変種では、9月30日が2,400円、10月1日が600円となり、期待値と一致しませんでした。
ただし、版の数値が大きければ常に正しいという一般論ではありません。上流が再起動で版をリセットする、別の発行元が同じ請求IDを使う、差分しか送らない、といった契約なら設計を変えます。本ケースでは、一つの発行元が請求ごとに増える版と全体像を保証する前提です。
修正前後は、総額と日付別の両方で照合する
期待結果は総額だけでは不十分です。Aの金額が正しくても、対象日が9月に残れば、10月の分析に使う数字が違います。まず請求IDごとの版・日付・金額を照合し、その後に日付別の集計を比較します。こうすると、総額だけでは見えない旧日付への残りを検出できます。
| 段階 | 9月30日:件数・円 | 10月1日:件数・円 | 全体:件数・円 | 確定位置 |
|---|---|---|---|---|
| 位置1〜4の確定後 | 2件・2000 | 1件・600 | 3件・2600 | 4 |
| 位置5〜8の確定後 | 2件・1200 | 2件・1600 | 4件・2800 | 8 |
| 位置1〜8を再実行後 | 2件・1200 | 2件・1600 | 4件・2800 | 8 |
9月の変化は、Aの旧1,200円を除き、Dの400円を加えるのでマイナス800円です。10月はAの新1,000円が加わります。両日の変化を合わせた総額の差はプラス200円です。この分解が、遅延修正をただの追加として扱っていない証拠になります。
ローカル実装は invoices の現在値をSQLの GROUP BY で集計します。物理的に月別ファイルを書き換える実装ではありません。ウェアハウスで日付別テーブルやキャッシュを持つなら、変更前と変更後の両方の日付を再計算対象として扱う設計が必要です。片方だけ直すと、旧日付の寄与が残ります。
再実行後は現在値を請求ID順に並べたJSONのハッシュも比較しました。同じハッシュは、このスナップショットが一致する補助証拠です。SQLiteファイル全体の一致、入力の真正性、データ改ざんの防止を証明するものではありません。
データとチェックポイントを一緒に確定する
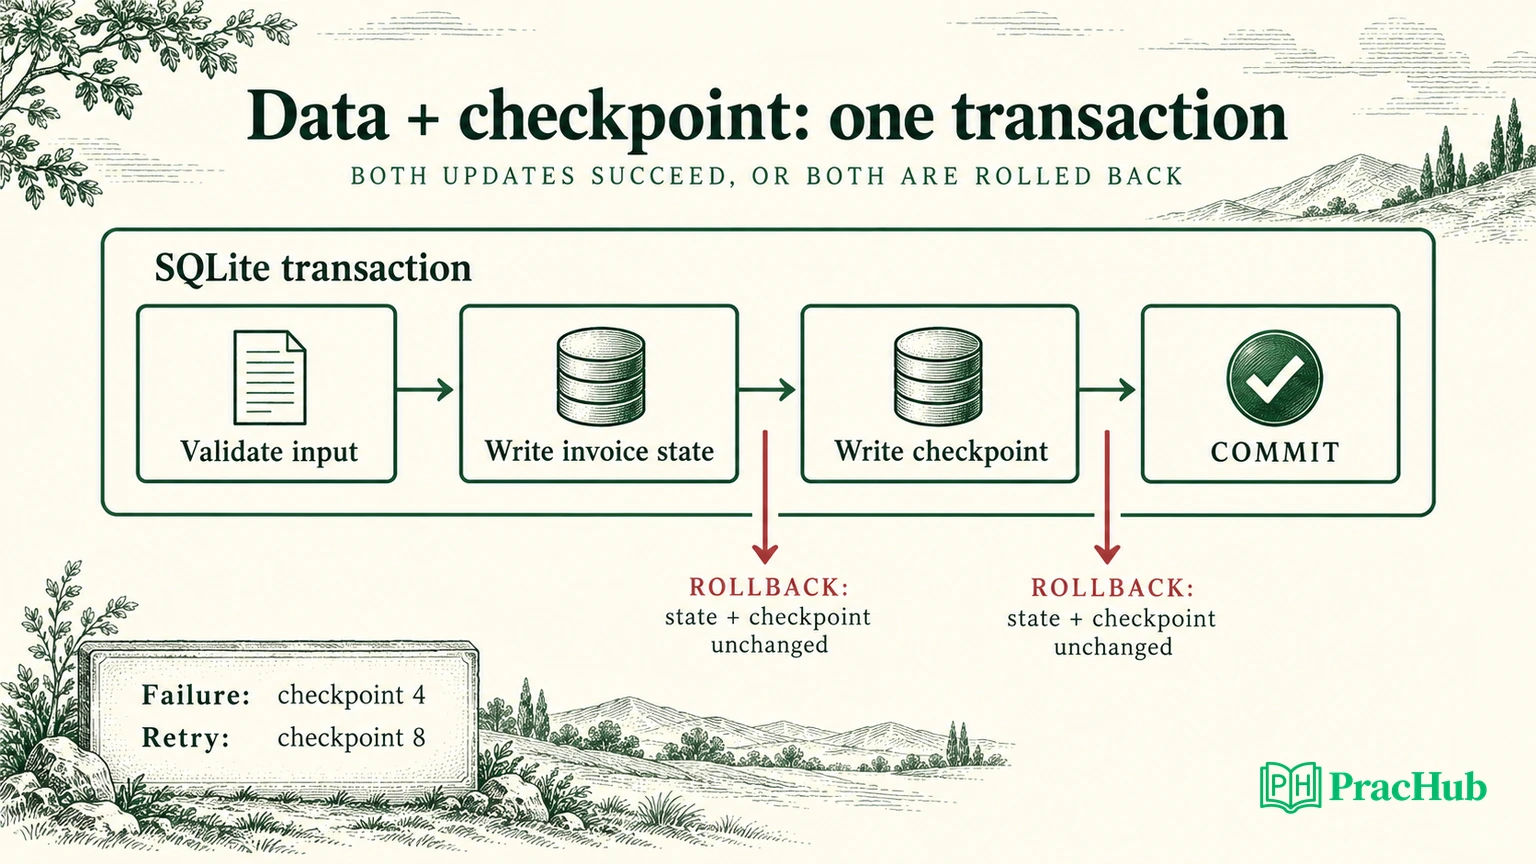
取り込みが失敗した後、どこから再開するかを決めるのがチェックポイントです。データを保存できていないのに位置8だけが確定すると、再開時に位置5〜8を読み飛ばす危険があります。逆にデータだけが確定した場合は、再読による影響を検証する必要があります。
この実験では BEGIN IMMEDIATE から始め、入力記録、イベント、版、現在値、チェックポイントの書き込みを同じSQLiteトランザクションに入れます。例外時はコードが明示的に ROLLBACK を実行します。公式資料によれば、SQLiteは同時に一つの書き込みトランザクションを扱い、BEGIN IMMEDIATE は書き込みを開始しようとする際に競合することがあります。SQLite Transactions
| 注入した失敗 | ロールバック後の請求集計 | ロールバック後の確定位置 | 次に行ったこと |
|---|---|---|---|
| 現在値の更新後、チェックポイント更新前 | 9月2000・10月600 | 4 | 同じ位置5〜8を再実行 |
| チェックポイント更新後、COMMIT前 | 9月2000・10月600 | 4 | 同じ位置5〜8を再実行 |
| 失敗なしでCOMMIT | 9月1200・10月1600 | 8 | 位置1〜8を再読して一致を確認 |
二つの失敗では、五つのテーブルすべてが実行前と同じ内容に戻ることを比較しました。チェックポイント更新のSQLが実行されても、COMMIT前なら確定した進捗ではありません。「ログに位置8と出た」ことと「読者が一貫した位置8の結果を読める」ことを分けて説明します。
実行結果の33項目と、残る運用上の境界
Python 3.12.14とSQLite 3.53.4で、33項目のアサーションが成功しました。誤った変種の結果が期待値と異なることも、この33項目に含めて確認しています。初回分類、日付別結果、二つの失敗時の全テーブル比較、再実行の不変性、通常の閉じ直し後の再読、矛盾入力の拒否、誤った版更新の検出を含みます。
成功後の記録は取り込み位置8個、event_idは7個、請求と版の組は5個、現在値は4件です。これらの件数が違うのは契約どおりです。同じイベントの配送位置が二つあり、一件の請求に複数版が存在するからです。すべてのテーブルを四行にそろえる必要はありません。
位置1〜8を再実行すると、8行すべてが過去位置の再読に分類され、適用は0件です。source_rows、events、versions、invoices、checkpointの内容と、請求ID順にした現在値のハッシュは変わりません。本実装には実行履歴を追加する別テーブルがないため、「再実行でも全テーブルが同じ」という結果になっています。運用の試行履歴を別に保存する設計では、その履歴が増えること自体は異常ではありません。
拒否した入力には、過去位置の内容変更、同じevent_idの内容矛盾、同じ請求と版の内容矛盾、位置の欠落、不正な版を含みます。それぞれ拒否後に保存状態が変わらないことを確認しました。ただし、任意の日付文字列や全スキーマ変化を検証したという意味ではありません。
実験は単一ワーカーとローカルSQLiteです。プロセス強制終了、停電、ストレージ障害、同時ワーカー、ブローカーの応答喪失は未検証です。通常の接続の閉じ直しは、障害耐性全体の証明にはなりません。面接では「同じSQLite内の結果は確認した。分散システムのexactly-onceは未検証」と、証拠の届く範囲を落ち着いて説明できます。
面接では、再開地点と未検証範囲まで答える
回答は、契約、結果、失敗、境界の順でまとめられます。「請求の全体像を版で置き換え、配送位置とイベントIDを分けます。Aの遅延修正で9月から1,200円を除き、10月へ1,000円を入れます。確定位置の前後に失敗を入れると、同じDB内の五つのテーブルは位置4の状態へ戻りました。再実行後は位置8で四件・2,800円になり、全入力の再読でも変わりません。ブローカーとの分散コミットは検証していません」。
「本番でどうするか」と追問されたら、まずデータ保存先と進捗の保存先が同じトランザクションに入るかを確認します。別システムなら、本実験の原子性をそのまま主張できません。安定した入力の再取得、保存先の冪等性、コミット済みか不明なときの照会など、失敗境界ごとに設計を説明します。
また、遅延データをいつまで受け入れるか、締め後の修正を誰が承認するか、どの利用者へ訂正を通知するかは業務要件です。技術側だけで期限を決めず、件数・金額・対象日の差分を示して合意を取ります。本ケースは無期限の運用や締め処理を実装していません。
改善案は一つずつ検証可能にします。たとえば、影響のある二日分だけを再計算する案なら、全件集計と結果が同じことを先に比較し、その後で処理時間を測ります。実測前に高速化率やコスト削減率を言い切る必要はありません。
五つの問題で条件を変えて説明する
以下は補助練習であり、特定企業の次回面接の予測ではありません。問題本文の条件を読み、本ケースの一つの発行元・全体置換・連続位置という前提が通用するかを確認してください。
| PracHubの問題 | 変えて考える点 |
|---|---|
| Design an idempotent SQL ETL for late data | 未見の古い版と重複イベントをどう分けるか |
| Reconcile ledgers with SQL/Python and late events | 総額の一致だけでなくキーと対象期間を照合する |
| Choose Between Batch and Streaming for a Data Pipeline | 許容遅延と再計算範囲から方式を選ぶ |
| Data Pipeline Reliability, Backfills, and Spark Optimization | 再実行の正しさと性能改善の証拠を分ける |
| Explain ETL schema changes and ensure integrity | 入力契約の変更をどこで検知・拒否・移行するか |
手元の八行で修正前後の金額を計算してから、遅延データを扱う冪等ETLの問題を開き、「同じIDで内容が違う」「古い日付に新しい修正が来る」「保存後に応答が失われる」の三つを、同じ重複として処理しない説明を練習しましょう。どの証拠を見て再開するかまで答えると、設計と運用をつなげられます。
Sources and Further Reading
- Apache Airflow — Best Practices — 再実行での一貫性と固定した入力範囲。本実験ではAirflowを実行していない。
- SQLite — UPSERT — 一意性の衝突、excluded、条件付きの更新。
- SQLite — Transactions — 明示的なトランザクションと書き込みの境界。別システムとの原子性は保証しない。
Comments (0)