Entrevista Data Engineer: un caso de SQL, cargas incrementales y recuperación de pipelines
Quick Overview
ActualPG18.6/psycopg3.3.6/CPython3.12.14 sequential38checks: contiguoussourcepositions versusper-eventrevision/day; lateCSeptember30; B2tombstoneblocksB1replay, historicalB1conflict999reject; deltaabsencepreservesB; A3movesday; twoinjectedbeforecommitfailures preservecheckpoint6/state/version/batchcounts; finalcheckpoint8active3/state4/versions7/batches4. Freshconnectionvisibilitynotprocesscrash; noAirflow/concurrentworkers/CDC/externaloutput/loadproof.
Una carga incremental puede terminar en verde y perder una corrección, conservar una venta borrada o avanzar el checkpoint sin publicar sus datos. Para preparar una entrevista Data Engineer, practica una pregunta más precisa que «¿qué herramienta usarías?»: ¿qué estado debería leer el consumidor después de cada llegada y de cada fallo?
Resolveremos un delta de pedidos con PostgreSQL. El laboratorio ejecuta 38 comprobaciones sobre versiones, datos tardíos, tombstones y dos excepciones antes del commit. La guía de diseño de pipelines de PracHub amplía requisitos y arquitectura; aquí seguiremos ocho posiciones de entrada hasta su resultado SQL.
Evidencia y alcance. Los mecanismos citados proceden de documentación oficial. Los pedidos y las decisiones de diseño son un ejercicio original sintético. Ejecutamos un solo worker Python contra PostgreSQL local; no un conector CDC, Airflow, Kafka ni una prueba de contratación. Las preguntas reportadas sirven para practicar, sin predecir procesos actuales de empresas.
Aclara si recibes un snapshot o un delta
El consumidor quiere el importe vigente por día, en centavos enteros. Cada identidad representa un pedido; una versión superior reemplaza su estado anterior. Una actualización puede cambiar importe y día. Una marca deleted=true retira el pedido del agregado, conservando su versión en la tabla de estado.
El origen entrega un delta: cada fila comunica un cambio. Si B no aparece en un lote, B permanece como estaba. No interpretes esa ausencia como borrado. Un snapshot completo tendría otra semántica: habría que definir su alcance y cuándo la ausencia elimina una contribución.
Pregunta quién asigna la versión y qué significa repetirla. Nuestro contrato exige el mismo contenido para una identidad y revisión ya vistas. Una revisión mayor puede corregir; una menor no debe sobrescribir. Una revisión igual con contenido diferente es un conflicto, aunque llegue en un lote nuevo.
Fija estas reglas antes de escribir el UPSERT. ON CONFLICT no sabe si el archivo era completo, si deleted significa baja lógica o si un importe diferente constituye una corrección autorizada. El entrevistador puede cambiar una premisa; tu solución debe mostrar qué decisión deja de ser válida.
Separa posición del origen, versión y día de negocio
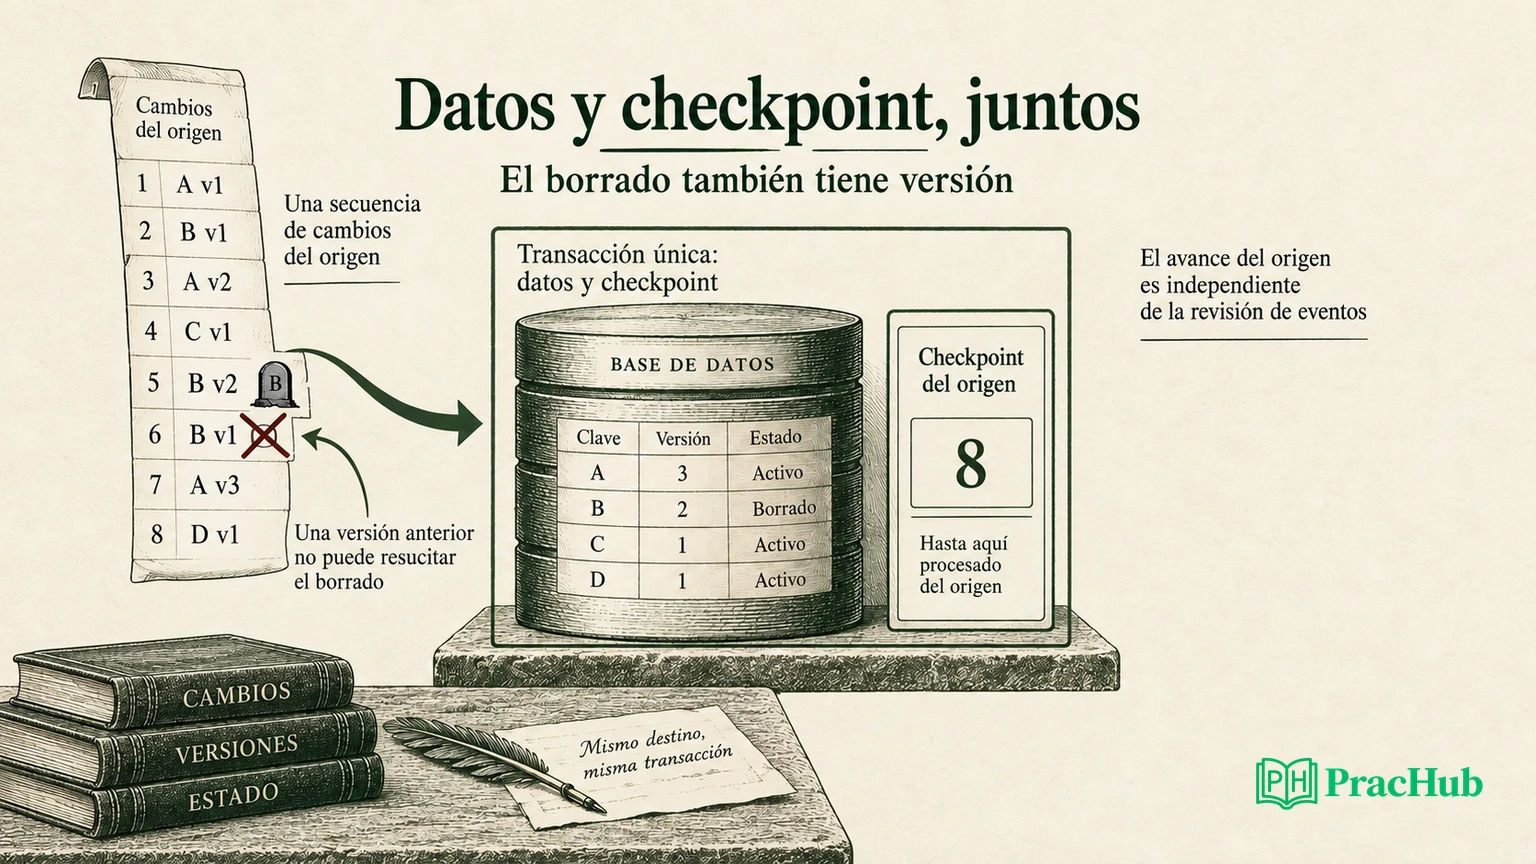
Usaremos posiciones contiguas del 1 al 8 para expresar progreso. Son una simplificación explícita del origen, no una afirmación de que cualquier broker o base proporcione enteros sin huecos. En el intervalo (0,2], el límite 0 queda fuera y las posiciones 1 y 2 quedan dentro.
La versión pertenece a cada identidad: A v2 y B v2 no tienen un orden global entre sí. El día determina dónde contribuye el importe vigente. La posición indica hasta qué entrada se procesó, incluso cuando una versión antigua no cambia el resultado.
| Posición | Cambio sintético | Consecuencia esperada |
|---|---|---|
| 1 y 2 | A v1: 100; B v1: 200, ambos 1 de octubre | Total 300 |
| 3 y 4 | A v2: 120; C v1: 50 del 30 de septiembre | Octubre 320; septiembre 50 |
| 5 y 6 | B v2 borrado; después B v1: 200 | Octubre 120; B sigue borrado |
| 7 y 8 | A v3: 130 del 2 de octubre; D v1: 40 ese día | Día 1 sin contribuciones; día 2 suma 170 |
La llegada tardía de C demuestra el problema de usar el máximo día de negocio como filtro de extracción. C pertenece a septiembre, pero ocupa una posición nueva, la 4. El laboratorio comprueba que su día no supera el 1 de octubre: ese filtro lo excluiría aunque todavía no estuviera procesado.
Esto no demuestra cómo extraer un CDC real. Sí permite explicar por qué necesitas un contrato de cursor o un mecanismo de reconciliación que capture correcciones tardías. Pide las garantías del origen antes de prometer que updated_at > último_valor basta.
Conserva identidad y contenido, no solo el último total
La fixture mantiene cuatro tablas. current_state conserva la última revisión por pedido, incluidos tombstones. versions guarda el contenido de cada identidad y revisión aceptadas. batches identifica rangos publicados y su hash. checkpoint contiene la posición publicada.
Conservar versiones antiguas permite detectar contradicciones incluso después de aceptar una revisión nueva: después de aceptar B v2 borrado, llega otra vez B v1 con importe 200. Es una versión antigua coherente y se consume sin resucitar B. Pero otra B v1 con importe 999 contradice la versión histórica; se rechaza el lote y se mantiene el checkpoint.
Si solo guardaras el estado v2, podrías ignorar cualquier v1 y perder evidencia de una fuente inconsistente. Nuestra elección de rechazar ese conflicto conserva una señal de calidad; otra política podría ponerlo en cuarentena, pero necesitaría explicar su efecto sobre avance y completitud.
El hash de batches identifica el contenido de ese rango, no toda la ejecución. Aquí representan JSON canónico del lote, con orden de filas y campos definidos por el programa. No equivalen automáticamente al hash de un CSV remoto, ni identifican una versión de transformación. Para reproducir una salida real, registra además el contrato y el código que la generaron.
Escribe un UPSERT condicionado por versión
Hecho oficial. PostgreSQL documenta ON CONFLICT DO UPDATE, incluido un WHERE que condiciona la actualización. En nuestro programa, la clave única es event_id y la condición permite reemplazar únicamente una revisión menor:
INSERT INTO current_state VALUES (%s, %s, %s, %s, %s)
ON CONFLICT (event_id) DO UPDATE
SET rev = excluded.rev,
    day = excluded.day,
    amount = excluded.amount,
    deleted = excluded.deleted
WHERE excluded.rev > current_state.rev;
Los parámetros corresponden a identidad, revisión, día, importe y marca de borrado. El control de contenido contradictorio ocurre antes, dentro de la misma transacción, consultando versions. La condición del UPSERT no sustituye esa validación.
Después del lote (2,4], A pasa de 100 a 120 y C añade 50 a septiembre. B sigue aportando 200 aunque no aparezca en ese delta. Comprobamos ambos días y el importe de B: un total global correcto por casualidad no prueba que las particiones sean correctas.
En el lote final, A cambia de día. El agregado consulta el estado vigente, por lo que deja de contribuir al día 1 y aporta 130 al día 2. Un diseño que actualizara solo el nuevo agregado podría dejar 120 colgados en el día anterior. Si materializas totales, incluye ambas particiones en la corrección.
Un tombstone conserva la barrera contra versiones antiguas
B v2 contiene deleted=true y amount=NULL. No desaparece de current_state: el agregado filtra las filas borradas. Cuando llega B v1, la revisión 1 no supera la 2 y el estado de B permanece borrado. El checkpoint, sin embargo, avanza hasta 6 porque esa entrada coherente sí fue procesada.
El programa reproduce el diseño defectuoso en una tabla aparte: elimina físicamente B v2 y luego inserta B v1. B reaparece con 200. Que la reproducción del defecto pase una comprobación no convierte esa reaparición en un resultado correcto de negocio.
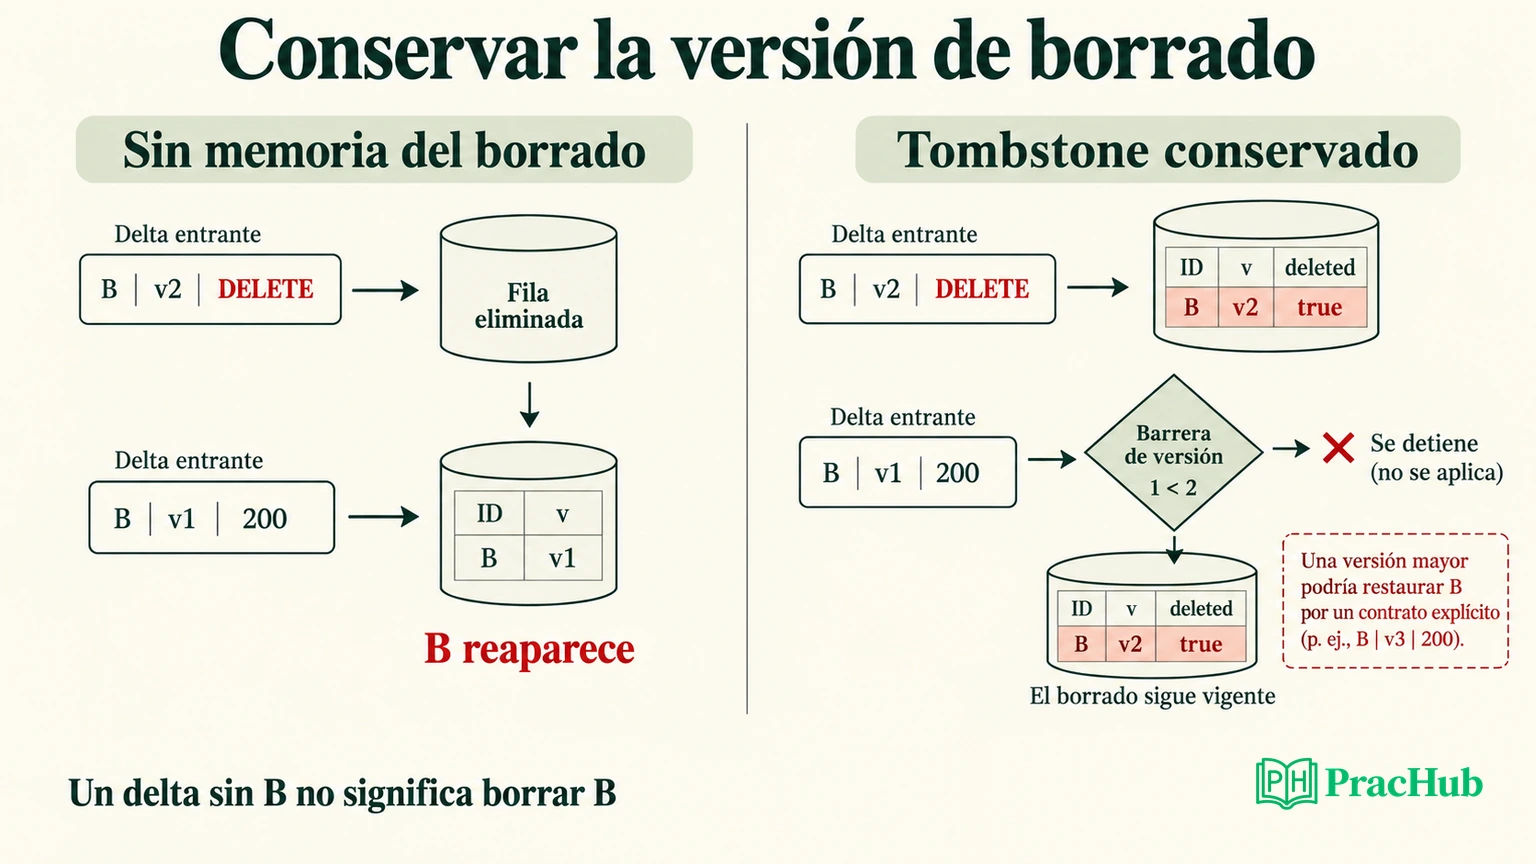
Inferencia de diseño: conserva suficiente memoria de versión durante el horizonte de replay. No implica guardar tombstones para siempre ni que B nunca pueda volver: una revisión superior podría restaurarlo si el contrato lo permite. Esa restauración no se ejecuta en nuestra fixture.
Antes de decidir retención, pregunta cuánto puede retrasarse o repetirse el origen y cómo se reconstruye una partición. El borrado lógico no resuelve por sí solo obligaciones de eliminación de datos personales; el ejemplo usa identidades ficticias y no diseña esa política.
Publica datos y checkpoint en la misma transacción
Hecho oficial. Las transacciones PostgreSQL agrupan operaciones con commit o rollback. Aquí versions, current_state, batches y checkpoint están en la misma base y transacción. El checkpoint significa «publicado», no simplemente «leído».
Inyectamos una excepción después de cambiar el estado, antes de escribir manifiesto y checkpoint. Otra excepción aparece después de actualizar ambos, todavía antes del commit. En ambos intentos, checkpoint queda en 6, A conserva v2 y no aparece D; los recuentos de versiones y lotes también permanecen iguales.
La reanudación publica después las posiciones 7 y 8. El checkpoint llega a 8, los pedidos activos son A, C y D, y B permanece como cuarta identidad tombstone. Hay siete revisiones distintas y cuatro rangos publicados; son medidas diferentes, no cuatro maneras de contar lo mismo.
Abrimos otra conexión y verificamos checkpoint 8 y B v2 borrado. Eso demuestra visibilidad del commit en esta ejecución. No apagamos el servidor durante una escritura, no simulamos pérdida eléctrica ni verificamos un mecanismo externo de recuperación durable.
Distingue replay, hueco y conflicto antes de avanzar
El mismo rango con el mismo hash devuelve replay. Por eso repetir (0,2] no transforma 300 en 600, y repetir el rango final después del commit tampoco duplica datos. Un rango idéntico con contenido diferente se rechaza.
Un lote nuevo debe empezar en el checkpoint actual y presentar exactamente las posiciones siguientes del contrato. La fixture rechaza un salto de checkpoint y un lote que omite una posición. Estos controles evitan interpretar un avance incompleto como una publicación válida.
No traslades la comprobación de posiciones contiguas a otro origen sin adaptarla. Algunos sistemas usan offsets por partición, tokens opacos o rangos que legítimamente contienen huecos. En entrevista, explica qué significa «sin perder entradas» según ese origen y cómo probarías el siguiente cursor.
La documentación de aislamiento PostgreSQL describe garantías que dependen del nivel utilizado. Nuestro laboratorio procesa un worker secuencial: leer checkpoint no reserva por sí solo el derecho exclusivo de publicar. No hemos probado dos workers compitiendo ni una solución de locking para ellos.
Explica la frontera de recuperación y el siguiente experimento
Hecho oficial. Las buenas prácticas de Airflow recomiendan tareas reproducibles y entradas ligadas a particiones concretas. Aplicación al caso: conserva las entradas y la transformación de cada rango para poder repetirlo sin que «latest» cambie entre intentos. Aquí no lanzamos un DAG.
Si el destino fuera object storage y el checkpoint estuviera en PostgreSQL, nuestra transacción ya no englobaría ambas escrituras. Propón una publicación versionada que los lectores entiendan, pero deja pendientes las garantías del mecanismo elegido y la conciliación de salidas abandonadas.
Para extender el ejercicio, elige una sola frontera: dos workers sobre el mismo checkpoint, una salida externa o una política de retención. Define primero el estado correcto tras la nueva falla. Antes de añadir un retry, predice si la repetición conservará, duplicará o perderá datos.
El paquete reproducible incluye pipeline.py, source.json, results.json y README. Se ejecutó con CPython 3.12.14, psycopg 3.3.6 y PostgreSQL 18.6. Necesita un cluster local desechable y BLOG_LAB_DSN explícito; limpia su propio schema temporal. No aporta métricas de carga, costes ni rendimiento de una arquitectura de producción.
Practica cinco variantes con preguntas completas
Los siguientes destinos verificados son material reportado de práctica. Cambian los requisitos y permiten defender tu contrato sin atribuir a sus empresas un proceso de selección actual.
| Pregunta completa | Qué variante introducir |
|---|---|
| Design batch and streaming ETL architecture | Explicar cuándo publicar y cómo representar el avance. |
| Load Daily JSONL LLM Chat Logs Into a Warehouse: Schema, Validation, Dedup, Idempotency | Separar identidad del archivo, registro y lote. |
| Build a One-Pass Data Cleaning Pipeline | Elegir qué validar antes de publicar parcialmente. |
| Defend a Data Pipeline Architecture and Its Trade-offs | Justificar memoria de versiones y coste de retención. |
| Design a Data Service for Downstream Consumers | Definir qué estado y retraso puede aceptar el consumidor. |
Continúa con Load Daily JSONL LLM Chat Logs Into a Warehouse: Schema, Validation, Dedup, Idempotency. Cambia una sola regla del dossier y predice resultado, checkpoint y revisiones conservadas antes de ejecutar. Separa el resultado SQL observado de las garantías pendientes sobre concurrencia, origen real y publicación externa.
Comments (0)