Entrevista Data Scientist: explica validación, métricas y fuga de datos con un caso práctico
Quick Overview
ActualCPython3.12.14/sklearn1.7.2/NumPy2.5.3 27checks.20customers/tworepeatedobservations rowcontrolledsplitshares20/accuracy100 vsGroupKFold4shuffle7overlap0/outoffold40accuracy45; futurelabel-identicalfieldtreegroupCV100 despiteavailabilityNov1afterOct1. Separate16train8validation8testIDsdisjoint Pipelineimputer/scaler/logistic; fitmeanmedian3.5/count16unchanged; extra100all-data mean156/17 onlycontaminationnotaccuracyclaim. Validationthresholds.3/.5/.7cost6/5/10/cap5 selects.5 beforetestTP3FP1FN1TN3/precision-recall75/AUC.75. No temporalvalidation/calibration/fairness/CI/causalintervention/realchurnbenchmark.
Un modelo puede acertar el 100% de una validación y fallar la pregunta que querías responder. Si reconoce clientes que ya vio, o recibe una columna construida después del resultado, ese score evalúa una ventaja que quizá no exista al tomar la decisión futura.
Para preparar una entrevista Data Scientist, seguiremos dos experimentos sintéticos: separación de clientes y selección de umbral. Ejecutamos 27 comprobaciones con scikit-learn, incluyendo entrenamiento real y predicciones fuera de fold. La guía de entrevistas Data Science de PracHub conecta el caso con SQL, estadística y preguntas de negocio; aquí analizaremos qué valida cada resultado.
Evidencia y límites. Los conceptos citados son oficiales; datos, costes y decisiones son un ejercicio original. Las preguntas reportadas sirven para practicar, no para predecir una entrevista. No medimos churn real, efecto de una campaña, calibración ni generalización temporal. Separaremos observación del laboratorio e inferencia de preparación.
Define primero qué significa una predicción futura
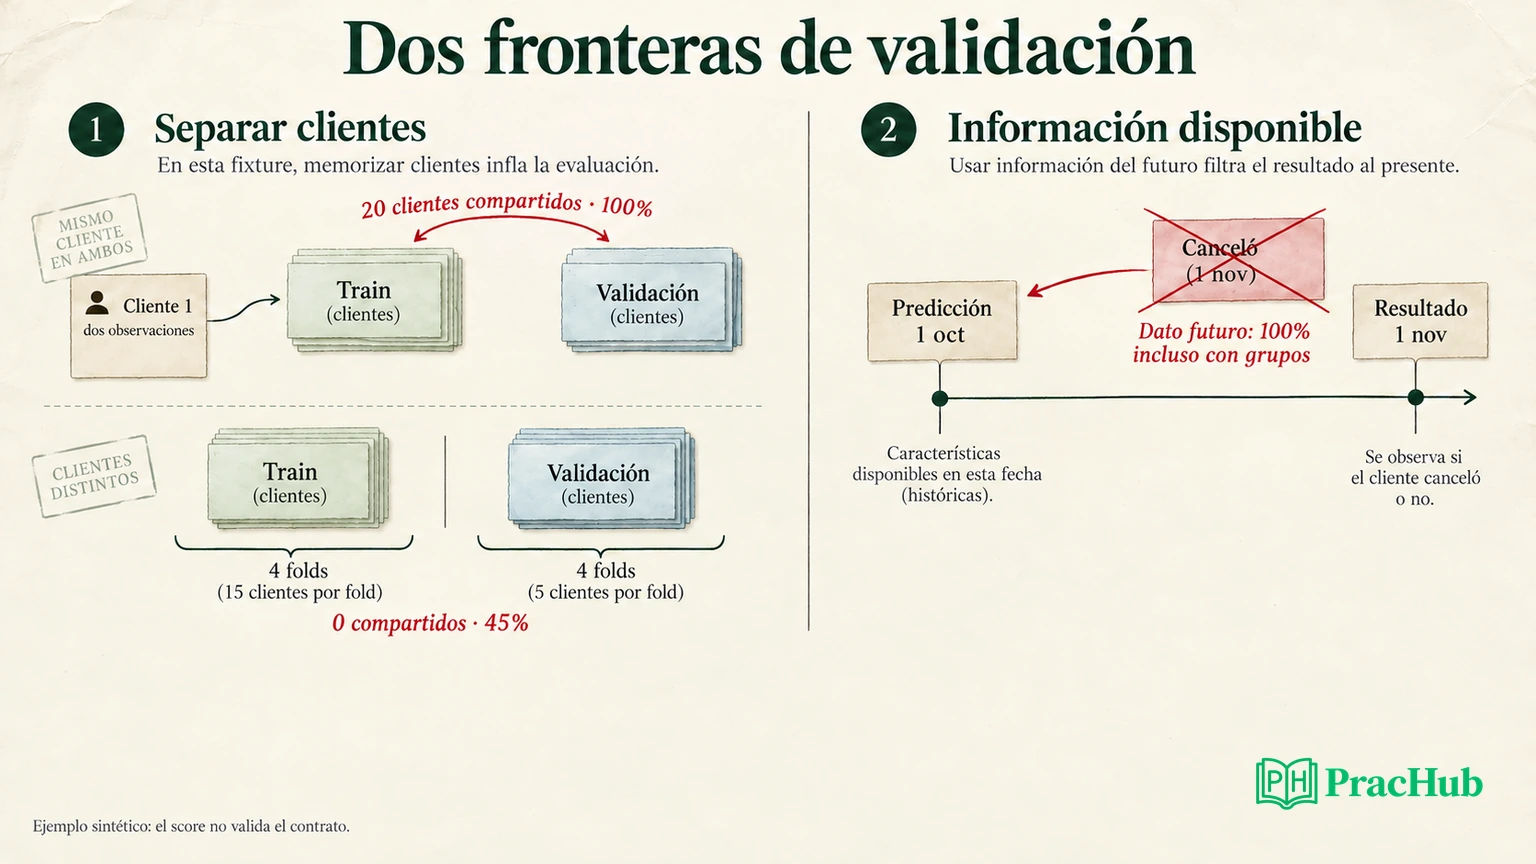
La pregunta ficticia es identificar riesgo antes de observar el desenlace. Fija unidad, momento de predicción, horizonte y decisión posible. En el ejemplo de disponibilidad, la predicción se sitúa el 1 de octubre y el campo posterior solo está disponible el 1 de noviembre.
No basta con llamar a una columna historical. Necesitas saber qué valor podía consultar el sistema en ese instante. Un evento antiguo puede llegar tarde; una tabla actual puede haber sobrescrito el estado que existía durante el entrenamiento histórico. El timestamp del evento y el de disponibilidad responden a preguntas distintas.
También define a quién necesitas generalizar. ¿Predices otra observación de clientes conocidos o el resultado de clientes nuevos? Tener un cliente a ambos lados no es siempre un error por definición; depende del uso. Nuestro primer experimento exige evaluar identidades no vistas y construye deliberadamente una división que incumple esa condición.
Hecho oficial. La documentación de scikit-learn sobre errores frecuentes describe leakage cuando información no disponible al predecir influye en el modelo. Aplicación al caso: auditar columnas y separación exige contrastarlas con el contrato de decisión, no solo con una función que divide arrays.
Reproduce el atajo antes de cambiar de algoritmo
Creamos 20 clientes, cada uno con dos observaciones y una etiqueta constante. Los identificadores pares tienen una clase y los impares otra. Son datos elegidos para hacer visible la memorización; no representan una distribución de clientes de una empresa.
El primer split coloca la observación par de cada cliente en train y la impar en validación. Los índices de train y validación no se repiten; aun así, las dos partes contienen a los mismos 20 clientes. Es una separación controlada por índice, no una ejecución de train_test_split aleatorio.
Entrenamos una Pipeline con OneHotEncoder del identificador y un vecino más cercano. Cada cliente validado tiene una representación idéntica en train. La accuracy observada es 100%: el modelo dispone del atajo que construimos.
Ese resultado no muestra que 1NN sea una buena solución para churn ni que cualquier split por filas produzca siempre 100%. Demuestra que «las filas no se repiten» no verifica independencia a nivel cliente. Un split aleatorio también debe auditar esa unidad, aunque nuestro programa no lo haya ejecutado.
En entrevista, muestra la intersección de customer_id junto al score. Cambiar únicamente a un clasificador más sofisticado puede dejar intacta la misma frontera incorrecta. Busca el atajo: qué información permite acertar sin aprender la relación futura que necesitas evaluar.
Agrupa clientes y vuelve a medir el mismo modelo
Hecho oficial. GroupKFold construye folds donde los grupos de validación no aparecen en entrenamiento. En el laboratorio usamos cuatro folds, shuffle=True y random_state=7: cada fold entrena con 15 clientes y valida con 5.
Para cada fold comprobamos intersección cero tanto de clientes como de índices. cross_val_predict produce una predicción fuera de fold para cada una de las 40 observaciones. La accuracy agregada del mismo tipo de modelo baja a 45%.
El encoder ignora categorías desconocidas. Por eso, un identificador nuevo ya no encuentra su copia exacta entrenada. El 45% describe este pequeño conjunto, esta partición y este estimador. No es una estimación del rendimiento universal de separar por grupos, ni una prueba estadística de que sea peor que azar.
| Experimento controlado | Clientes compartidos por fold | Accuracy observada |
|---|---|---|
| Split por observación par/impar, identidad como feature | 20 en la división única | 100% |
| Mismo tipo de modelo, GroupKFold | 0 | 45% en las 40 predicciones fuera de fold |
| Campo posterior idéntico a label, GroupKFold | 0 | 100% |
Agrupar protege una frontera de identidad. Si el despliegue predice meses posteriores, falta una frontera temporal. Si entrenas sobre compañías y atiendes nuevas compañías, quizá el grupo pertinente sea organización, no usuario. Explica qué entidad puede compartir información y por qué.
Una columna futura sigue filtrándose dentro de los grupos
El tercer recorrido entrega a un árbol una sola feature: post_outcome_cancelled, construida exactamente igual que la etiqueta. Mantenemos GroupKFold. La accuracy vuelve a 100%, incluso con cero clientes compartidos en cada fold.
El código también compara fechas y comprueba que la disponibilidad declarada del campo posterior supera la fecha de predicción. Esta comprobación es una regla sobre nuestra fixture; no inspecciona por sí sola un almacén de features ni reconstruye disponibilidad real.
El resultado explica por qué GroupKFold no certifica ausencia de fuga. Tampoco lo hará una Pipeline que contenga esa columna. Puedes ajustar correctamente cada transformación dentro de train y seguir entregando una respuesta futura al estimador.
Inferencia de preparación: presenta un catálogo breve con nombre, significado, evento de origen y momento de disponibilidad. Para una variable sospechosa, pide un snapshot histórico y verifica el join temporal. Verificar esa disponibilidad evita entrenar con un valor que el servicio todavía no podría consultar.
Ajusta el preprocesamiento solo con entrenamiento
En un segundo caso independiente construimos 16 observaciones de train, 8 de validación y 8 de test, con identidades disjuntas. La única feature es un riesgo numérico sintético. No reutilizamos las dos observaciones por cliente del caso de memorización.
Hecho oficial. Pipeline encadena transformaciones y estimador. Nuestra secuencia es SimpleImputer, StandardScaler y LogisticRegression. Solo llamamos fit con las 16 filas de entrenamiento; predict_proba transforma validación y test sin volver a ajustar.
El recibo confirma mediana 3,5 para el imputador, media 3,5 para el escalador y 16 filas vistas por este. Después de predecir validación y test, la media sigue en 3,5 y el contador en 16. Aquí no hay ausentes: la comprobación registra qué aprendió el imputador, pero no evalúa una estrategia de imputación bajo missingness real.
Un contraste aparte ajusta un escalador con train y un punto reservado de valor 100. La media cambia a 156/17. Eso demuestra que el preprocesamiento absorbió información de fuera de train. No medimos cuánto cambia la accuracy por ese error; no atribuyas a ese contraste un efecto que no calculamos.
Elige el umbral según una decisión explícita
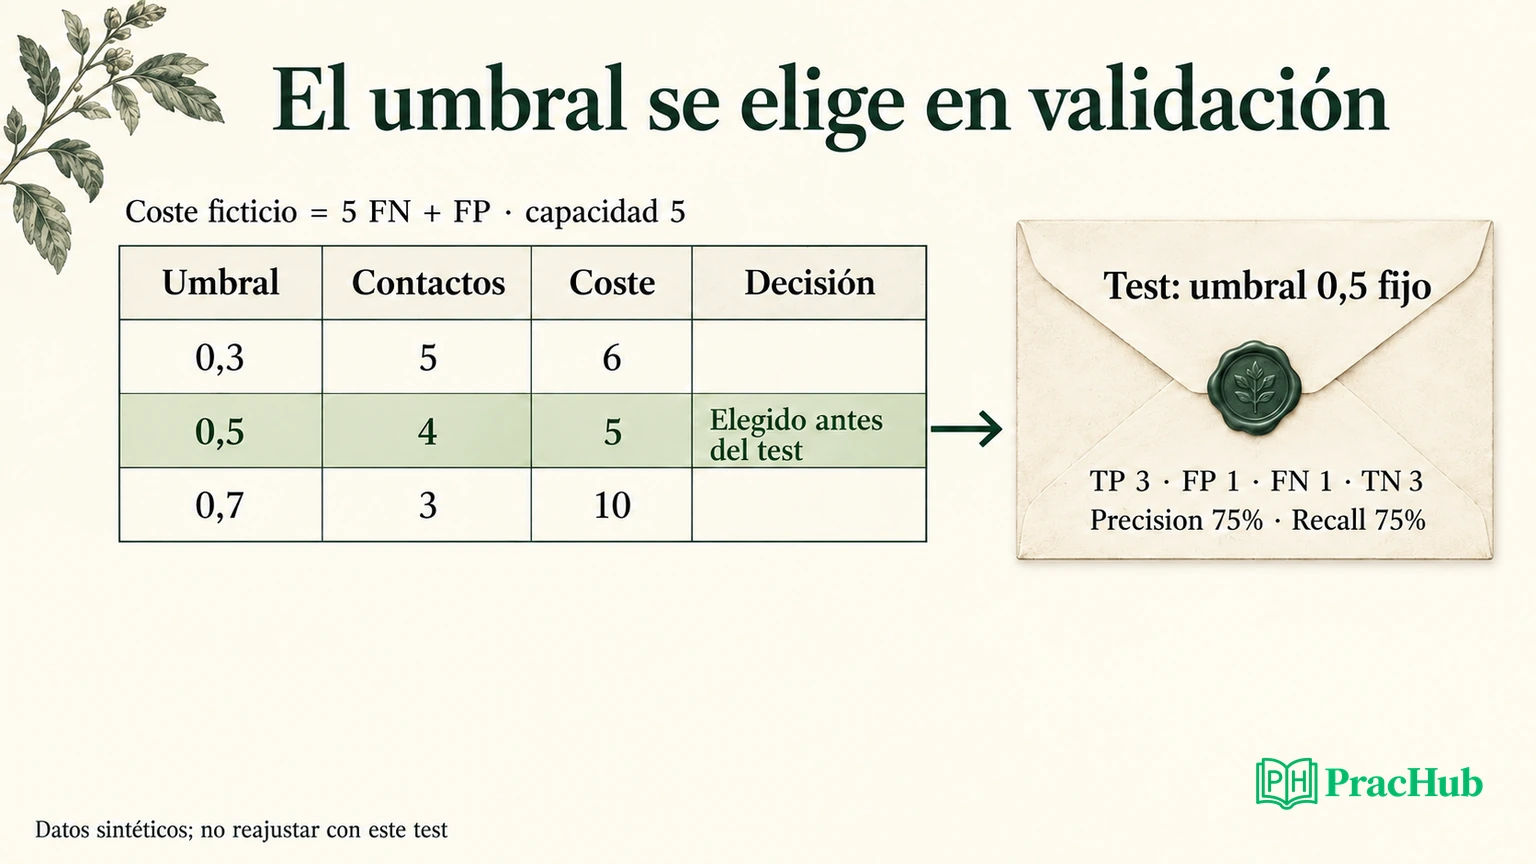
El modelo produce scores; la decisión aplica score >= umbral. Fijamos una regla ficticia: coste de cinco unidades por falso negativo y una por falso positivo, con capacidad máxima de cinco contactos en validación. No es una estimación financiera ni una regla de una empresa.
Probamos únicamente 0,3, 0,5 y 0,7 con las ocho etiquetas de validación. Los resultados son:
| Umbral | TP / FP / FN / TN | Contactos | Coste 5 × FN + FP |
|---|---|---|---|
| 0,3 | 4 / 1 / 1 / 2 | 5 | 6 |
| 0,5 | 4 / 0 / 1 / 3 | 4 | 5 |
| 0,7 | 3 / 0 / 2 / 3 | 3 | 10 |
Los tres caben en esa capacidad; 0,5 tiene el menor coste entre los candidatos. El mínimo observado solo compara 0,3, 0,5 y 0,7 bajo el coste y la capacidad definidos. El programa deja fijado ese valor antes de calcular las métricas finales de test.
Si cambias el coste o la capacidad, vuelve a evaluar candidatos dentro del procedimiento de selección. No justifiques la elección porque «0,5 es estándar»: aquí coincide con la decisión elegida por nuestra tabla, no con una garantía general sobre probabilidades.
Abre el test para evaluar la decisión ya fijada
Con 0,5 fijo, las ocho filas de test producen TP=3, FP=1, FN=1 y TN=3. Precision y recall son 75%; accuracy también es 75%. El coste ficticio es 6 y seleccionamos cuatro contactos.
Hecho oficial. Las definiciones de métricas de scikit-learn distinguen aciertos totales, proporción correcta entre positivos seleccionados y cobertura de positivos reales. En esta matriz, precision es 3/(3+1) y recall es 3/(3+1); coinciden por los números del caso, no porque sean equivalentes.
El código calcula además ROC-AUC de 0,75. Ese resumen de ranking no decide por sí solo cuántas personas contactar. Tampoco convierte los scores en probabilidades calibradas ni mide el beneficio causal de intervenir. Esas preguntas requieren otra evidencia.
El autor conoce estos datos sintéticos; la separación es procedimental: test no interviene en fit ni en la elección del umbral. No presentamos un estudio ciego. No reajustamos después de ver el resultado ni usamos sus ocho filas para anunciar intervalos de confianza o performance real.
Usa un baseline que revele el error importante
Un tercer ejemplo aritmético, separado del modelo anterior, tiene 20 casos y solo dos positivos. Predecir siempre negativo obtiene 90% de accuracy y recall cero. Las comprobaciones verifican ambos valores; no hay entrenamiento en ese baseline.
La comparación explica por qué necesitas decir cuál es la clase relevante. Un resultado de accuracy alto puede dejar sin detectar precisamente los casos que motivaron el proyecto. Sin embargo, tampoco debes declarar que recall máximo es siempre mejor: los falsos positivos pueden consumir capacidad o perjudicar una operación.
Antes de recomendar un modelo, pide prevalencia, costes, capacidad y disponibilidad de etiquetas. Si las labels maduran tarde, define cuándo la evaluación puede considerarlas observadas. Si esperas clientes repetidos en producción, revisa qué datos históricos están legítimamente disponibles y qué generalización quieres medir.
No prometas que identificar una cancelación equivale a evitarla. Nuestro coste es una regla para comparar decisiones de clasificación; no estima efecto de retención, ingresos salvados ni una política óptima de campaña. Una pregunta causal cambia el problema y las pruebas necesarias.
Defiende el protocolo y sus límites con un recibo
El laboratorio descargable contiene evaluate.py, dependencias, datos de grupos, tabla de umbrales, resultados y README. Se ejecutó con CPython 3.12.14, scikit-learn 1.7.2 y NumPy 2.5.3. Las referencias enlazadas usan la documentación 1.7 para alinear los mecanismos con el runtime probado.
Las 27 comprobaciones cubren intersecciones, memorización, campo posterior, parámetros aprendidos y reglas de decisión. Los números pequeños son útiles para rastrear cada error; no bastan para comparar modelos en una población real. No ejecutamos fairness audit, evaluación temporal, calibración, intervención ni monitorización de despliegue.
Una respuesta técnica defendible recorre tarea, disponibilidad, unidad de split, ajuste y selección antes del score final. Si el entrevistador cambia de clientes nuevos a clientes conocidos, explica qué frontera cambia y qué riesgo permanece. Al cambiar la población futura, revisa el split y explica qué control de disponibilidad sigue siendo necesario.
Practica cinco preguntas y cambia una premisa
Estos destinos verificados son material reportado de práctica, sin afirmar formato o frecuencia actuales de contratación. Cada uno permite añadir una condición al protocolo del laboratorio.
| Pregunta completa | Condición que conviene defender |
|---|---|
| Evaluate Classifier with Precision, Recall, and Fairness Metrics | Qué análisis adicional falta antes de hablar de fairness. |
| Evaluate Fake-Account Classifier with Precision and Recall Metrics | Cómo capacidad y clase relevante cambian la decisión. |
| Detect Data Leakage in Supervised Learning Pipelines | Por qué grupos y disponibilidad son controles distintos. |
| Design leakage-free predictive maintenance pipeline | Qué entidad agrupar y cuándo está disponible cada señal. |
| Evaluate Product-Ranking Algorithm with Precision and Recall Metrics | Qué cambia al pasar de clasificar a ordenar candidatos. |
Empieza por Detect Data Leakage in Supervised Learning Pipelines. Presenta los tres scores de la tabla y explica qué contrato viola cada atajo. Fija el umbral con validación antes de abrir test; para un uso posterior, añade una evaluación temporal que este laboratorio no ejecuta.
Comments (0)