Entrevista DevOps: practica un despliegue fallido y una recuperación segura
Quick Overview
RealPG18.6/psycopg3.3.6/CPython3.12.14 30checks: rename/dropoldcolumn42703; expandeddualwrite, oldinsertNULLfallbackuseful butoldupdate nonnullstaleCOALESCEwrong; narrowNOLOGINrole REVOKE42501/readretained; explicitlegacy-authorityreconcile/NOTNULL/contract. TwosessionDDLreaderblocksALTER/100ms55P03/noaddedcolumn/releaseDDLworks. SQLclientsnotbinaries/noKubernetescanaryproductionrecoveryloadbackuprestoreproof.
«Volver a la imagen anterior» puede dejar el servicio igual de roto si la base de datos ya cambió. En una entrevista DevOps, la recuperación necesita una condición más concreta: la versión elegida debe poder ejecutar las operaciones necesarias sobre el estado que existe ahora, con valores correctos y permisos compatibles.
Practicaremos ese razonamiento con una migración de customer_name a display_name. El laboratorio ejecuta 30 comprobaciones en PostgreSQL: consulta antigua rota, lectura aparentemente compatible pero obsoleta, restricción de un escritor y espera de DDL. La guía de entrevistas DevOps de PracHub conecta este ejercicio con CI/CD e incidentes; aquí nos centraremos en la decisión de recuperación.
Límite de evidencia. La documentación oficial respalda los mecanismos citados. v1 y v2 nombran clientes SQL del laboratorio, no binarios desplegados. No ejecutamos Kubernetes, un canario ni una recuperación de producción. Las decisiones propuestas son inferencias; las preguntas públicas son material reportado de práctica, sin afirmar procesos actuales de contratación.
Empieza por la operación afectada y el cambio completo
El dossier sintético plantea que un cambio introduce display_name y aparece un error de columna en un lector antiguo. Antes de ejecutar comandos, distingue qué operación falla: leer perfiles, modificarlos o crear nuevos. Que una lectura termine sin error no demuestra que devuelva el valor correcto después de una actualización antigua.
Recupera la versión del programa, configuración y migración aplicadas. El commit del repositorio no identifica por sí solo el esquema vigente. También pregunta qué productores siguen activos: instancias antiguas, jobs, consumidores y scripts pueden escribir después de que el tráfico visible haya cambiado.
Inferencia para el incidente: detener la expansión limita cambios adicionales mientras confirmas impacto y compatibilidad. No presenta la recuperación como terminada ni restablece datos. Explica qué operación protegerías temporalmente, quién tomaría esa decisión y qué observación permitiría reanudarla.
En vez de «haría rollback», puedes comenzar: «Primero compruebo la operación y el esquema actuales; después pruebo si el contrato anterior todavía sirve». Después muestra qué consulta y qué valor permitirían aceptar o descartar esa hipótesis.
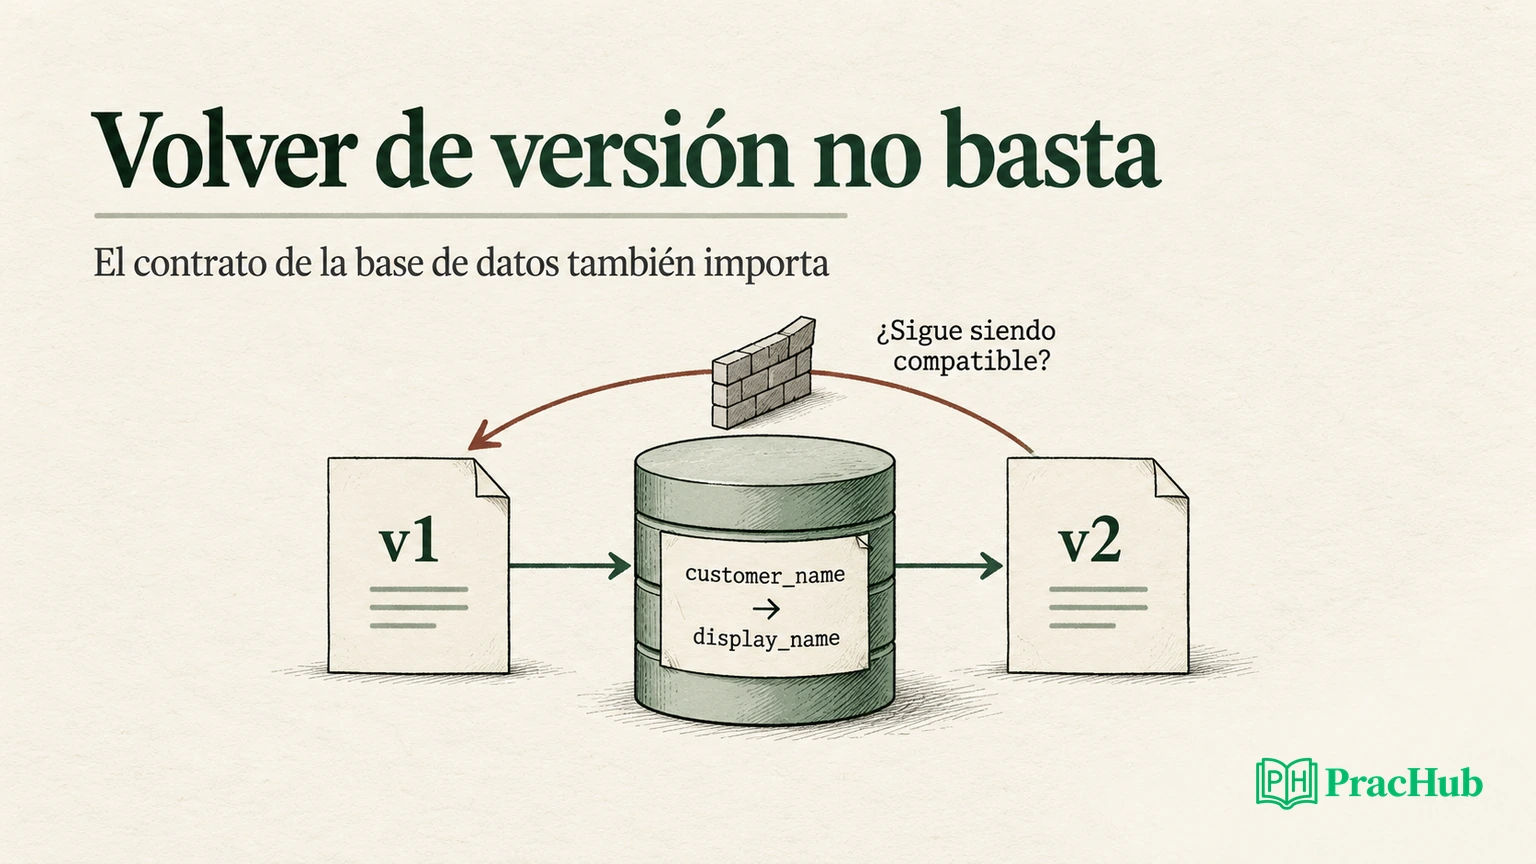
El rollback del cliente no revierte una columna renombrada
Hecho oficial. PostgreSQL documenta los cambios de tabla, incluidos renombrar y retirar columnas. En el primer recorrido de la fixture, una tabla contiene customer_name con Ana. El cliente v1 consulta ese campo y obtiene Ana.
Renombramos customer_name a display_name. La consulta v2 al nuevo campo obtiene Ana; ejecutar otra vez la consulta v1 falla con SQLSTATE 42703, undefined_column. El dato no desapareció en ese rename, pero el nombre que solicita v1 dejó de existir.
Ese error explica por qué restaurar únicamente el cliente antiguo no basta para este contrato. No hemos simulado un balanceador ni arrancado una imagen: hemos comprobado la incompatibilidad SQL que esa versión tendría que resolver.
También evita una intervención precipitada. Renombrar de vuelta puede romper clientes nuevos que ya esperan display_name. La recuperación debe enumerar qué versiones necesitan funcionar a la vez y qué escrituras se han realizado, antes de modificar nuevamente el esquema compartido.
Expandir mantiene opciones; no sincroniza datos automáticamente
El segundo recorrido conserva customer_name y añade display_name nullable. El lector antiguo sigue funcionando. El lector de transición consulta COALESCE(display_name, customer_name): cuando el campo nuevo está vacío, obtiene Ana desde el antiguo.
Un escritor de transición actualiza ambos campos a Ana Maria en una sola sentencia. Las comprobaciones de ambas lecturas devuelven Ana Maria, el valor escrito en los dos campos. Hasta aquí, la expansión mantiene dos contratos de lectura y una escritura dual verificadas en esta fixture.
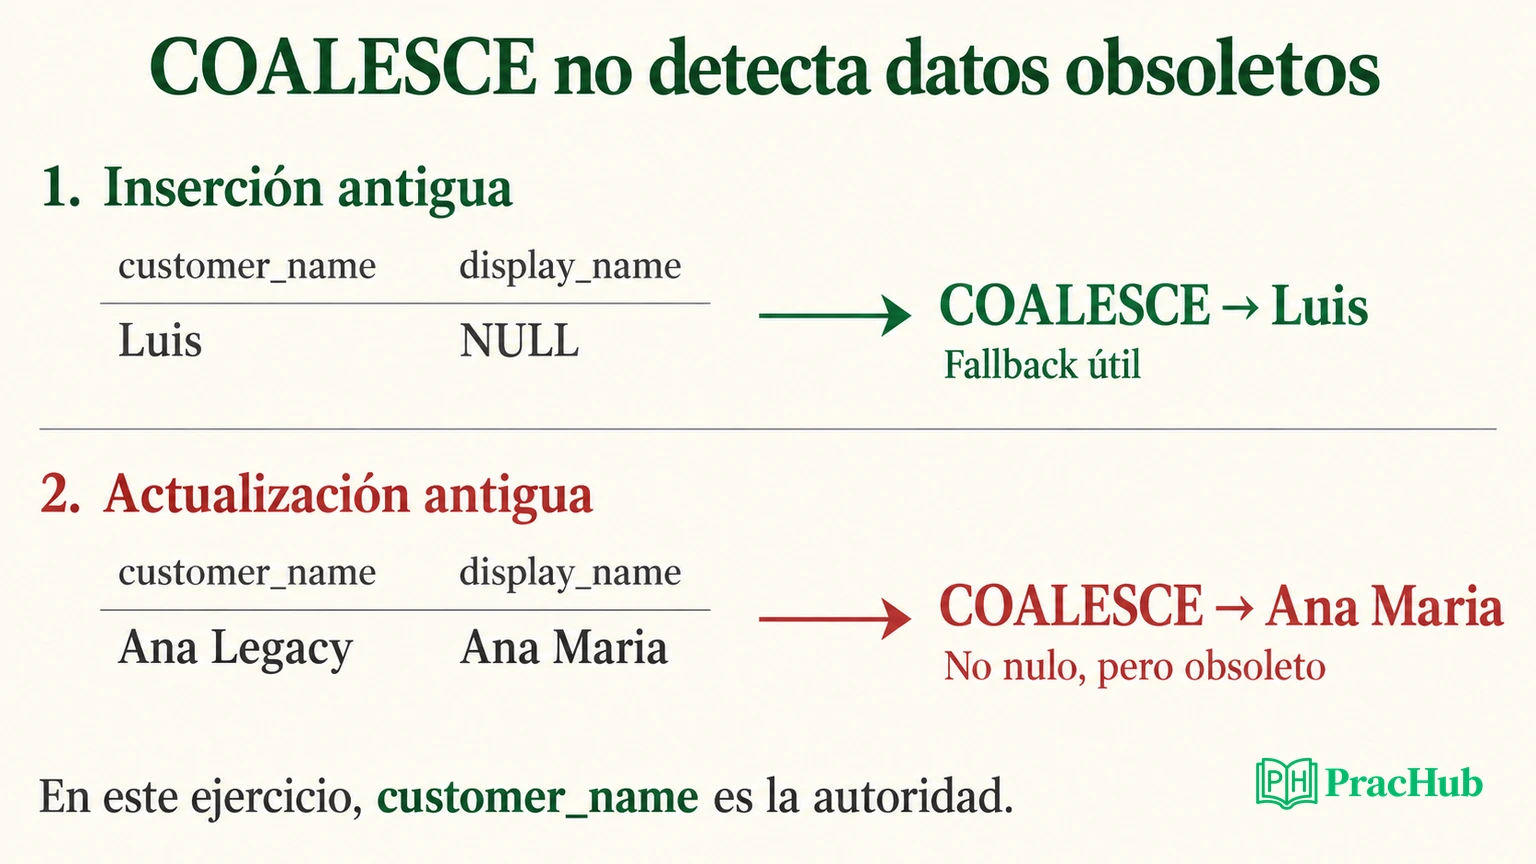
Después ejecutamos un backfill de los valores nulos. La comprobación encuentra cero display_name nulos, pero un escritor antiguo todavía puede insertar el perfil Luis rellenando solo customer_name. La nueva columna vuelve a quedar nula; el lector con fallback obtiene Luis, mientras una lectura estricta del campo nuevo no tendría ese valor.
El resultado enseña una frontera temporal: «backfill terminado» describe un instante, no una propiedad permanente cuando quedan productores que utilizan el formato anterior. Identificar esos productores evita declarar terminado el backfill mientras siguen creando valores nulos o divergentes.
COALESCE no detecta un valor nuevo que ya quedó obsoleto
El contraejemplo más importante utiliza una actualización, no una inserción. Tras la escritura dual, display_name contiene Ana Maria. El escritor antiguo modifica únicamente customer_name a Ana Legacy. Ahora ambos campos son no nulos y distintos.
SELECT customer_name, display_name,
       COALESCE(display_name, customer_name)
FROM profiles
WHERE id = 1;
El laboratorio devuelve Ana Legacy, Ana Maria y Ana Maria. COALESCE elige el primer valor no nulo; no conoce cuál se actualizó después ni cuál debe prevalecer. La consulta funciona sin excepción, pero la nueva lectura puede mostrar un nombre obsoleto respecto al contrato que hemos definido.
En este ejercicio, customer_name sigue siendo la autoridad hasta la transición explícita. Esa elección permite juzgar Ana Maria como obsoleto. En un sistema real tendrías que definir autoridad, versiones o reglas de conflicto antes de reconciliar; no copies ciegamente una columna sobre otra.
Una matriz que solo diga «SELECT pasa» perdería este fallo. Añade los valores esperados después de insertar y actualizar con cada productor todavía permitido. Si el entrevistador introduce una nueva escritura, revisa tu conclusión de compatibilidad.
| Estado comprobado | Operación | Resultado observado |
|---|---|---|
| Columna renombrada | Lectura v1 | Error 42703 |
| Esquema expandido | Escritura dual y ambas lecturas | Ana Maria en ambos campos |
| Backfill seguido de inserción antigua | Fallback de v2 | Luis desde customer_name |
| Actualización antigua sobre valor nuevo no nulo | Fallback de v2 | Ana Maria; customer_name ya es Ana Legacy |
| Columna antigua retirada | Lectura v1 | Error 42703 |
Limita el escritor observado antes de reconciliar
La fixture crea un rol NOLOGIN dedicado que representa un camino antiguo. Verificamos que puede leer. Después retiramos INSERT y UPDATE sobre la tabla: esos intentos fallan con 42501, insufficient_privilege, y el número de filas no cambia. SELECT sigue funcionando.
Es una barrera estrecha, comprobada sobre ese rol. No demuestra que todos los productores de una aplicación hayan terminado, ni bloquea mágicamente al propietario o a roles con otros privilegios. En entrevista, nombra ese alcance y pregunta por las identidades restantes antes de declarar el sistema protegido.
La lectura antigua conservada tampoco significa que hayas recuperado el servicio antiguo completo. Sus escrituras ahora están rechazadas. Si propones una fase de solo lectura como mitigación, debes explicar su impacto para el usuario; no ocultarlo detrás de «rollback seguro».
Con la autoridad definida para el ejercicio, reconciliamos display_name desde customer_name donde son distintos, incluidos los nulos. Comprobamos cero nulos, cero pares divergentes y el mismo conjunto Ana Legacy/Luis en ambas lecturas. Una nueva inserción dual de Noa conserva la igualdad.
Finalmente aplicamos NOT NULL al campo nuevo y retiramos el antiguo. La lectura nueva devuelve los tres nombres; v1 vuelve a fallar con 42703. La contracción cierra deliberadamente esa ruta de vuelta. Pospón esa retirada si todavía necesitas conservar la opción de recuperar el lector v1.
Una migración pequeña también puede esperar un bloqueo
Hecho oficial. PostgreSQL describe los modos de bloqueo de tabla, sus conflictos y su duración transaccional. Muchos cambios DDL necesitan un bloqueo incompatible con lecturas activas. El tipo concreto de operación importa.
Una conexión mantiene abierto el bloque transaccional tras leer profiles; otra intenta añadir audit_marker mediante ALTER TABLE, con lock_timeout de 100 milisegundos. El DDL falla con 55P03 y comprobamos que la columna no apareció. Al finalizar la transacción lectora, repetir el DDL permite añadirla.
No medimos una duración de migración de producción. El límite de 100 milisegundos pertenece al experimento, no es un valor recomendado para cualquier servicio. La observación es que el cambio necesitó un bloqueo que el lector todavía impedía obtener.
Inferencia operativa: antes de ampliar el timeout, identifica quién conserva la transacción y qué ocurriría si muchas peticiones se acumularan detrás del DDL. Elige una política de espera y reintento acorde al servicio. Una sentencia corta no demuestra por sí sola una intervención sin impacto.
Canario y rollback responden a preguntas diferentes
Hecho oficial. El SRE Workbook de Google presenta el canario como exposición parcial y evaluación frente a un control para decidir la continuación. Aplicación al caso: observar una fracción del tráfico puede ayudar a detectar una regresión, pero una migración sobre una base compartida puede afectar también al cliente antiguo fuera de esa fracción.
Por eso pregunta cuál es la unidad aislada: procesos, tráfico, tenant, esquema o base. Un porcentaje de tráfico reducido no garantiza que un rename tenga el mismo alcance reducido. Aquí no ejecutamos un canario; identificamos la dependencia compartida que esa estrategia tendría que considerar.
Hecho oficial distinto. Los Deployments de Kubernetes gestionan revisiones de la plantilla de Pods y su rollout. Volver a una revisión de esa plantilla no constituye una restauración automática de datos externos. Tampoco ejecutamos rollout undo en este laboratorio.
La decisión propuesta debe indicar qué conserva: binario, configuración, contratos de mensajes y esquema. Si v1 ya no puede operar, una corrección hacia delante o una contención temporal pueden ser candidatas a evaluar. No hay una respuesta universal sin conocer esos contratos.
Verifica recuperación con datos y operación de usuario
La monitorización de sistemas distribuidos de Google SRE ofrece el contexto para observar errores, latencia, tráfico y saturación. Inferencia para el dossier: combina esas señales con la operación afectada y su contenido. Un lector que devuelve 200 con un nombre obsoleto exige otra comprobación además del porcentaje de errores.
Antes de reanudar expansión, define una lectura y una escritura representativas, qué valores deben conservar y qué productores pueden ejecutarlas. Segmenta las señales por versión cuando sea pertinente y observa volumen: ausencia de errores sin peticiones no valida una versión.
El laboratorio comprueba igualdad y restricciones en una base pequeña. No sustituye monitorización de usuarios, trabajo pendiente, restauración de backups ni conciliación exhaustiva de producción. Si esas pruebas faltan, presenta la recuperación como propuesta condicionada a verificarlas.
Practica con el recibo y cinco problemas relacionados
El paquete de migración incluye código Python, resultados, matriz de compatibilidad, dossier sintético y README. Se ejecutó con PostgreSQL 18.6, CPython 3.12.14 y psycopg 3.3.6. Necesita un cluster local desechable con permisos para crear schema y rol; el programa limpia sus objetos temporales.
Las 30 comprobaciones incluyen valores y SQLSTATE esperados. incident.csv es una secuencia pedagógica, no telemetría registrada de un despliegue. No extrapoles sus resultados a carga, todas las identidades de escritura o recuperación durable.
Material reportado de práctica. Estos destinos verificados de PracHub amplían la discusión de migraciones, sin atribuir a las empresas un proceso DevOps concreto.
| Pregunta completa | Qué defender con evidencia |
|---|---|
| Migrate a Continuously Used Database | Qué productores siguen operando durante cada fase. |
| Design a Database Migration Service with Replication and Bottleneck Analysis | Qué límites de la prueba pequeña necesitan otra medición. |
| Own Production Incidents and Validate Large Pipeline Migrations | Qué observación autoriza a declarar recuperada la operación. |
| Migrate a monolithic wallet to microservices | Qué datos y efectos no revierte una versión de aplicación. |
| Plan a Safe Repository-Wide Identifier Migration | Cómo reconocer consumidores todavía ligados al identificador anterior. |
Continúa con Migrate a Continuously Used Database. Dibuja lectores y escritores por fase, añade una actualización antigua después del backfill y explica qué resultado cambiaría tu decisión. Usa esa matriz para justificar una propuesta de recuperación; confirma después la operación real antes de declarar recuperado el servicio.
Comments (0)