Entrevista QA Automation: corrige una prueba inestable y explica tu estrategia
Quick Overview
ActualNode26.9 loopbackHTTP/CUA browser25observations; ambiguousBuscarstrictmode/scopedunique; originalgatedA/B staleHTTP200responseoverwrite; brokenAfirstfinalB vsBfirstfinalA; fixedgenerationsbothorders+BfirstrepeatfinalB. Two samebrowser tabs sharedstock201/409/reload409, separateownerboth201/resetBpreservesA409. NoPlaywrightTest/tracezip/freshcontexts/CIflake-rate/DB/payment/concurrencyproof.
Una prueba que falla y después pasa todavía necesita una explicación. Puede haber leído demasiado pronto, elegido un elemento ambiguo o descubierto un defecto real del producto. En una entrevista QA Automation, tu trabajo es mostrar qué evidencia distingue esas causas y qué cambio corrige la que has observado.
Aquí usarás un laboratorio original de búsqueda y reservas. Controlaremos el orden de dos respuestas HTTP y compararemos datos compartidos entre dos pestañas. La guía de Playwright y trazas de PracHub desarrolla el uso del framework; este caso se concentra en decidir si debes reparar el test, la aplicación o sus datos.
Límite de evidencia. Los hechos de Playwright se apoyan en documentación oficial. El laboratorio produjo 25 comprobaciones de observaciones mediante un navegador controlado y endpoints HTTP locales. No ejecutamos Playwright Test, no generamos trace.zip ni medimos estabilidad de CI. Los consejos son inferencias de preparación; las preguntas públicas son material reportado de práctica, sin prometer formatos ni preguntas futuras de contratación.
Conserva el primer fallo antes de cambiar las condiciones
El contrato de búsqueda es explícito: si el usuario solicita A y después B, el resultado final debe corresponder a B. Recibir HTTP 200 no identifica qué búsqueda muestra la pantalla: comprueba si el resultado final pertenece a B, la última solicitud.
Anota modo de la aplicación, identificador de ejecución, orden de solicitudes, orden de respuestas y resultado visible. La fixture permite liberar A o B desde botones separados, de modo que el mismo defecto puede reproducirse sin depender de una red lenta por casualidad. Elige una secuencia que permita distinguir tu hipótesis de otra causa.
Hecho oficial. Playwright documenta que un test puede pasar inicialmente, fallar y pasar al reintentarlo, o seguir fallando. Los reintentos pueden iniciar otro worker y repetir preparación. Por tanto, un intento verde no conserva necesariamente todas las condiciones del rojo.
Inferencia práctica: guarda el fallo inicial y trata el rerun como otra observación. Si cambias datos, selector y espera al mismo tiempo, quizá consigas verde sin saber cuál era la causa. En el laboratorio cambiamos una condición principal por comparación: orden, protección de respuesta o identificador de datos.
Un selector ambiguo se diagnostica antes de esperar
La página contiene dos botones Buscar: uno pertenece a Catálogo y otro a Diagnóstico. El locator global por role y nombre encuentra dos coincidencias. Al intentar el click, el control del navegador produce una violación de strict mode; no hace click silenciosamente en el botón incorrecto.
La comprobación registra dos coincidencias globales y una dentro de Catálogo; el click acotado inicia Buscando A. La región Catálogo distingue la búsqueda de productos del botón homónimo de Diagnóstico. Elegir first para evitar el error puede hacer que una modificación de orden cambie el objetivo sin avisarte.
Hecho oficial. Los checks de actionability de Playwright evalúan condiciones del objetivo antes de una acción, como visibilidad y disponibilidad para recibir eventos. No afirman que el negocio iniciado por el click haya terminado correctamente.
En esta fixture, el click correcto deja Buscando A y Sin resultado mientras la respuesta está retenida. La acción fue válida; todavía falta el resultado. Aumentar el timeout del click no sustituiría esa comprobación y tampoco solucionaría tener dos botones que coinciden.
Cuando expliques el fallo, separa «no pude identificar un objetivo único» de «la búsqueda ejecutada devolvió datos incorrectos». La primera conclusión apunta al test; la segunda requiere investigar el contrato de la aplicación y las respuestas recibidas.
Esperar un resultado no corrige un resultado antiguo
Hecho oficial. Las assertions de Playwright que trabajan sobre locators pueden volver a comprobar una condición hasta alcanzarla o agotar el timeout. Leer textContent una vez entrega un valor; no convierte esa lectura en una espera del estado futuro.
Como recomendación ilustrativa, no ejecutada con Playwright Test en este laboratorio, una suite podría expresar el contrato así:
const catalog = page.getByRole('region', { name: 'Catálogo' });
await expect(catalog.getByText('Resultado B', { exact: true }))
  .toBeVisible();
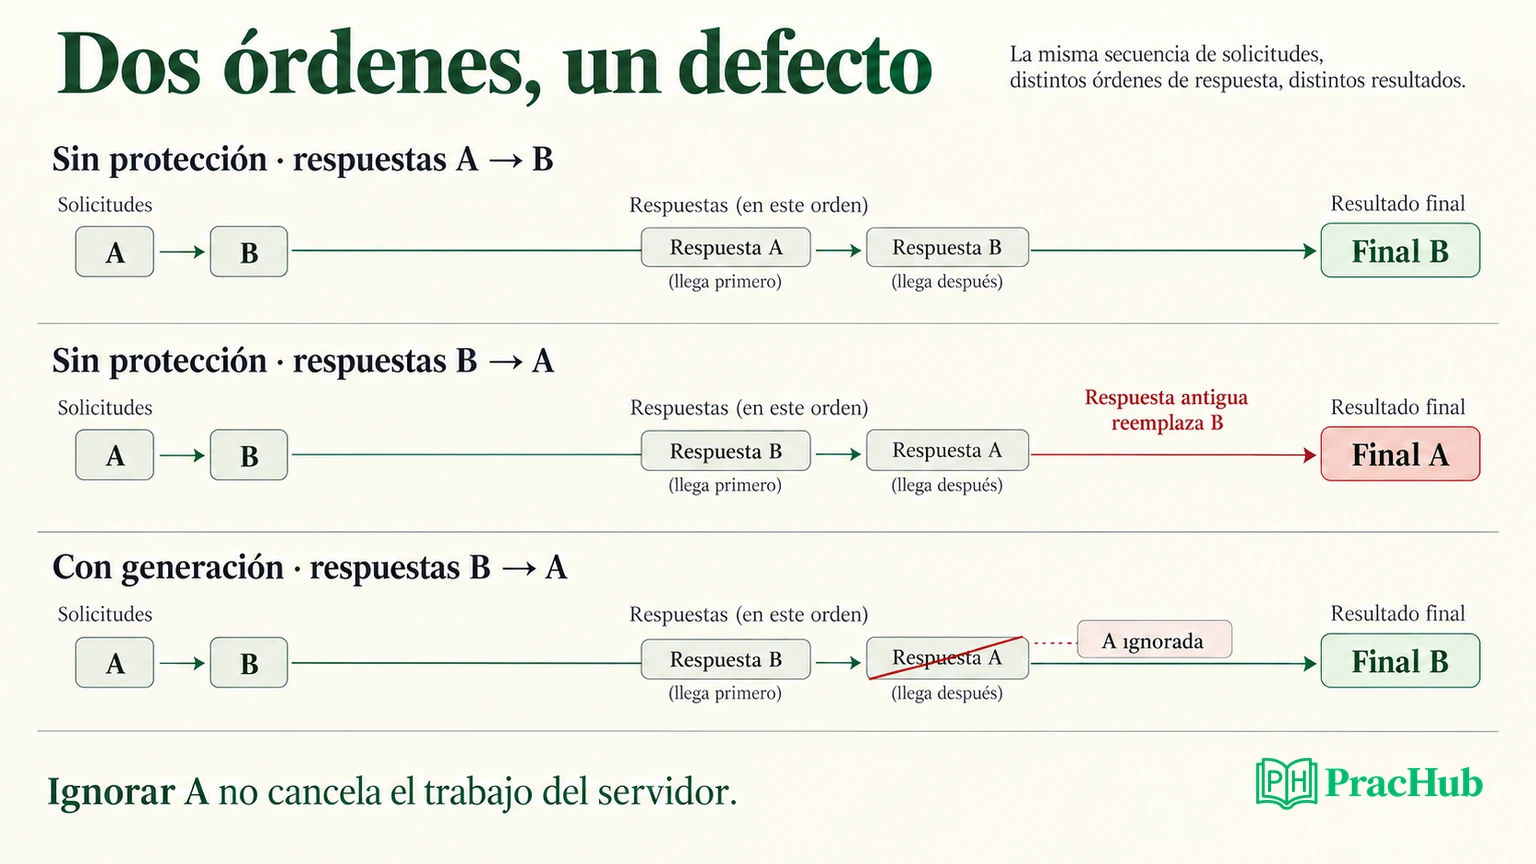
Aun así, que B aparezca una vez no demuestra que vaya a permanecer después de otra respuesta. Nuestra fixture envía A, envía B, libera B y muestra Resultado B. Después libera A. En el modo sin protección, Resultado A reemplaza a B aunque el input siga teniendo B.
Las dos respuestas tienen HTTP 200 y el locator es correcto. El test que comprueba la última intención después de completar ambas respuestas está exponiendo un defecto real: la aplicación permite que una respuesta antigua reemplace el resultado más reciente. Añadir una espera más larga no hace verdadero ese contrato.
En entrevista, una explicación útil sería: «Ya confirmé el click y ambas respuestas. El resultado corresponde a la petición anterior. Voy a controlar el orden para reproducirlo y revisar quién puede actualizar la pantalla». Esa evidencia justifica investigar producto antes de poner toda la responsabilidad en la automatización.
Cambia una regla y repite los órdenes que importan
fixture.html incrementa generation al buscar y compara la generación capturada con la actual antes de renderizar. Cuando llega una respuesta, solo se renderiza si su generación sigue siendo la actual. Es una solución original del caso, no una obligación de Playwright ni una estrategia universal para todas las operaciones.
En modo protegido, pedir A y B y liberar B antes que A deja Resultado B. El log muestra respuesta A e ignorada A. Con el orden contrario, A también se ignora y B termina visible cuando llega. Repetimos además el orden B/A con otro identificador y obtuvimos el mismo resultado.
| Modo y orden controlado | Resultado final observado | Qué demuestra |
|---|---|---|
| Sin protección; B, después A | A | Incumple la última intención |
| Sin protección; A, después B | B | Ese orden oculta el defecto final |
| Con generación; B, después A | B | La respuesta antigua no reemplaza B |
| Con generación; A, después B | B | A se ignora y B puede completar |
No llames al segundo renglón «el retry arregló el problema»: es otra ejecución con un orden que permite pasar al código defectuoso. Tampoco uses tres ejecuciones protegidas para prometer tasa cero de flakiness. Son contraejemplos y comprobaciones controladas del mecanismo.
La protección tampoco cancela el trabajo del servidor. A termina y su respuesta se ignora en la pantalla. Para operaciones con efectos, ignorar el render no revierte una compra ni una reserva; habría que definir otro contrato y verificarlo de manera independiente.
Dos pestañas nuevas pueden seguir usando el mismo recurso
El segundo ejercicio reserva una unidad sintética en el servidor. El campo Identificador de ejecución elige el namespace de inventario. No representa un usuario autenticado ni un producto comercial: sirve para observar quién comparte el estado de la fixture.
Asignamos stock-shared a dos pestañas del mismo navegador y reiniciamos ese namespace una vez. La primera reserva obtiene 201 y deja cero unidades. La segunda obtiene 409. Recargar la segunda página y volver a reservar sigue devolviendo 409: el inventario estaba en el servidor, no en el DOM que acabamos de renovar.
Después asignamos stock-owner-A y stock-owner-B. Reiniciamos cada namespace y ambas reservas reciben 201. Reiniciar B de nuevo no restablece A; otra reserva de A sigue recibiendo 409. Esta última comprobación verifica el alcance del reset, no solo que dos nombres diferentes parezcan funcionar.
Frontera del resultado: son dos pestañas, no dos browser contexts aislados. El servidor utiliza un Map en memoria y endpoints HTTP reales; no hay base de datos, pagos ni solicitudes simultáneas. No atribuimos garantías de aislamiento transaccional a estos resultados.
Las buenas prácticas oficiales de Playwright recomiendan independencia y control de datos de prueba. Inferencia de fixture: asigna recursos propiedad de cada caso y limita su limpieza a ese propietario. Reiniciar una base compartida entera puede crear fallos en pruebas que seguían utilizándola.
Redacta un diagnóstico que otra persona pueda verificar
Un bug reproducible del primer ejercicio incluiría: modo Sin protección, identificador único, solicitudes A/B, respuestas liberadas B/A, esperado B y observado A. Adjunta el log solicitud/respuesta/render y la captura final con input B y resultado A. Evita describirlo únicamente como «búsqueda flaky».
Ese registro permite que otra persona reproduzca el orden B/A y contraste el resultado esperado con el observado. También sabrá que el selector fue único y que ambas respuestas llegaron: no tendrá que comenzar probando timeouts al azar. Una captura aislada muestra el resultado; el orden registrado explica la secuencia que lo produjo.
Para el inventario, registra el identificador en cada reserva y reset. Si otra prueba utilizó stock-shared, ese dato orienta hacia propiedad de fixtures. Si usó otro namespace y aun así alteró A, ya tendrías un contrato de aislamiento incumplido para investigar en el servidor.
El laboratorio conserva screenshots, logs visibles y results.json. No contiene una traza de Playwright Test. Si en tu proyecto utilizas Trace Viewer, preserva los artefactos del intento que realmente falló y correlaciónalos con identificadores de servidor; no inventes información que la captura del navegador no registra.
Decide el alcance de automatización y de cuarentena
Inferencia de estrategia: conserva una regresión pequeña para el orden B/A porque reproduce la causa. Complementa con A/B para comprobar que la corrección permite completar la búsqueda reciente. No necesitas convertir cada permutación imaginable en un E2E lento para demostrar estas dos decisiones.
En un producto real, podrías verificar la selección de generación cerca de la lógica de estado y mantener una prueba de navegador para la interacción visible. Los permisos o el inventario durable necesitarían otra frontera de integración. El harness actual no cubre esas capas.
Si una prueba debe salir temporalmente del bloqueo de entrega, la cuarentena necesita propietario, defecto asociado, criterio de retorno y una explicación de qué riesgo queda sin vigilar. El color verde del pipeline no equivale a que ese comportamiento esté cubierto por otra prueba.
Un retry limitado puede ayudar a recoger evidencia o manejar un fallo transitorio conocido. Registra también cuántos casos fallaron primero y luego pasaron; esconder el primer intento perdería precisamente la información que necesitas para evaluar la reparación.
Ejecuta el caso y practica con cinco preguntas
Descarga el laboratorio de búsqueda y reservas. Con Node.js, ejecuta node server.mjs y abre la dirección local que imprime. El README describe los órdenes y namespace utilizados; no requiere paquetes npm. El servidor registrado se ejecutó con Node 26.9.0 y conserva datos solo mientras vive ese proceso.
Las 25 comprobaciones guardan observaciones concretas, incluido el defecto intencional. Que el harness confirme «la versión rota terminó A» es evidencia de reproducción, no un resultado aprobado del negocio. response-orders.csv mantiene esa diferencia visible.
Material reportado de práctica. Los cinco destinos verificados de PracHub amplían la elección de pruebas; sus empresas y roles originales permanecen en las páginas enlazadas. No afirmamos que sean preguntas exclusivas de QA Automation o Playwright.
| Pregunta completa | Aplicación al laboratorio |
|---|---|
| Testing a New Feature: Planning Test Cases and Handling Flaky Tests | Conserva el primer fallo y elige un experimento que separe causas. |
| Write good tests and define integration tests | Explica qué demuestra el browser y qué pertenece al servidor. |
| Design comprehensive OA test cases | Deriva órdenes y fronteras del contrato, sin prometer cobertura total. |
| Decide When Automated Tests Are Necessary | Justifica una regresión reproducible y la capa donde debe vivir. |
| Design Test Cases for UI Change: Ensuring Quality and Functionality | Comprueba la intención reciente, no solo un elemento visible. |
Continúa con Testing a New Feature: explica el fallo observado, la hipótesis, el cambio específico y la evidencia posterior. Añade qué parte sigue sin probar. Así puedes defender qué comprobaste y qué queda pendiente, sin presentar un harness local como garantía de estabilidad en CI.
Comments (0)