Entrevista QA Automation: diagnostique uma falha intermitente no pipeline
Quick Overview
Investigue uma falha intermitente com dois testes que compartilham um relatório. Um exercício nativo de Playwright Test reproduz a exclusão cruzada com barreiras HTTP e verifica IDs exclusivos em dez execuções. Entenda escopos, workers, retries, limpeza e os limites de um trace sem navegador.
Uma entrevista de QA Automation pode começar com este relato: “Na minha máquina passa; no pipeline falha de vez em quando.” Antes de aumentar o timeout, descubra qual estado os testes compartilham e qual evento ocorre antes da falha. Uma espera maior não recria um registro que outro teste já apagou.
Neste exercício original, dois testes usam o mesmo relatório no backend. O primeiro remove a própria fixture; o segundo tenta ler o relatório depois dessa limpeza. Reproduza a ordem, interprete o trace e mude a propriedade dos dados sem enfraquecer a asserção. Comece por Testing a New Feature: Planning Test Cases and Handling Flaky Tests e explique como distinguir uma hipótese de uma causa demonstrada.
Limite da evidência: a documentação oficial sustenta o funcionamento de fixtures, workers, retries e traces do Playwright. O serviço e os testes são nossos exercícios, não um pipeline de empresa nem relatos de candidatos. Executamos Playwright Test 1.64.0 com requisições HTTP e dois workers contra um servidor local em memória. Não executamos navegador, interface real, banco de produção ou serviço de CI.
Monte uma linha do tempo antes de escolher a correção
O sistema fictício expõe um relatório chamado “Relatório QA”. Criar um identificador retorna 201; ler um identificador existente retorna 200; ler um identificador ausente retorna 404. A exclusão é idempotente no servidor didático: responde 200 mesmo se o objeto já não existir. Essas são regras locais do exercício, não um contrato geral de qualquer API.
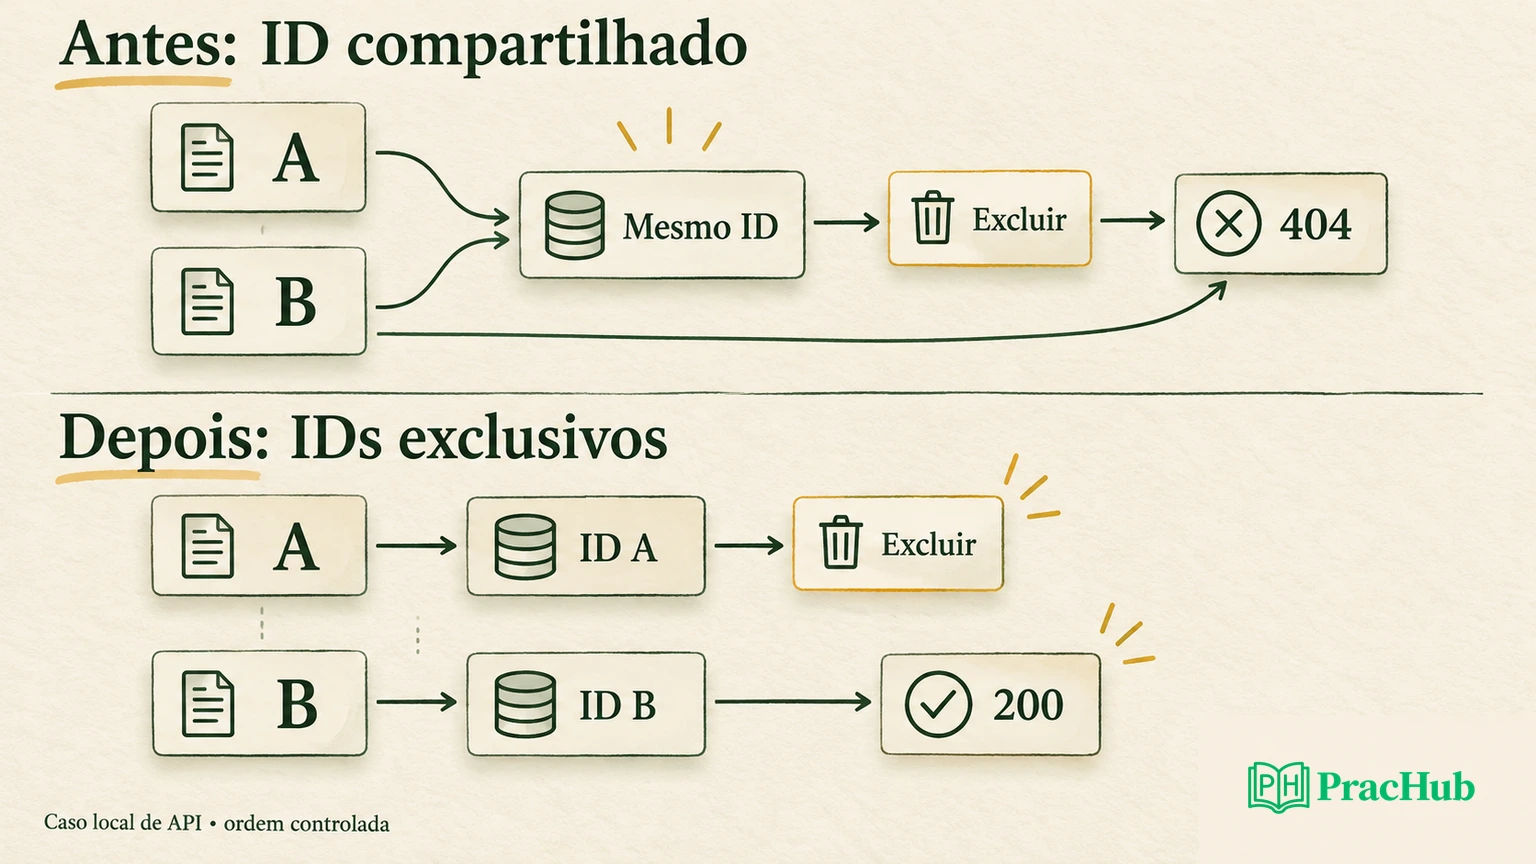
Na fixture antiga, A e B recebem o mesmo identificador, old-ci-0--shared. Cada um acredita ser dono do relatório. O servidor permite que a segunda criação substitua a primeira entrada. Uma barreira aguarda as duas criações, A confirma sua leitura e exclui o registro, e B só então tenta ler. A ordem é forçada para tornar a interferência reproduzível.
| Etapa | Ator | Operação observada | Consequência |
|---|---|---|---|
| Preparação | A e B | Criar o mesmo ID, ambos recebem 201 | Os testes compartilham uma entrada |
| Barreira | A e B | Ambos chegam ao ponto de encontro | A leitura ocorre após a preparação dos dois |
| Limpeza | A | Ler 200 e excluir o ID | O registro compartilhado desaparece |
| Verificação | B | Ler o mesmo ID, receber 404 | A expectativa de 200 falha |
A execução antiga terminou com um teste aprovado e um reprovado. O resultado demonstra a colisão neste serviço sob a ordem imposta pela barreira. Não demonstra que toda falha intermitente de uma aplicação venha de dados compartilhados. A reprodução é determinística; a intermitência aparece em sistemas que permitem diferentes ordens sem impor nossa barreira.
O 404 também não prova, sozinho, que o produto apagou o relatório incorretamente. Compare o identificador da criação, o da exclusão e o da leitura. Aqui são iguais e a exclusão foi feita pelo teste A. Em um incidente real, procure essa cadeia nos artefatos antes de atribuir a falha ao frontend, à rede ou ao backend.
Separe isolamento de navegador e isolamento de dados
A documentação de fixtures descreve page e context isolados para cada teste, enquanto browser pode ser compartilhado. Essa separação ajuda a controlar cookies e estado do navegador. Ela não cria automaticamente contas, relatórios ou pedidos distintos em um backend externo.
Dois contextos podem usar credenciais diferentes e ainda editar o mesmo objeto. Dois testes podem usar a mesma conta sem problema se suas operações forem independentes. Pergunte qual recurso é mutável e quem tem permissão para limpá-lo. Neste caso, a unidade de isolamento necessária é o relatório, não apenas a sessão do navegador.
Um erro frequente é colocar a criação em beforeAll e apagar o recurso depois de cada teste. O escopo de criação dura mais que o escopo de limpeza. Outra variante cria uma conta por worker, mas permite que testes do mesmo worker alterem preferências da conta. A conta existe separadamente; o estado dentro dela continua compartilhado.
A documentação de paralelismo distingue workerIndex e parallelIndex: o primeiro muda quando um worker reinicia, enquanto o segundo permanece no mesmo slot. Nenhum deles é, isoladamente, uma chave global entre jobs independentes. Um projeto com shards, navegadores e retries precisa considerar todas as execuções que alcançam o mesmo ambiente.
Para este exercício, cada invocação da fixture recebe um UUID e um prefixo de execução. O prefixo ajuda a localizar sobras; o UUID separa os recursos dos testes. Em uma implementação real, use o identificador retornado pela criação e defina uma política contra colisões. A probabilidade pequena de repetir um UUID não substitui constraints e autorização no servidor.
Corrija a propriedade da fixture, mantendo a asserção
A alteração principal é criar um relatório exclusivo por teste e excluir exatamente esse relatório no teardown. Não alteramos a expectativa de B: ele ainda precisa encontrar seu próprio objeto depois que A remove o objeto de A. Assim, a correção remove a colisão de recursos entre testes, e não o comportamento que o teste verifica.
Este trecho mostra o núcleo da fixture corrigida. Os testes de orquestração e o servidor local acrescentam uma barreira para impor a ordem A-exclui-antes-de-B-ler; a barreira é um instrumento de reprodução, não uma dependência que deve entrar no teste de produto.
import { test as base, expect } from '@playwright/test';
import { randomUUID } from 'node:crypto';

const test = base.extend<{ itemId: string }>({
  itemId: async ({ request }, use, testInfo) => {
    const phase = `${process.env.RUN_ID}-${testInfo.repeatEachIndex}`;
    const id = `${phase}--${randomUUID()}`;
    expect((await request.post(`/items/${id}`)).status()).toBe(201);
    try {
      await use(id);
    } finally {
      await request.delete(`/items/${id}`);
    }
  },
});
O trecho pressupõe RUN_ID configurado e uma baseURL de teste. A criação e a exclusão correspondem ao servidor didático. Não cole essas rotas em um ambiente desconhecido. Em uma aplicação real, o cliente deve guardar o ID confirmado pelo servidor e restringir operações ao ambiente e ao namespace autorizados.
O finally tenta a limpeza depois do uso da fixture, inclusive quando a asserção falha. Não garante limpeza após encerramento abrupto do processo. Uma falha de preparação após o envio da criação também exige análise: a requisição pode ter criado o objeto antes de perder a resposta. Planeje uma coleta posterior de sobras identificáveis, sem apagar recursos de outros testes.
Evite uma limpeza global como “excluir todos os relatórios de QA”. Ela recria a interferência em outro ponto. Um coletor por prefixo deve respeitar prazo, execução concluída e propriedade do recurso. Dê preferência a recursos efêmeros em um ambiente dedicado, com limites claros e registro do que foi removido.
Use o trace para responder à hipótese certa
O Trace Viewer permite explorar chamadas e artefatos registrados pelo Playwright. Nosso teste de API produziu um trace.zip; extraímos os eventos para verificar a sequência de requisições. Como nenhum navegador foi iniciado, esse trace não contém uma interação de usuário ou uma captura de DOM que comprove comportamento visual.
Em um teste de interface real, associe a falha ao passo, à requisição e à resposta relevante. Um elemento ausente pode ser consequência de um 404 anterior. Uma captura de tela mostra o estado em determinado momento; o encadeamento de eventos ajuda a descobrir como o teste chegou até ele. Preserve também o teste concorrente que realizou a limpeza.
Registre revisão do código, comando, versão do runner, projeto, shard, worker, tentativa, identificador de execução e recurso afetado. No nosso pacote, o identificador compartilhado conecta a exclusão de A ao 404 de B. Relógios entre máquinas podem divergir: prefira IDs de correlação e relações de causalidade a uma comparação ingênua de timestamps.
Capturar apenas a primeira repetição pode perder o defeito original. O trace dessa repetição mostra outra execução, possivelmente com estado e concorrência diferentes. Para investigar uma reprodução controlada, registramos todas as tentativas locais. Em uma suíte grande, ajuste retenção e custo sem descartar silenciosamente a primeira falha relevante.
Traces podem incluir URLs, corpos de resposta, credenciais em cabeçalhos ou dados pessoais. Use dados sintéticos, controle o acesso ao artefato e revise o conteúdo antes de compartilhar. Um exemplo de entrevista não precisa carregar registros de clientes para ser convincente. Mostre a estrutura mínima necessária para sustentar sua conclusão.
Por que retry e execução serial não encerram a investigação
Segundo a documentação de retries, um teste que falha primeiro e passa ao repetir é classificado como flaky. O runner também substitui o worker após falhas. Isso pode alterar a ordem e a preparação do teste. Um resultado final aprovado não apaga a informação sobre a primeira execução.
No exercício, configuramos zero retries para observar diretamente o defeito. Depois da correção, executamos cinco repetições do par com dois workers: dez testes passaram. Cada par manteve A excluindo antes da leitura de B. O resultado sustenta que IDs distintos removem essa interferência específica sob a ordem controlada.
Dez aprovações neste cenário controlado não estimam a taxa de falha do pipeline nem provam ausência de outras races. Não rodamos diferentes navegadores, carga externa, interrupções de processo ou consistência eventual de banco. O servidor usa memória e responde imediatamente depois das operações; uma aplicação distribuída pode introduzir outros atrasos e regras de visibilidade.
Executar a suíte com um worker é uma experiência útil: se a falha desaparecer, fortalece uma hipótese de interferência. Não prova a causa, porque carga e timing também mudam. Manter tudo serial pode ser uma contenção temporária quando o risco é alto, acompanhada de responsável e prazo para corrigir. Não apresente essa contenção como demonstração de isolamento.
Aumentar um timeout só ajuda se o estado esperado puder surgir dentro daquele intervalo. Aqui o registro foi excluído e nenhuma operação o recria. Uma asserção que aguarda o mesmo ID continuará esperando uma condição impossível. Em outros casos, uma espera por condição observável pode ser correta; diferencie atraso legítimo de recurso destruído.
Apresente o diagnóstico como uma cadeia de evidências
Uma resposta oral pode começar assim: “Minha hipótese inicial é colisão de dados entre testes. No pacote, ambos criam o mesmo ID; A o exclui antes de B ler, e B recebe 404. Reproduzi essa ordem com uma barreira. Ao fornecer um recurso exclusivo por teste e limpar apenas o próprio ID, mantive a mesma asserção e obtive dez execuções aprovadas.”
Continue com o limite: “Isso explica a interferência no serviço local. Para o pipeline real, ainda preciso confirmar os IDs, as operações de limpeza e a ordem nos traces da primeira falha. Também verificaria se retries, shards ou projetos diferentes usam o mesmo namespace.” Essa conclusão mantém a confiança proporcional ao que foi observado.
Se perguntarem sobre locators, explique quando investigá-los: se a requisição devolveu o objeto correto e a interface não o mostra, procure renderização, seleção ambígua ou atualização tardia. Não troque um locator sem conectar a mudança à evidência. Um seletor mais permissivo pode fazer o teste encontrar o relatório errado e esconder a colisão.
Para encerrar, proponha três entregas revisáveis: reprodução mínima com a ordem relevante, patch que separa recursos e artefatos que preservam o contexto da falha. Acrescente uma verificação de limpeza e uma limitação ainda não coberta. Cada conclusão fica ligada a uma requisição, a um recurso ou a uma asserção observável.
Use estas questões para variar o diagnóstico e o nível de teste:
| Questão PracHub | Foco de prática |
|---|---|
| Testing a New Feature: Planning Test Cases and Handling Flaky Tests | Separar cobertura, reprodução e contenção. |
| Python and pytest Fundamentals: Fixtures, Decorators, and Generators | Comparar propriedade e escopo de fixtures. |
| Debug Failing Tests in a Django Movie Search and Filter API | Relacionar resposta HTTP e asserção. |
| Debug and Fix Failing Unit Tests in Java | Corrigir a causa preservando a expectativa útil. |
| Debug a Test-Driven C++ Project | Reduzir uma falha a um caso revisável. |
Continue com Debug Failing Tests in a Django Movie Search and Filter API. Primeiro escreva qual resposta o teste deveria observar e qual mudança de estado poderia torná-la impossível.
Comments (0)