소프트웨어 마에스트로 코딩테스트: 공개 가이드와 응시 환경으로 준비하기
Quick Overview
2026년 제17기 AI·SW마에스트로 공식 공고로 기본·심화 알고리즘과 SQL 준비 범위를 정리합니다. 센터별 일정, 학습가이드의 2025년 기준 형식, 다음 기수 미확인 조건을 나누고 합성 SQL 결과로 LEFT JOIN·집계·NULL 오류를 검산합니다.
소프트웨어 마에스트로 코딩테스트는 지원 차수와 모집 기수의 공식 공고를 기준으로 준비해야 합니다. 이번 재확인에서 읽은 공식 모집 자료는 2026년 제17기 공고로, 1·2차 코딩테스트와 알고리즘·SQL 범위, 응시 환경 관련 조건을 설명합니다. 차기 기수의 조건으로 옮겨 말하지 말고, 현재 공고와 응시 안내를 먼저 대조한 뒤 그 범위에 맞는 연습을 구성하세요. 먼저 Part 1: Frequency-Based Cache Simulator로 한 번 풀어 보고, 이 글의 점검 절차로 풀이를 다시 검증하세요.
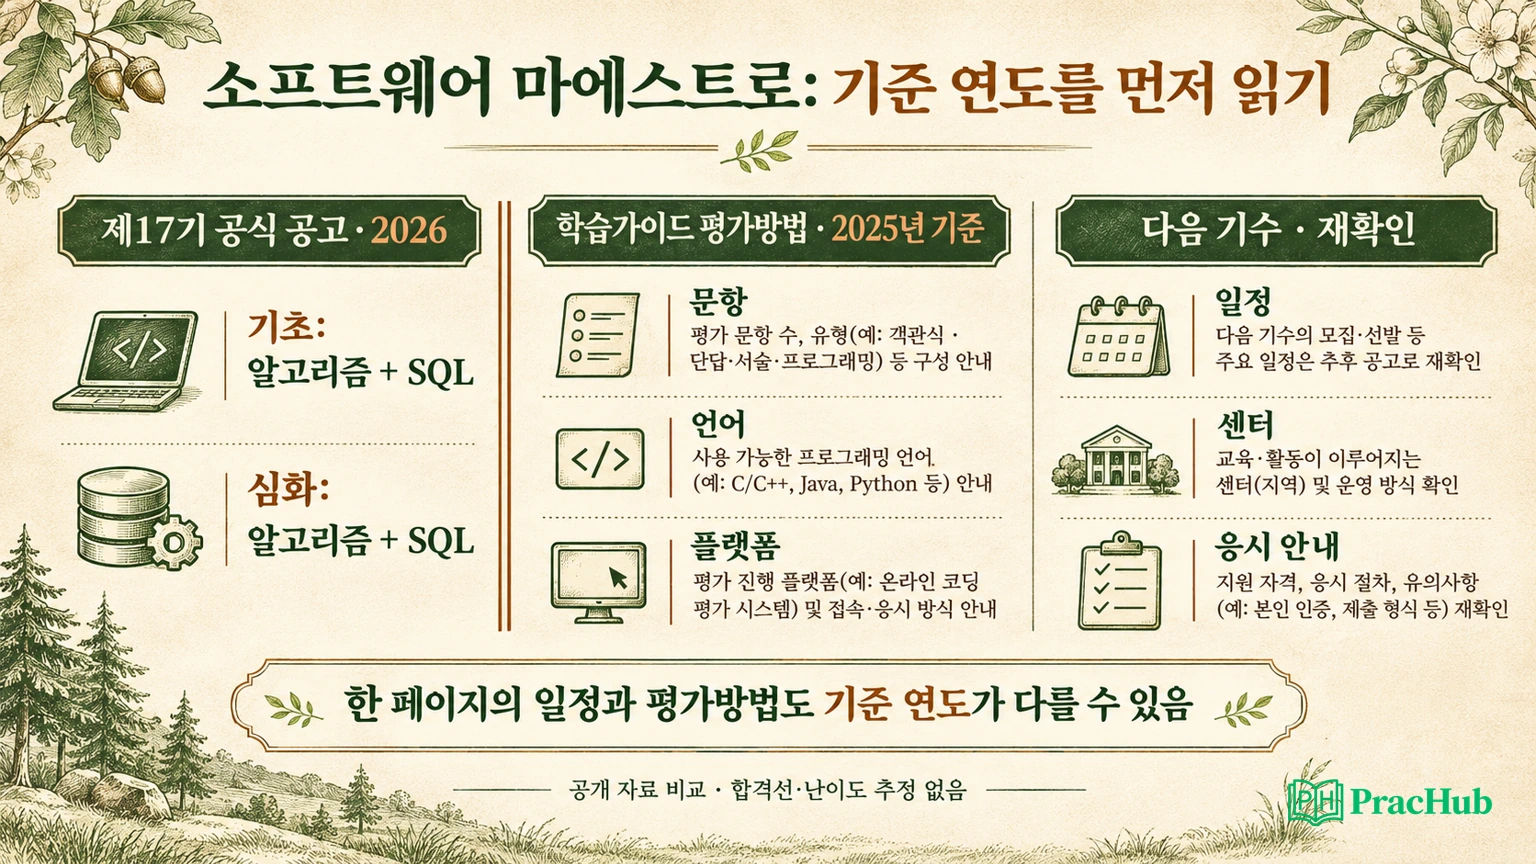
공식 사실: 확인 가능한 2026년 제17기 모집 공고는 1차에서 기본 알고리즘·자료구조·SQL, 2차에서 심화 알고리즘·고급 자료구조·SQL을 평가한다고 설명하고, 각 차수 응시 조건도 명시합니다. 이는 해당 기수 공고의 사실이며 차기 기수에 자동 적용되는 규칙이 아닙니다. 후보자 보고: 동일 회차의 독립된 후보자 보고는 수집하지 않았습니다. 추론: 기수별 공고를 체크리스트로 분해하고, 알고리즘·SQL·응시 환경을 각각 검증한 뒤 실제 조건에 가까운 모의 세션으로 연결한다.
공고를 읽기 전에는 기수와 차수를 고정 (Cohort and stage)
“소프트웨어 마에스트로 코테는 몇 문제인가” 같은 질문은 회차를 지정하지 않으면 답이 흔들립니다. 먼저 공식 모집 공고의 기수, 지원 차수, 시험 날짜, 응시 방식, 언어·문항 범위, 금지 행위를 한 표로 옮기세요. 검색 결과 요약이나 전년도 후기에서 본 규칙은 최신 공고와 같은 열에 넣지 말고 별도 참고로 둡니다.
후보자 보고: 이번 글에서는 같은 기수의 독립된 후보자 경험 보고 두 건을 확보하지 않았습니다. 따라서 출제 수, 난이도, 특정 언어의 유불리, 합격선은 주장하지 않습니다. 추론: 공식 공고에 명시된 평가 영역을 기준으로 준비하되, 세부 제한은 응시 초대와 시험 안내가 우선합니다.
2026년 제17기 공고가 말한 평가 범위 (Confirmed scope)
확인한 2026년 제17기 모집 공고는 1차 코딩테스트의 기본 알고리즘·자료구조와 SQL, 2차의 심화 알고리즘·고급 자료구조와 SQL을 구분해서 설명합니다. 응시 단계별 지원 조건과 부정행위 방지 조치도 기재되어 있습니다. 이 문구는 2025년 공고에 관한 사실이지, 차기 모집 회차에 대한 보장이 아닙니다.
| 항목 | 확인된 2026년 제17기 공식 안내 | 다음 회차에서 재확인할 것 |
|---|---|---|
| 단계 | 1차·2차 코딩테스트로 설명 | 실제 모집 차수와 대상자 조건 |
| 기본 영역 | 기본 알고리즘·자료구조·SQL | 최신 범위 및 세부 시험 안내 |
| 심화 영역 | DP·탐색·그래프 등 심화 알고리즘과 SQL | 구체 범위와 응시 시간 |
| 환경 | 공식 공고의 응시 조건·부정행위 방지 조치 | 사용하는 플랫폼, 카메라·화면공유, 허용 도구 |
| 결과 후 단계 | 공고에 기재된 선발 절차 | 변경된 면접·평가 일정 |
안내 페이지 안에서도 기준 연도를 분리한다 (Source-year boundary)
제17기 모집 공고는 서울과 부산의 2026년 일정을 따로 적습니다. 서울의 1·2차는 2월 28일과 3월 7일, 부산은 3월 28일과 4월 4일이며 각각 14시~16시로 안내되어 있습니다. 이 날짜들은 현재 준비할 미래 일정이 아니라 제17기 공고를 읽기 위한 기준점입니다. 지원 센터를 지우고 “소마 시험일” 하나로 합치지 마세요.
반면 코딩테스트 사전 학습가이드는 제17기 일정 아래에 평가방법을 별도로 2025년 기준이라고 표시합니다. 그 단락의 알고리즘 4문항·SQL 1문항, 지원 언어 및 플랫폼 설명을 제18기 확정 규칙으로 인용하면 근거의 기준 연도가 사라집니다. 모집 공고의 평가 영역과 학습가이드의 과거 형식 예시를 서로 다른 행에 기록하고, 자신의 응시 초대에서 현재 적용 여부를 확인하세요.
공고와 안내가 서로 달라 보이면 확인 날짜와 원문 단락을 보존합니다. 한쪽을 임의로 최신 규칙이라고 택하기보다 센터·차수·기준 연도·추가 안내 중 무엇이 다른지 먼저 찾습니다. 이 글은 후보자 후기에서 합격선이나 숨겨진 평가 비중을 보충하지 않습니다.
영역별 준비표를 만든다 (Practice mapping)
알고리즘은 배열·문자열·정렬·탐색·스택·큐 같은 기본 도구부터 시작해, 그래프 탐색과 동적 계획법을 조건에 따라 선택하는 연습으로 확장합니다. 문제를 유형 이름으로만 분류하지 말고 “입력의 크기, 필요한 연산, 상태 정의, 복잡도”를 기록하세요. 같은 DP라도 상태가 무엇인지 설명하지 못하면 점화식은 외운 것에 그칩니다.
SQL은 결과 행의 단위를 먼저 정의합니다. JOIN 뒤 행이 늘어나는 이유, NULL의 비교 규칙, GROUP BY 전에 필터링할지 이후에 조건을 걸지, 동률 순위가 어떤 함수로 표현되는지 실제 표를 만들어 검산합니다. 알고리즘과 SQL은 풀이 과정이 다르므로 같은 모의 세션 안에서도 별도 시간으로 두는 편이 진단에 유리합니다.
기본 알고리즘에서 심화 문제로 이동 (Algorithm constraints)
기본 문제에서는 입력 파싱, 자료구조 API, 조건문, 정렬 기준처럼 구현 오류를 줄입니다. 이후 심화에서는 상태 수와 전이 비용을 세고, 탐색이 모든 경우를 방문하는지 또는 가지치기로 줄어드는지 설명합니다. 예를 들어 그래프 탐색은 방문 표시 시점이 중복 큐 삽입과 무한 반복을 바꿀 수 있고, DP는 같은 상태가 여러 번 계산되는지 여부가 점화식 선택을 바꿉니다.
한 문제를 풀고 답을 확인한 뒤에는 풀이를 닫고 다시 구현합니다. 이때 복잡도와 불변식을 먼저 말하고, 최대 입력에서 자료구조 선택을 재검토하세요. 공개 공고의 “심화”라는 말만 보고 특정 문제를 예상하는 대신, 범위에 해당하는 기초 연산을 직접 코딩하는 것이 더 검증 가능합니다.
SQL은 손으로 표를 만들어 검증 (SQL grain)
다음 작은 데이터로 결과를 먼저 계산합니다: 고객 A가 주문 2건, 고객 B가 주문 0건이며 주문 상태에 NULL이 하나 포함되어 있다고 가정합니다. LEFT JOIN 후 고객 수를 세는 쿼리는 COUNT(*)와 COUNT(order_id)가 다를 수 있습니다. NULL이 있는 비교는 = NULL이 아니라 IS NULL 또는 IS NOT NULL로 표현해야 합니다.
그다음 JOIN 키의 중복과 필터 순서를 바꿔 봅니다. 집계가 두 배가 되면 원본 표의 행 단위와 결합 후 행 단위를 비교하고, 쿼리 계획만으로 결과 정확성을 대신 주장하지 않습니다. 이는 연습용 합성 데이터이며 해당 시험에 실제 출제된 사례가 아닙니다.
실제 행을 출력하는 작은 SQL 검산 (Executable SQL)
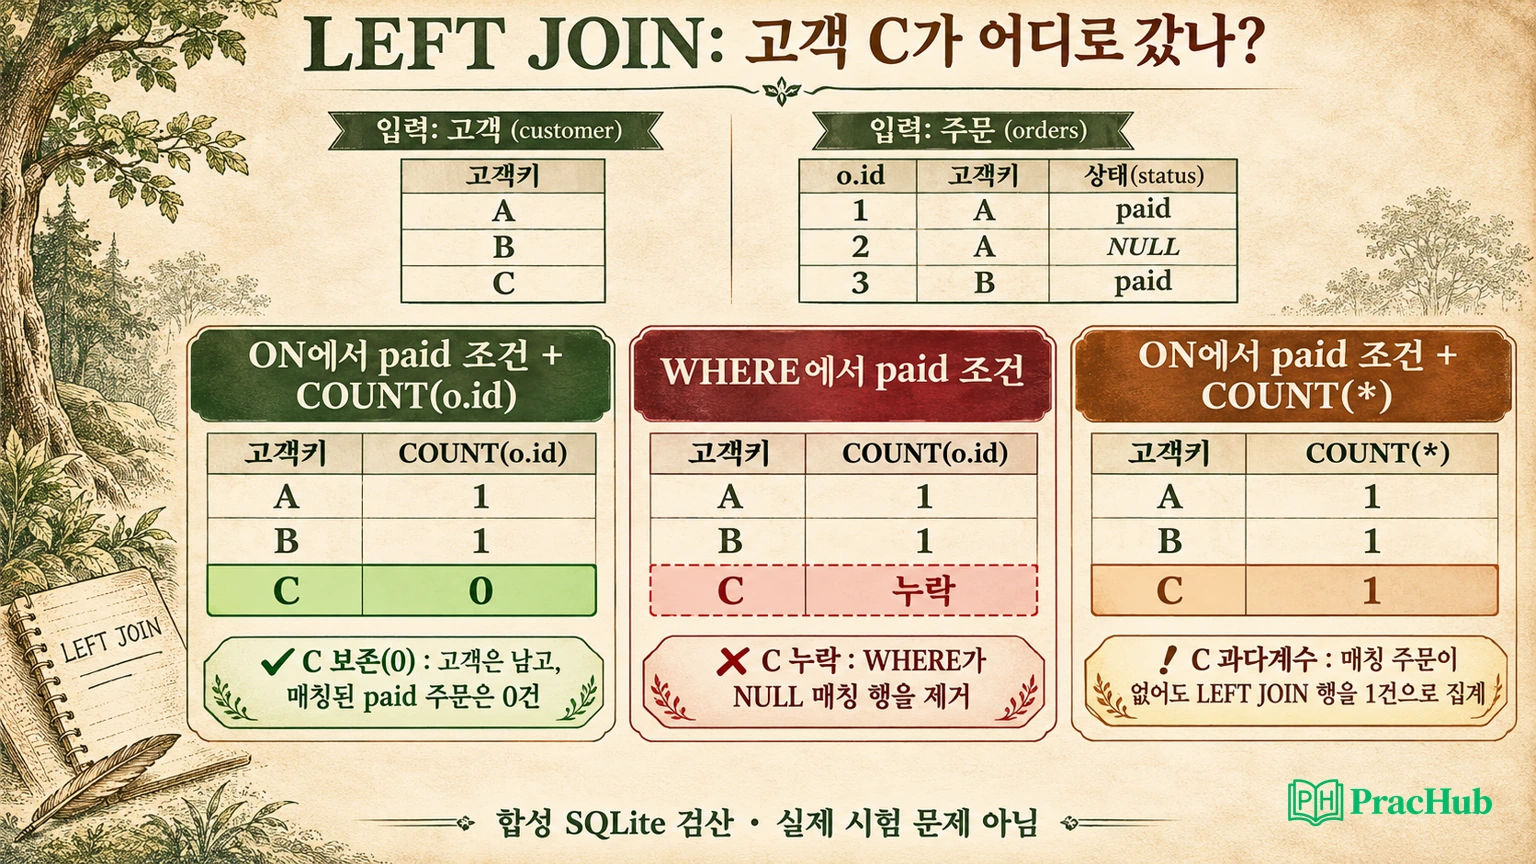
다음은 SQLite에서 로컬로 검산한 합성 데이터입니다. 시험의 SQL 엔진을 실행했다는 뜻은 아닙니다. 고객 A에게 주문 2건, B에게 1건, C에게 0건이 있으며 상태는 A의 한 주문만 NULL입니다. 요구사항을 “결제 완료 주문 수를, 주문이 없는 고객도 포함해 고객별로 반환”으로 고정합니다.
CREATE TABLE customers (id TEXT PRIMARY KEY);
CREATE TABLE orders (id INTEGER PRIMARY KEY, customer_id TEXT, status TEXT);
INSERT INTO customers VALUES ('A'), ('B'), ('C');
INSERT INTO orders VALUES
  (1, 'A', 'paid'), (2, 'A', NULL), (3, 'B', 'paid');

SELECT c.id, COUNT(o.id) AS paid_orders
FROM customers AS c
LEFT JOIN orders AS o
  ON o.customer_id = c.id AND o.status = 'paid'
GROUP BY c.id
ORDER BY c.id;
기대 결과는 (A,1), (B,1), (C,0)입니다. 상태 조건을 WHERE로 옮기면 C의 NULL 확장 행이 제거되어 (A,1), (B,1)만 남습니다. 이것은 문법 오류가 아니라 반환해야 할 고객 집합을 바꾼 논리 오류입니다. COUNT(*)로 바꾸면 C의 NULL 확장 행까지 세므로 결제 주문이 없는데도 1이 됩니다. 테스트는 행 개수 3개, 키 A/B/C 보존, 각 집계값을 함께 확인해야 합니다.
다음 변형은 주문이 아닌 고객 수를 구하는 것입니다. JOIN 결과를 COUNT(*)로 세면 A가 두 번 나타날 수 있으므로, 고객 표 자체의 행 수를 세거나 요구한 단위로 먼저 중복을 정리해야 합니다. 반대로 주문 건수가 목적이라면 서로 다른 주문 ID를 임의로 하나로 합치면 안 됩니다. 같은 JOIN이라도 요구한 집계 단위가 달라지면 정답 쿼리가 달라집니다.
응시 환경은 초대 안내를 기준으로 점검 (Test environment)
2026년 제17기 공고의 감독·부정행위 방지 관련 조치는 그 회차의 안내입니다. 카메라나 화면 공유가 언급됐다고 해서 다음 회차의 설정을 추정하지 마세요. 시험 안내에서 허용 플랫폼, 실행 환경, 외부 IDE, 검색·AI, 추가 화면, 네트워크 제한을 항목별로 확인하고, 이해가 모호한 항목은 응시 전에 공식 문의 경로로 확인합니다.
실전 연습에서는 허용된 브라우저나 에디터에서 코드를 실행하고 제출까지 완료하는 흐름을 익힙니다. 도구 제한을 우회하는 방법은 준비 전략이 아닙니다. 환경 문제를 미리 발견하는 목적은 규칙에 맞는 상태를 만들고, 시험 중에는 문제 해결에 집중하는 것입니다.
모의 세션은 두 유형으로 나눈다 (Mixed sessions)
첫 세션은 기본 알고리즘과 SQL을 따로 측정합니다. 두 번째는 심화 알고리즘과 복잡한 SQL을 섞어 풀이 전환 비용을 확인합니다. 각 세션 뒤에는 정답 여부 외에 요구사항 오독, 상태 정의, 복잡도 추정, SQL 행 단위, 제출 환경 오류를 분리해서 기록하세요.
틀린 문제는 바로 정답 코드를 외우지 말고, 실패한 최소 입력을 만들고 기존 풀이가 어디서 깨지는지 설명합니다. 다음 날에는 같은 문제를 보지 않고 다시 풀고, 마지막에는 조건 하나를 바꾼 변형을 해결해 학습이 전이되는지 확인합니다.
지원자가 준비할 최종 체크 (Submission checks)
최신 공고를 내려받고 파일 날짜와 회차를 기록합니다. 시험 링크에서 허용 환경·도구 규칙을 재확인하고, 알고리즘과 SQL 모의고사에서 각 오류 원인을 따로 집계합니다. 제출 직전에는 실행 버튼, 제출 버튼, 저장 여부, 마지막 코드 상태를 확인하는 순서를 정합니다. 이 체크는 결과를 보장하지 않지만, 준비 과정에서 통제할 수 있는 누락을 줄입니다.
아래 PracHub 문제들은 알고리즘 연습용입니다. SW마에스트로에서 실제로 출제됐다는 주장을 의미하지 않습니다.
단계마다 필요한 증거를 구분 (Evidence by stage)
2026년 제17기 문서에서는 다음 차수 응시 대상자 조건을 구분합니다. 본인이 실제로 안내받은 단계에 맞춰 기본·심화 항목을 선택하고, 단계가 다르면 같은 공고 안에서도 대상자 조건을 혼동하지 마세요. 공고에 적힌 평가 범위와 개인이 푼 연습문제 점수는 서로 다른 종류의 근거입니다.
오답 노트에는 원문 요구사항, 입력 크기, 핵심 불변식, 실패한 테스트, 제출 코드의 복잡도를 적습니다. 그래프 문제를 틀렸다면 방문 표시 시점과 중복 큐 삽입 여부를 확인합니다. SQL을 틀렸다면 어떤 키에서 행이 늘었고 결과 단위를 잘못 세었는지 기록합니다.
응시 환경 점검을 준비 루틴에 넣기 (Environment checklist)
공식 자료에 명시된 조치를 따르고 실제 응시 초대의 최신 안내를 우선합니다. 자동완성, 인터넷 접근, 외부 IDE, 화면 공유와 카메라처럼 결과에 영향을 주는 항목은 허용 여부를 직접 확인해야 합니다. 허용되지 않은 도구를 쓰거나 접근 통제를 우회하는 방식은 준비 전략이 아닙니다.
확인표에는 사실과 미확인을 분리합니다. 예를 들어 독립 공간은 특정 연도 공고에서 확인했고, 카메라는 초대 안내에서 재확인해야 하며, 외부 문서 검색은 허용 여부가 확인되기 전에는 사용하지 않는다고 기록할 수 있습니다. 이는 정해진 조건 안에서 접속·저장·실행·제출 실수를 줄이기 위한 준비입니다.
혼합 SQL 예제를 행 단위로 검산 (Join cardinality)
주문이 3건이고 고객이 3명인 합성 데이터에서 고객별 주문 건수를 계산한다고 합시다. 한 고객이 주문 2건, 다른 고객이 주문 1건, 마지막 고객은 주문이 없습니다. LEFT JOIN 뒤 주문이 없는 고객은 주문 열이 NULL인 행 하나로 남습니다. COUNT(*)는 그 행을 세지만 COUNT(order_id)는 NULL을 세지 않습니다. 요구사항이 고객 수인지 주문 수인지 먼저 정해야 합니다.
주문 상태로 필터링할 때 WHERE 조건을 두면 주문 없는 고객이 결과에서 사라질 수 있는지 확인하세요. 조건을 JOIN에 두는 방식이 의도와 맞는지도 결과표로 검산합니다. 이 예시는 SQL 기본 범위를 설명하기 위해 만든 합성 데이터이며 실제 출제 사례가 아닙니다.
다섯 번의 연습에서 남길 증거 (Error review)
첫 회차에는 자료구조 기본 연산과 SQL 행 단위를 진단합니다. 둘째는 정렬·탐색·완전탐색을 구현하고 경계 케이스를 추가합니다. 셋째는 그래프 탐색과 DP 상태를 설명합니다. 넷째는 JOIN·집계·NULL·UNION 결과를 손으로 계산합니다. 다섯째는 공식 안내에서 확인한 도구 조건 아래 제출까지 연습합니다. 실제 제한 시간은 최신 공지를 사용하고, 이 계획의 연습 시간을 시험 시간처럼 인용하지 않습니다.
각 회차 뒤 오답을 요구사항, 선택, 구현, SQL 결과, 환경·제출로 분류합니다. SQL 결과가 틀렸으면 JOIN 문법을 다시 외우기보다 입력 행 수와 집계 단위를 재현하세요. 어떤 오류가 반복되는지 다음 연습 계획에 반영하면 무작정 문제를 늘리는 것보다 진단이 선명해집니다.
준비 흐름을 한눈에 보기 (Workflow)
질문으로 연습하고 최신 안내로 조정 (Practice questions)
| PracHub question | Practice focus | Why it helps |
|---|---|---|
| Part 1: Frequency-Based Cache Simulator | 코딩·검증 연습 | 자료구조 선택과 복잡도 설명을 연습합니다. |
| Solve BST and Grid Query Problems | 코딩·검증 연습 | 그래프·트리 상태를 경계 테스트로 검증합니다. |
| Part 1: Find Three Cards Summing to 15 | 코딩·검증 연습 | 심화 탐색에서 가지치기 조건을 점검합니다. |
| Referral funnel metrics per referrer (LEFT JOIN with date filter) | SQL 필터 위치 | ON과 WHERE에서 고객 집합이 달라지는지 검산합니다. |
| Rank Departments by Student Count | SQL 집계 단위 | 연결 후 행 수와 COUNT의 NULL 처리 차이를 검증합니다. |
아래 공식 페이지를 다시 확인한 뒤, 발표된 조건에 맞춰 모의 세션을 조정하세요. 연습 질문은 지원 프로그램의 기출이나 합격을 보장하지 않습니다.
Sources and Further Reading
- 2026년도 AI·SW마에스트로 제17기 모집 공고 — 센터별 일정, 단계별 평가 영역과 감독 조치.
- 공식 코딩테스트 사전 학습가이드 — 제17기 일정과 별도로 표시된 2025년 기준 평가방법.
- 과학기술정보통신부 공고 제2026-0013호 PDF — 공식 모집 공고 원문.
- SQLite SELECT documentation — 로컬 합성 예제의 LEFT JOIN과 WHERE 처리 순서.
자료 범위: 공식 자료의 기준 연도와 센터를 유지했습니다. 독립된 동일 회차 후보자 보고 두 건은 확보하지 않았으며, 난이도·합격선·실제 출제 문제를 주장하지 않습니다. SQL은 이 글의 합성 SQLite 검산이며 채용 플랫폼에서 실행한 결과가 아닙니다.
Comments (0)