완전탐색 코딩테스트: 중복 없이 후보를 만들고 탐색량을 계산하기
Quick Overview
중복 없는 후보의 기준은 값이 아니라 선택 인덱스인지, 출력 조합의 값인지부터 정해야 한다. 후보 수를 계산하면 탐색, 가지치기, 동적 계획법 중 무엇이 필요한지 근거를 세울 수 있다.
완전탐색 코딩테스트에서 중복 없는 후보를 만들려면, 먼저 순서가 다른 결과를 같은 것으로 볼지와 중복 값의 입력 위치를 구별할지를 정해야 합니다. 이 계약에 따라 조합·순열·부분집합의 탐색량이 달라지고 가지치기의 안전성도 달라집니다. [1,1,2]에서 고유 조합을 직접 만들고, 기준 오라클로 누락과 중복을 검사하는 방법을 살펴봅니다. PracHub의 Generate combinations and permutations는 풀이 연습을 위한 자료이며 시험 출제를 예측하지 않습니다.
근거 범위. 공식 언어 문서는 라이브러리 동작의 근거입니다. 아래 불변식과 풀이의 정당성은 명시한 입력 계약에 따른 유도이며, 배열·그래프·시간축과 검산 코드는 이 글의 합성 교육 사례입니다. 후보자 보고나 특정 회사의 출제 형식은 사용하지 않았습니다.
완전탐색을 시작하기 전에 후보의 정의를 쓰기 (Candidate identity)
“가능한 경우를 모두 확인한다”는 말만으로는 구현을 정하기 어렵습니다. 순서가 다른 결과를 같은 후보로 볼지, 같은 값을 가진 입력 원소의 위치를 다른 선택으로 셀지, 원소를 반복해서 고를 수 있는지를 먼저 정해야 합니다. 이 계약이 정해지면 후보 수와 종료 조건을 유도할 수 있습니다.
서로 다른 n개 항목 중 k개를 뽑을 때 순서 없는 조합은 C(n,k), 순서 있는 비복원 순열은 n!/(n-k)!입니다. 각 항목을 선택/비선택하는 부분집합은 2^n개입니다. 반복 선택을 허용하는 길이 k의 순서열은 항목이 n개일 때 n^k개입니다. 이 수는 완전탐색이 가능한지 가늠하는 출발점이지, 실제 실행시간의 전부는 아닙니다. 결과를 복사하거나 평가하는 비용도 더해야 합니다.
같은 값이 중복된 입력의 두 가지 해석 (Duplicate values)
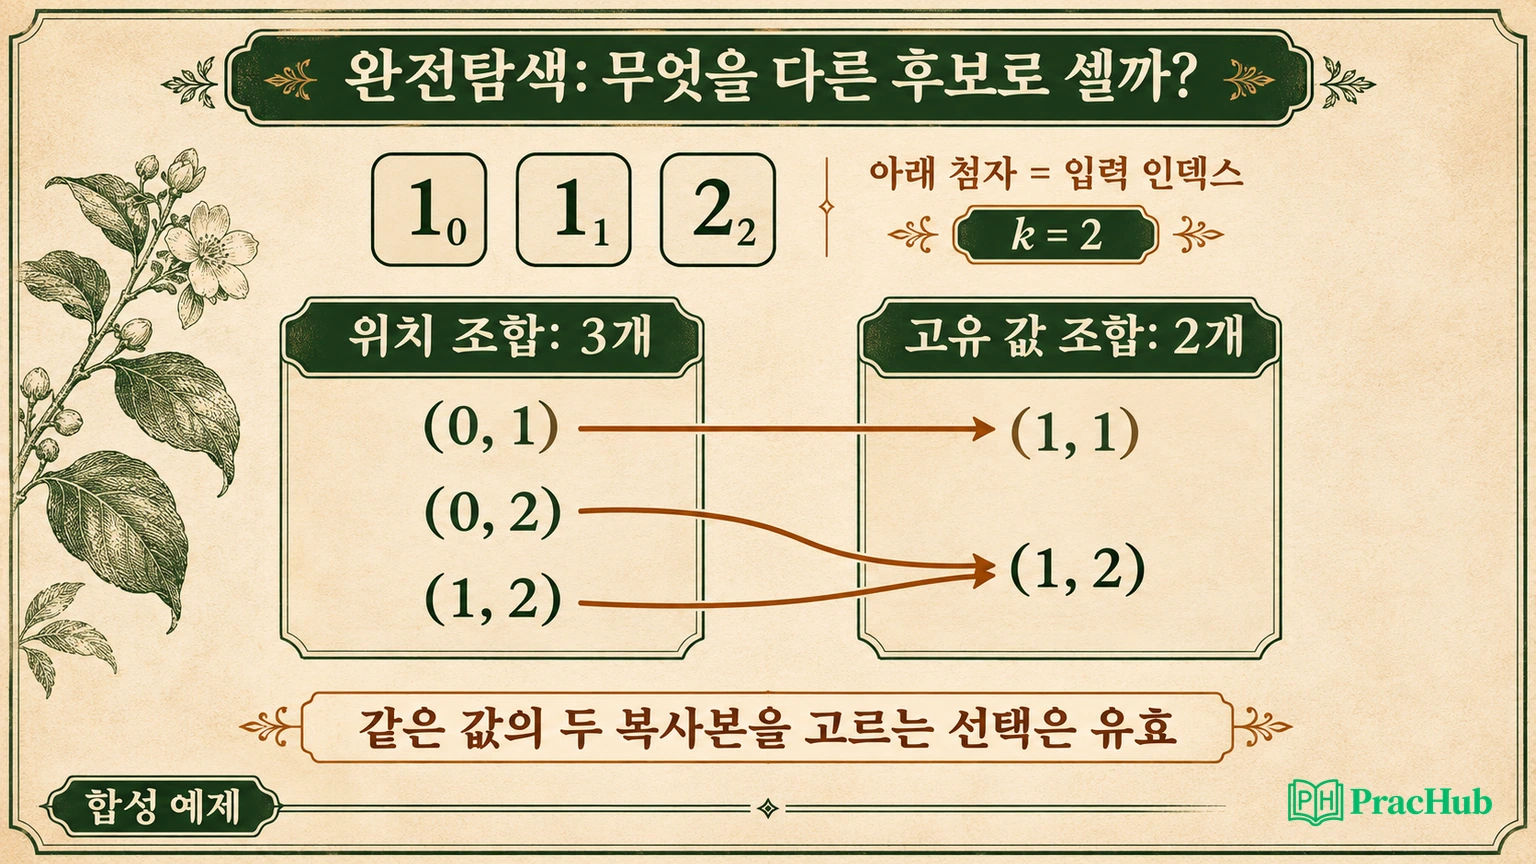
입력 [1,1,2]에서 길이 2의 위치 기반 조합은 (인덱스 0,1), (0,2), (1,2)의 세 개입니다. 그러나 값으로 표현하면 (1,1), (1,2), (1,2)라 두 결과가 같습니다. Python의 itertools.combinations는 원소 값이 아니라 위치를 구분하므로 결과에 값 중복이 생길 수 있습니다.
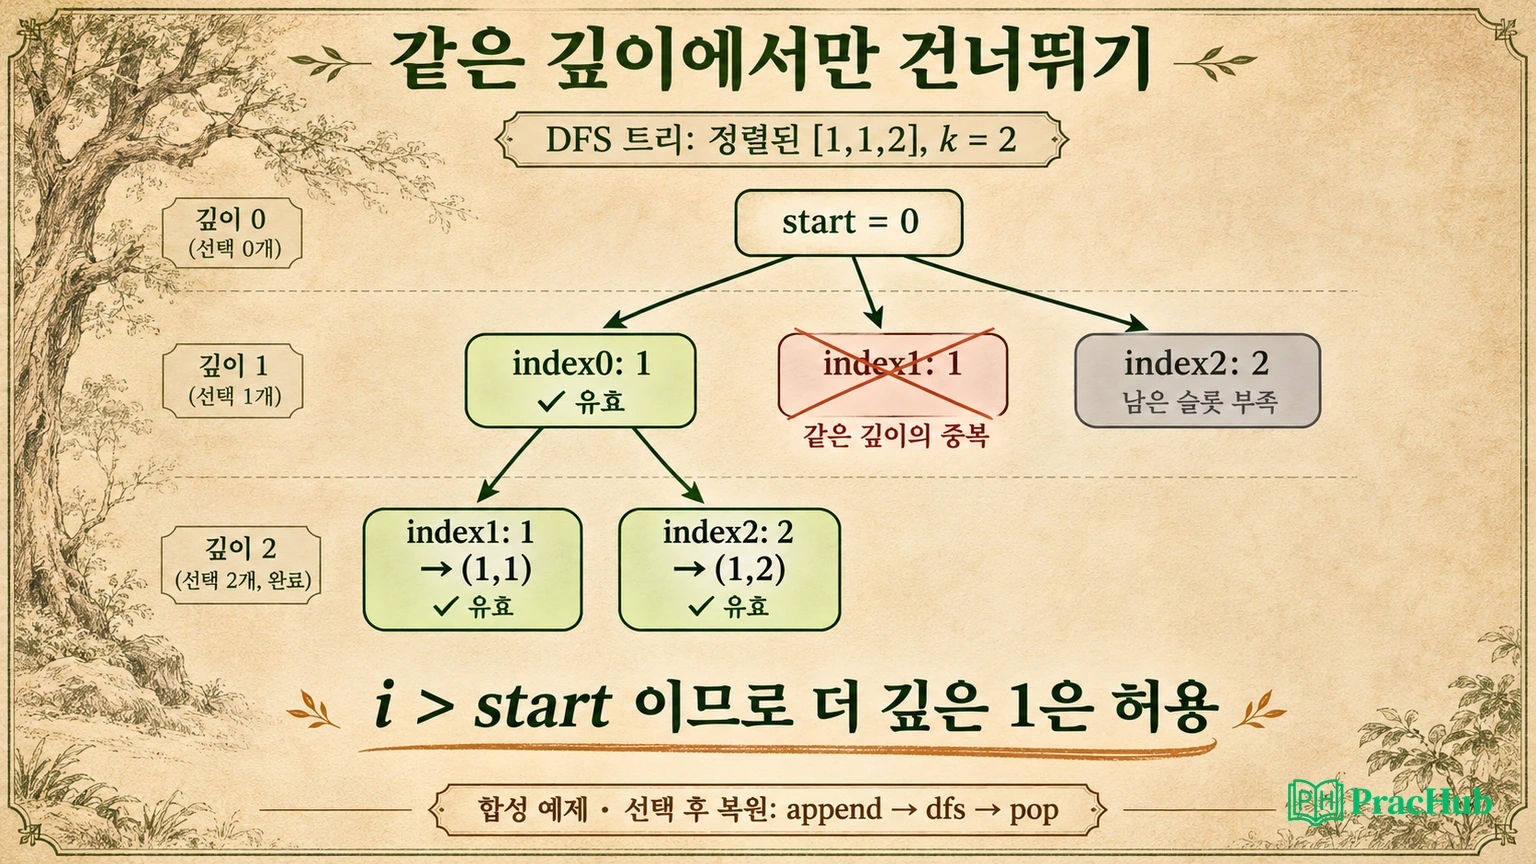
고유한 값 조합만 원한다면 정렬한 뒤 같은 재귀 깊이에서 이미 처리한 값을 건너뜁니다. 이는 “같은 값은 한 번만 선택할 수 있다”는 뜻이 아닙니다. [1,1,2]에서 (1,1)은 서로 다른 두 위치를 선택했으므로 유효합니다.
def unique_value_combinations(nums, k):
    nums = sorted(nums)
    out, path = [], []
    def dfs(start):
        if len(path) == k:
            out.append(tuple(path))
            return
        need = k - len(path)
        for i in range(start, len(nums) - need + 1):
            if i > start and nums[i] == nums[i - 1]:
                continue  # 같은 깊이의 동일 값 선택만 생략
            path.append(nums[i])
            dfs(i + 1)
            path.pop()
    if 0 <= k <= len(nums):
        dfs(0)
    return out
k=0은 빈 조합 하나, k>n은 결과 없음이라는 계약을 코드로 분명히 했습니다. 재귀 후 path.pop()은 다음 가지가 현재 가지의 상태를 물려받지 않게 하는 복원입니다.
값이 같은 입력이 실제로는 서로 다른 객체라면 값만으로 중복을 제거해서는 안 됩니다. 가격이 같은 상품 두 개라도 재고 ID가 다르면 선택 결과가 달라질 수 있습니다. 먼저 원소의 식별 단위가 값인지 인덱스인지 별도 ID인지 정하고, 출력도 같은 기준으로 비교해야 합니다. 수열을 고유한 값 목록으로 만드는 문제가 아니라 실제 입력 항목을 선택하는 문제라면, 같은 값의 다른 위치를 보존하는 편이 맞습니다.
또한 중복을 탐색 중 생략하는 방식과 끝에서 set으로 합치는 방식은 정답 집합은 같아도 비용이 다릅니다. 끝에서 제거하면 중복 경로가 모두 실행되고 결과 저장 공간도 필요합니다. 정렬 후 같은 깊이에서 건너뛰면 생성 단계에서 가지를 줄일 수 있지만, 재귀 복원과 i > start 조건을 정확히 유지해야 합니다. 어떤 방법을 고르든 중복 제거 전후의 후보 수를 작은 입력으로 확인하세요.
가지치기를 증명하는 법 (Safe pruning)
조합 탐색에서 남은 슬롯 수보다 남은 원소 수가 적으면 더 진행할 수 없으므로 반복 상한을 len(nums)-need+1로 줄일 수 있습니다. 합이 목표보다 커졌을 때 자르는 가지치기는 모든 값이 음이 아닌 경우에만 안전합니다. 음수 값이 있으면 뒤에서 음수를 더해 목표로 돌아올 수 있기 때문입니다. 가지치기는 빨라 보인다는 이유가 아니라, 이후 선택으로 조건이 다시 성립할 수 없다는 증명에 근거해야 합니다.
탐색량이 커지면 전략을 바꾸기 (Search budget)
예컨대 n=40의 부분집합은 약 1조 가지라 직접 순회하기 어렵습니다. 이때 n=40을 크기 20인 두 절반으로 나눠 각 절반의 부분집합 합을 저장하고 결합하는 meet-in-the-middle은 대략 2^(n/2) 규모의 중간 목록을 만듭니다. 중복 상태가 많으면 메모이제이션이나 동적 계획법이 유리할 수 있습니다. 실제 입력 제약, 한 후보 평가 비용, 메모리 한도를 함께 보고 선택하세요.
검증은 단순한 기준 구현과 대조하기 (Oracle tests)
작은 n에서는 위치 조합을 직접 생성한 뒤 값 tuple을 set으로 바꾼 결과를 기준으로 삼을 수 있습니다. [1,1,2], k=2의 고유 결과는 (1,1),(1,2) 두 개여야 합니다. 원본 배열이 바뀌지 않는지, 결과가 정렬되어 있는지, k=0, k=n, k>n, 빈 배열을 확인합니다. 순열 문제라면 (1,2)와 (2,1)을 같은 것으로 합치면 안 되는 경우가 많으니 조건을 다시 읽으세요.
다음 연습으로 후보 정의 바꾸기 (Practice)
| PracHub 연습 문제 | 이어서 확인할 점 |
|---|---|
| Generate combinations and permutations | 순서와 선택 기준이 후보 개수에 미치는 영향을 봅니다. |
| Generate unique permutations with duplicates | 중복 값 입력에서 순열 결과를 중복 없이 만듭니다. |
| Solve 3x3 Tic-Tac-Toe with Backtracking: Perfect-Play Result and Best Move | 상태 트리와 탐색량을 실제 게임에 적용합니다. |
| Enumerate Target Combinations with Single-Use Occurrences | 조합 탐색의 상태 복원과 가지치기를 확인합니다. |
| Select words to maximize unique characters | 후보 압축 뒤 부분집합 탐색을 설계합니다. |
순열·조합·부분집합을 코드로 고르는 표 (Counting choices)
| 요구사항 | 생성 단위 | 후보 수 | 순서 민감도 |
|---|---|---|---|
k개를 순서 없이 선택 | 조합 | C(n,k) | 무시 |
k개를 순서 있게 배치 | 순열 | n!/(n-k)! | 구분 |
| 각 원소를 포함/제외 | 부분집합 | 2^n | 보통 무시 |
길이 k, 반복 선택 허용 | 곱집합 | n^k | 구분 |
이 수식은 항목이 서로 구별된다고 가정합니다. 값이 중복되면 서로 다른 위치에서 나온 결과가 값 기준으로 같아질 수 있습니다. 결과를 후보 생성 중 중복 제거할지, 끝에 set으로 합칠지 선택해야 합니다. 끝에서 set을 만들면 중간 계산량은 여전히 중복 후보 수만큼 늘어납니다. 입력이 크면 재귀 깊이와 메모리도 평가해야 합니다.
재귀 복원과 가지치기 로그 (State restoration)
재귀 함수의 인수는 탐색 상태를 나타냅니다. 위 구현의 start는 다음에 고를 수 있는 가장 왼쪽 인덱스이고, path는 지금까지 선택한 값입니다. 같은 깊이에서 중복 값을 건너뛴 후 선택하고 재귀가 돌아오면 path.pop()으로 상태를 이전 노드와 동일하게 복구합니다. 상태 복원은 단순한 코딩 습관이 아니라 DFS 트리의 서로 다른 가지가 같은 메모리를 공유할 때 서로 오염되지 않도록 하는 조건입니다.
가지치기를 넣었다면 최소한 하나의 사례로 “잘라낸 모든 완성 후보가 실패한다”는 근거를 남기세요. 예를 들어 선택 수가 이미 k에 도달하면 답을 저장하고 반환하는 것은 안전합니다. 남은 슬롯보다 후보 인덱스 수가 적을 때 반복을 멈추는 것도 더 선택할 자리가 없어 안전합니다. 그러나 현재 합이 목표보다 크다는 이유만으로 종료하는 것은 음수가 없는 경우에만 안전합니다.
기준 구현을 테스트할 때 볼 세 가지 (Validation)
첫째, 후보 수가 맞는지 확인합니다. 모두 다른 값의 길이 4에서 2개 조합은 6개, 순열은 12개입니다. 둘째, 모든 결과가 조건을 만족하는지 확인합니다. 셋째, 기준 오라클에 빠진 후보가 없는지 검사합니다. [1,1,2]처럼 값 중복이 있는 입력에서는 위치 조합 결과를 값으로 정규화한 집합과 비교해 고유 결과만 반환하는지 살펴봅니다. 이 세 검사는 순서 문제와 중복 문제를 따로 분리해 찾도록 도와줍니다.
다음 연습에서 설명할 한 가지 (Next exercise)
오늘은 Generate combinations and permutations를 풀면서 후보 정의와 탐색량을 먼저 적고 경계 사례 하나와 시간·공간 복잡도를 소리 내어 설명해 보세요. Practice 자료는 연습을 위한 기록이며 실제 시험 문제를 예측하지 않습니다.
DFS 트리와 중복 제거 위치 (DFS trace)
정렬된 [1,1,2]에서 k=2를 선택하는 DFS 트리를 생각해 보겠습니다. 첫 깊이의 인덱스 0에서 값 1을 택하면 다음 깊이에서 인덱스 1의 값 1과 인덱스 2의 값 2를 모두 선택할 수 있습니다. 첫 깊이의 인덱스 1에서 값 1을 다시 시작점으로 선택하는 가지는 앞에서 이미 같은 값으로 시작했으므로 생략합니다. 이렇게 하면 (1,1)과 (1,2)는 남고, 동일한 값 조합 (1,2)를 만드는 두 번째 경로만 사라집니다.
중복 건너뛰기 조건 i > start가 중요한 이유도 여기에 있습니다. 조건을 단순히 i > 0으로 바꾸면 두 번째 깊이에서 같은 값을 선택해 (1,1)을 만드는 유효한 가지까지 제거할 수 있습니다. 중복 제거는 “이 값이 배열에 앞서 나왔는가?”가 아니라 “현재 재귀 단계에서 같은 선택을 이미 시작했는가?”로 판단합니다.
후보 수를 실제 호출 수와 연결하기 (Output cost)
조합 전체 수 C(n,k)는 리프 수이고, 재귀 호출 수는 그보다 큽니다. 부분집합을 만드는 모든 노드 수는 1+2+4+…+2^n=2^(n+1)-1입니다. 각 리프에서 결과를 복사하면 복사 비용도 출력 크기에 비례합니다. 따라서 “완전탐색이 O(2^n)”이라고 말하기보다 후보 개수와 후보 하나를 평가하는 비용을 곱하고, 결과 생성 비용을 별도로 언급하면 더 정확합니다.
실무적 테스트에서는 후보 순서도 확인 대상입니다. 문제에서 사전순이나 입력 순서 보존을 요구한다면 정렬이 요구사항을 바꾸지 않는지 살펴야 합니다. 입력을 정렬하는 구현은 복사본에서 수행하면 원본 배열을 훼손하지 않는다는 점도 보장하기 쉽습니다.
Sources and Further Reading
- Python
itertools.combinations— 조합 생성에서 위치가 서로 다른 원소로 취급되는 공식 정의. - Python
itertools.permutations— 순서 있는 선택과 입력 위치의 구분을 정의하는 문서. - Python data structures: lists as stacks — 경로 상태를 append/pop으로 복구하는 Python 스택 연산 참고.
Comments (0)