Preguntas de Python para entrevistas: mutabilidad, iteradores y estructuras de datos
Quick Overview
Original CPython3.12.14 invoices fixture/54actualchecks: raw2300 distinct1300 exhausted0; shallowaliases/defaultstate/deepcopymemo; duplicatepayloadconflict; invalidthirdrowleavespartial1500 versuslocalbuildpreservesprior99butconsumptionnotrollback. Operationcounts distinct100/200/400 list4950/19900/79800 versusdict100/200/400getcalls, nottimebenchmark.
En una entrevista de Python, predecir la salida ayuda poco si no puedes explicar qué objetos cambiaron y qué datos quedan por leer. Practica esas dos preguntas antes de memorizar respuestas sobre listas, generadores o diccionarios. Una suma puede dar cero porque el iterador ya se consumió; una copia puede conservar referencias que creías independientes.
Esta guía utiliza un procesador de facturas ficticias para conectar mutabilidad, iteración y elección de estructuras. El laboratorio descargable incluye datos, implementación y 54 comprobaciones ejecutadas en CPython 3.12.14. Para ampliar después hacia el modelo de datos y otros temas, consulta la guía general de entrevistas Python.
Límite de evidencia: las referencias oficiales explican mecanismos del lenguaje. Los resultados del laboratorio son observaciones de nuestro ejemplo; los consejos de preparación son recomendaciones. No usamos relatos de candidatos para afirmar rondas, frecuencia de preguntas o criterios de contratación. Las preguntas de PracHub sirven para practicar, no para predecir un examen.
Define qué significa procesar una factura
Antes de corregir código, fija el contrato. Aquí cada fila tiene identificador de factura, cliente e importe entero en céntimos. Permitimos importes negativos para representar devoluciones. Exigimos cadenas no vacías para los identificadores y rechazamos importes booleanos: el validador comprueba type(cents) is int. Es una decisión del ejercicio, no una regla universal de facturación.
| Fila | Factura y cliente | Céntimos | Etiqueta |
|---|---|---|---|
| 1 | I-1 / C-1 | 1000 | new |
| 2 | I-2 / C-2 | 500 | sin etiqueta |
| 3 | I-1 / C-1 | 1000 | retry |
| 4 | I-3 / C-1 | −200 | refund |
La tercera fila repite la primera factura. Nuestro contrato acepta una sola vez cada identificador si cliente e importe coinciden; si cambian, genera un error. Las etiquetas quedan fuera de esa comparación. Así, cuatro filas leídas producen tres facturas aceptadas: C-1 suma 800, C-2 suma 500 y el total es 1300. Sumar las cuatro filas sin deduplicar daría 2300.
Al explicar tu solución, distingue filas recibidas de registros aceptados. «Procesé cuatro facturas» ocultaría la repetición. También aclara qué ocurre con un identificador reutilizado para otro cliente. Esa pregunta decide el algoritmo más que escoger primero una comprensión de diccionario.
¿Qué comparte una copia superficial?
Hecho oficial: la documentación de copy distingue copiar un contenedor de copiar recursivamente sus elementos. Una copia superficial introduce referencias a los objetos interiores. La asignación por sí sola vincula nombres; no fabrica otro objeto.
En nuestro caso, rows.copy() crea otra lista, pero su primera posición sigue apuntando al mismo diccionario. Cambiar el importe a través de esa posición cambia el dato que ve la lista original. Por eso no basta con demostrar rows is not copied: necesitas comprobar también rows[0] is copied[0].
Copiar ahora ese diccionario crea otro diccionario, pero ambos conservan una referencia a la misma lista de etiquetas. En el laboratorio, asignar 1250 al importe de la copia deja el original en 1000; añadir checked a las etiquetas aparece también en el original. La diferencia está en qué objeto recibe cada modificación.
deepcopy aísla las etiquetas de este ejemplo, aunque no significa «romper todos los alias». Cuando la entrada contiene dos referencias al mismo objeto, el resultado probado conserva dos referencias a un mismo objeto copiado. Dibuja las flechas antes de proponer una copia profunda; quizá el contrato solo necesita proyectar identificador, cliente e importe a una tupla.
¿Por qué una llamada recuerda la anterior?
Hecho oficial: los valores predeterminados se evalúan cuando se define la función, según el tutorial de funciones. Nuestro ejemplo mínimo permite observar la consecuencia:
def remember_bad(invoice, reviewed=[]):
    reviewed.append(invoice)
    return reviewed
Después de llamar con I-1 y luego con I-2, ambas respuestas apuntan a la misma lista: la primera respuesta también contiene I-2. El problema no es que Python mezcle todas las listas del programa; esas llamadas están usando el mismo argumento predeterminado.
La variante del paquete usa reviewed=None y crea una lista cuando reviewed is None. Además comprueba una llamada con una lista vacía proporcionada por el usuario. Esa lista conserva su identidad y recibe I-3. Reemplazarla con reviewed = reviewed or [] cambiaría ese contrato, porque una lista vacía se evalúa como falsa.
Explica quién posee el estado y cuánto debe durar antes de cambiar la función. Si el historial tiene que compartirse, hazlo explícito en la interfaz y prueba su limpieza. Si debe pertenecer a cada llamada, evita esconderlo en un valor predeterminado mutable.
Contar el generador también lo consume
Hecho oficial: el tutorial de iteradores describe el avance mediante next() y el final con StopIteration. Un generador permite producir elementos bajo demanda; no promete que la misma instancia pueda recorrerse otra vez desde el principio.
Este fragmento usa las funciones incluidas en el paquete:
stream = iter_validated(rows)
count = sum(1 for _ in stream)
summary = summarize_parsed(stream)
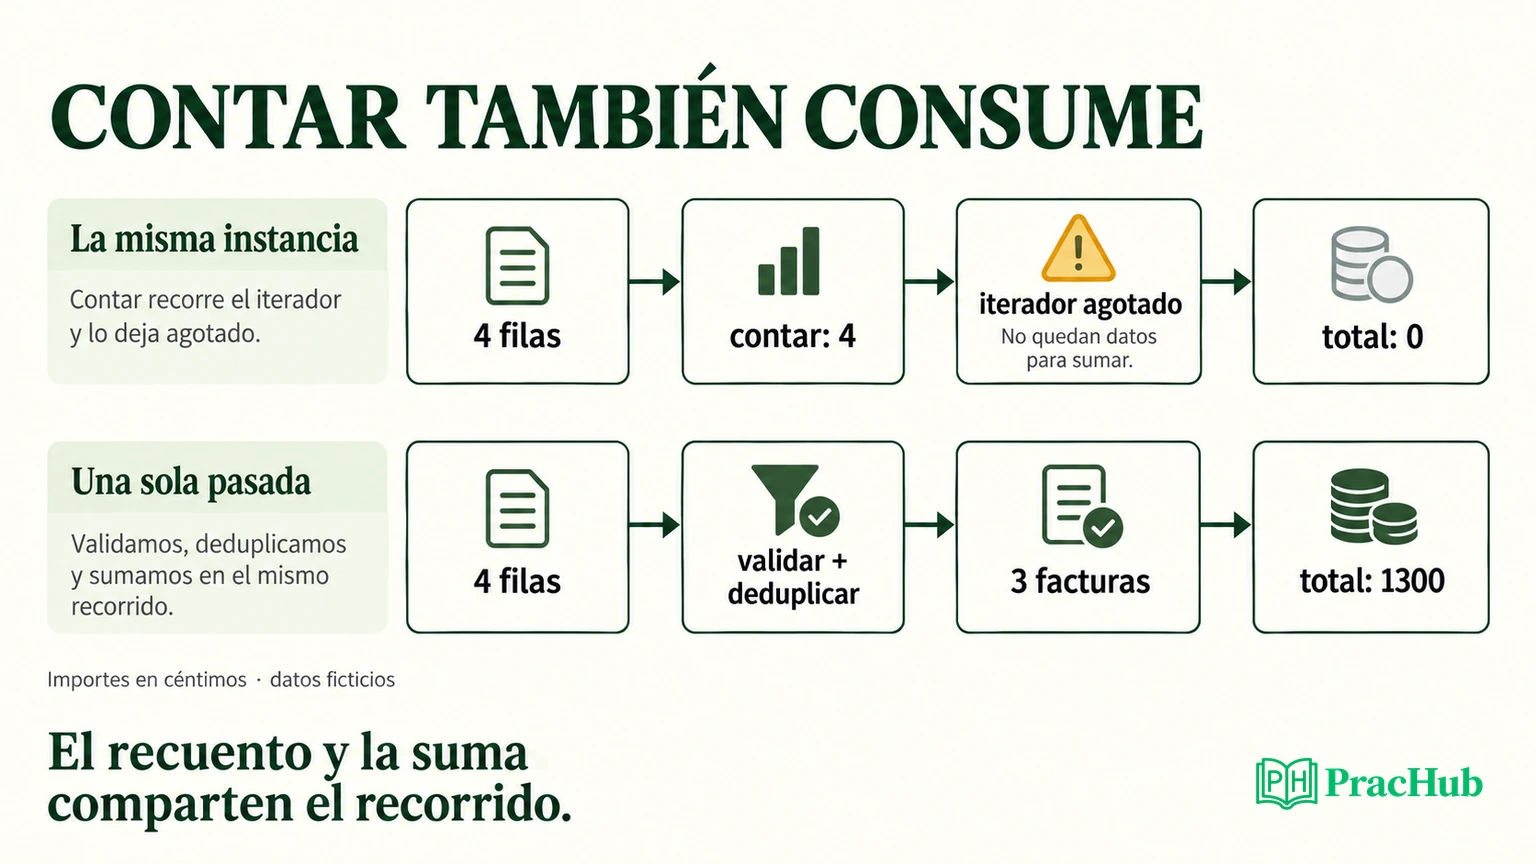
La traza registra cuatro filas durante el recuento. Después, el resumen devuelve cero filas y total cero. No significa que las facturas originales sumen cero. El segundo consumidor no recibe elementos porque el primero agotó la instancia. Tras ese segundo recorrido vacío, next(stream) termina con StopIteration; llamar a iter(stream) tampoco crea otra instancia.
Para este contrato recomendamos calcular recuento y acumulación en una sola pasada. build_summary(rows) devuelve ambos contadores y el total 1300; no necesita recorrer antes el generador para saber cuántas filas contiene. El recuento se incrementa antes de decidir si una factura es repetida, de modo que sigue siendo cuatro.
Si necesitas varias pasadas, materializar list(iter_validated(rows)) es otra decisión posible. En el ensayo obtenemos cuatro tuplas y podemos resumirlas dos veces con resultado 1300. A cambio, guardamos la colección completa. Crear un generador nuevo sobre una fuente externa tampoco garantiza leer la misma versión de los datos. El ejemplo trabaja con una lista local fija; no demuestra consistencia entre lecturas de archivos o servicios cambiantes.
Deduplicar exige algo más que guardar identificadores
Hechos oficiales: el tutorial de estructuras de datos presenta conjuntos para elementos únicos y diccionarios para asociaciones mediante claves; los diccionarios conservan el orden de inserción y los conjuntos no ofrecen ese mismo contrato de orden. Las claves deben ser hashables.
Para responder «¿ya vi esta factura?» podría bastar un conjunto. Aquí también debemos detectar conflictos, así que almacenamos invoice -> (customer, cents) en seen. Una repetición idéntica se omite; una repetición con otro importe se rechaza. La lista final de identificadores sale del orden de primera inserción: I-1, I-2, I-3.
Una comprensión como {row['invoice']: row for row in rows} conserva un solo valor por clave, pero no implementa nuestra validación de conflictos. En la ejecución, I-1 ocupa la primera posición y su valor termina siendo la tercera fila, cuya etiqueta es retry. Conservar la posición original no implica conservar el primer contenido.
Elige conscientemente: lista si necesitas posiciones y repeticiones, conjunto para pertenencia sin ese orden, diccionario para recuperar información asociada a una clave. El laboratorio obtiene TypeError al usar una lista como clave y recupera el valor almacenado con una tupla de cadenas. No conviertas eso en «todas las tuplas sirven»: su contenido también tiene que cumplir el requisito de hashabilidad.
Un error tardío puede dejar resultados parciales
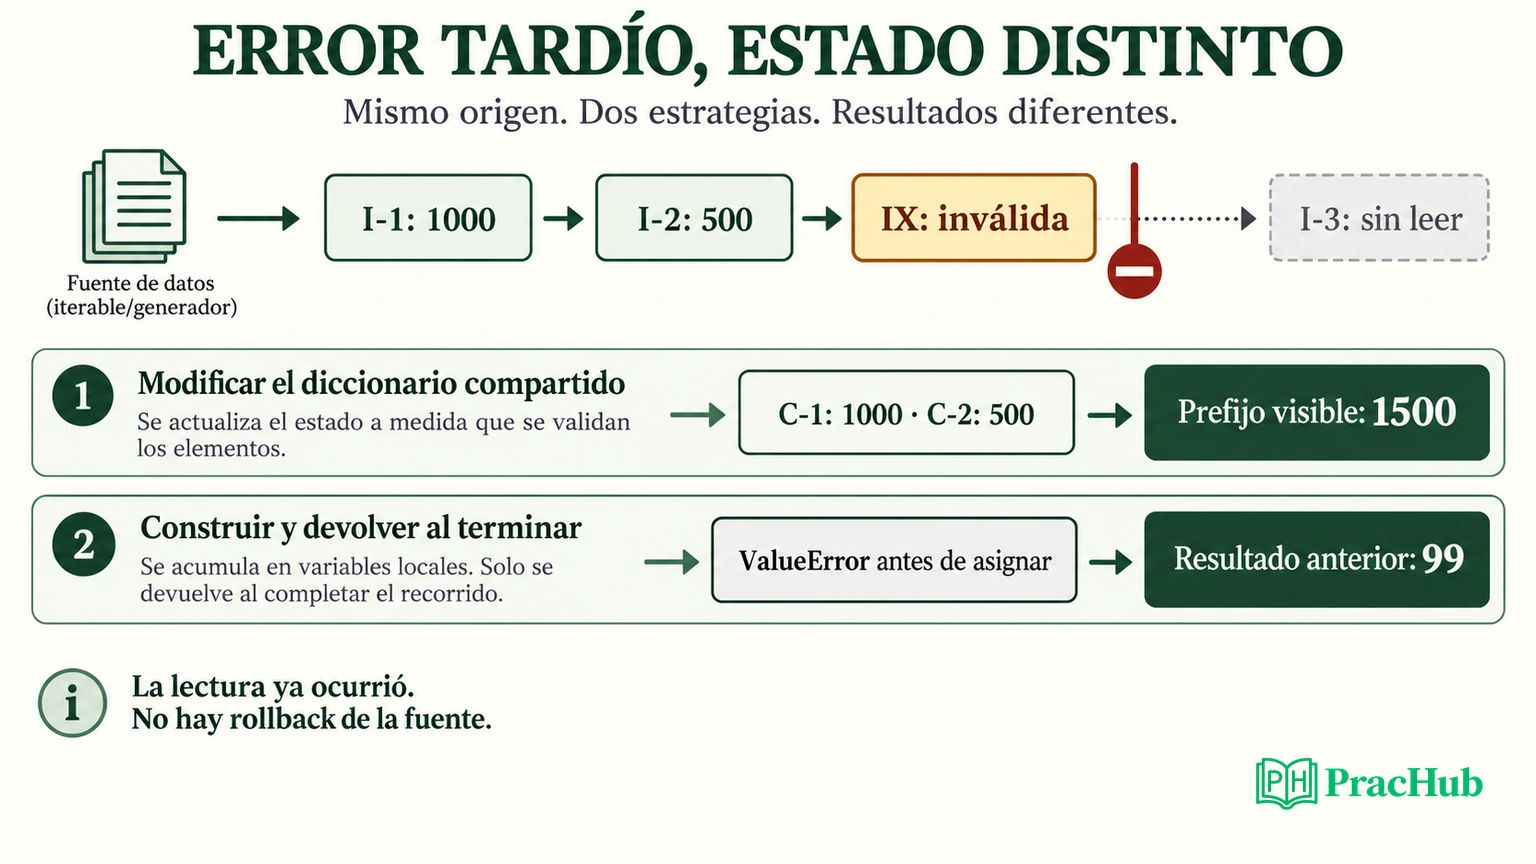
Cambiamos el caso: I-1 e I-2 son válidas, la tercera fila IX trae un importe de texto y la devolución I-3 queda al final. En la versión deliberadamente insegura, accumulate_into modifica un diccionario recibido del llamador mientras consume el generador. No deduplica; aquí solo examinamos el prefijo válido, que contiene identificadores distintos.
Al fallar IX, ese diccionario ya conserva C-1 = 1000 y C-2 = 500. El llamador puede leer esos 1500 céntimos aunque el lote haya fallado: el prefijo ya quedó en el diccionario compartido. La traza contiene I-1, I-2 e IX; I-3 ni siquiera se lee. El generador termina por la excepción y no continúa después como si la fila inválida hubiera desaparecido.
La alternativa construye el resumen en variables locales y devuelve únicamente cuando acaba el recorrido:
published = {'previous': 99}
published = build_summary(bad_rows)  # genera ValueError
Como falla la expresión de la derecha, la asignación no reemplaza published: el llamador conserva su valor anterior. Pero consumir tres entradas sigue siendo un efecto del recorrido. Esta observación no demuestra rollback de un archivo, una base de datos o un cobro externo.
Antes de recomendar «captura la excepción», decide si el contrato admite resultados parciales. Si los admite, devuelve también el estado y la causa. Si exige un resumen completo, evita presentar el prefijo como si fuera el lote entero. La prueba debe mirar el estado que conserva el llamador, además de comprobar que apareció ValueError.
Justifica la estructura con operaciones concretas
La comparación del paquete agrupa pares de cliente e importe de dos maneras. Una busca el cliente recorriendo una lista de grupos; otra utiliza un diccionario. Ambas producen la misma salida, pero contamos operaciones distintas: comparaciones de claves en la lista y llamadas explícitas a dict.get en el diccionario.
Con 100, 200 y 400 clientes distintos, la lista realiza 4950, 19900 y 79800 comparaciones. El diccionario hace 100, 200 y 400 llamadas a get, además de sus asignaciones. Con 100 filas del mismo cliente, la lista necesita 99 comparaciones. Por eso debes indicar si esperas muchos clientes distintos o muchas filas del mismo cliente antes de justificar la búsqueda repetida.
Referencia de implementación: las notas de diccionarios de CPython 3.12.14 discuten operaciones, redimensionamientos y patrones de uso. Bajo las hipótesis habituales de hash y claves, justificamos coste esperado amortizado lineal para agrupar con diccionario y cuadrático para esa búsqueda repetida con clientes distintos. No afirmamos coste constante en el peor caso para cualquier clave o implementación.
Los contadores no miden tiempo, memoria ni el trabajo interno de hashing. No permiten decir «es 199 veces más rápido». En entrevista, explica qué operación contaste, qué entrada la repite y qué suposición podría cambiar la conclusión. Después plantea un benchmark separado si la decisión necesita tiempos reales.
Antes de optimizar, comprueba también qué entrada acepta el programa. Las 54 comprobaciones incluyen importe booleano rechazado, lote vacío y conflicto de importe para I-1. Aceptar una devolución negativa no equivale a aceptar cualquier valor que Python pueda sumar. Un validador demasiado permisivo cambia el significado del resultado antes de que importe la complejidad.
Puedes ampliar el ejercicio con un lote vacío y con una sola factura repetida muchas veces. Predice por separado el número de lecturas, el número de identificadores y el saldo. Después cambia el cliente de una repetición manteniendo su importe: nuestra regla debe rechazarla igualmente. Estas variaciones propuestas no forman parte de las mediciones de rendimiento y no sustituyen los casos ya ejecutados. Sirven para comprobar si la estructura elegida conserva las decisiones del contrato cuando cambia la entrada.
Ensaya la explicación con preguntas concretas
Estas cinco preguntas publicadas permiten extender las decisiones del laboratorio. Su contexto reportado no garantiza que una empresa utilice hoy el mismo ejercicio. Mantén los títulos completos para abrir el enunciado y comprobar sus restricciones. El ejercicio de clases personalizadas usa una interfaz de estilo Java: adáptalo al protocolo Python sin atribuir esa adaptación a la empresa.
| Pregunta de PracHub | Qué practicar después del caso |
|---|---|
| Compare Python Generators, Decorators, and Context Managers | Separar producir valores, envolver una función y gestionar un recurso. |
| Python and pytest Fundamentals: Fixtures, Decorators, and Generators | Aislar el estado entre pruebas y comprobar cuándo se consume un generador. |
| Implement custom iterator classes | Definir avance, agotamiento y el comportamiento de iter(). |
| Implement Composable Range Iterators | Razonar qué recibe cada consumidor al componer recorridos. |
| Debug a Python Aggregation Loop with Dictionaries and Lists | Revisar claves, acumulación y efectos de reemplazar una estructura. |
Descarga el paquete y ejecuta python check.py desde su carpeta con Python 3.12. Primero predice 2300, 1300 o cero para cada variante; luego explica el recorrido que produjo ese número. El recibo incluido guarda 54 comprobaciones ejecutadas con sus valores observados. Solo cubre este laboratorio en memoria; no valida un sistema de facturación ni garantiza un resultado de entrevista.
Para continuar, resuelve Debug a Python Aggregation Loop with Dictionaries and Lists y añade un caso repetido, uno conflictivo y otro que falle después de dos entradas válidas. Tu explicación debe mostrar el resultado, los objetos compartidos y el estado pendiente de consumir. Ahí puedes comprobar si entiendes el programa o solo recuerdas su salida.
Comments (0)