Python面接の質問:参照・イテレータ・例外を実行結果から説明する
Quick Overview
Python面接を、三件の注文インポートで練習します。浅いコピーと深いコピー、ジェネレータの読み取り位置、例外後の部分結果を37項目で検証。一件ずつ反映、全件検証後の反映、行単位の受け付けを比較し、再実行に必要な入力と重複防止の境界を説明します。
Python面接の質問で、copy()、yield、try/exceptの意味をそれぞれ答えられても、三つが同じ処理に現れると説明が止まることがあります。「コピーしたから元のデータは変わらない」「例外を捕まえたから次の行へ進める」「再実行すれば最初から読める」。小さな注文インポートを使えば、こうした予測を一行ずつ確かめられます。
この記事で追うのは、参照先、読み取り位置、出力先の三つです。どのオブジェクトを共有しているか、どこまで入力を消費したか、何をすでに追加したかを分けると、実行結果と修正の理由を一緒に説明できます。
根拠の区分: コピーとジェネレータの言語仕様はPython公式資料に基づきます。注文データ、設計の比較、面接での説明例は独自の練習ケースです。実行結果はCPython 3.12.14で検証しました。特定企業の出題頻度や選考方式を裏づける候補者報告は使用していません。公式の一般仕様と、このケースだけで確認した結果を区別して読み進められるよう、各所で根拠を示します。
まず三件の注文と失敗時の約束を決める
独自ケースでは、注文を入力順に確認して、出力先のリストへ追加します。入力は辞書とリストだけで構成し、数量は正の整数とします。O12だけ数量が0なので検証に失敗します。
from copy import deepcopy

def source():
    return [
        {"id": "O11", "lines": [{"sku": "A", "qty": 2}]},
        {"id": "O12", "lines": [{"sku": "B", "qty": 0}]},
        {"id": "O13", "lines": [{"sku": "C", "qty": 3}]},
    ]

def validate_order(row):
    for line in row["lines"]:
        qty = line["qty"]
        if type(qty) is not int or qty <= 0:
            raise ValueError(
                f'{row["id"]}: qty must be a positive int'
            )
    return deepcopy(row)

def checked_orders(rows):
    for row in rows:
        yield validate_order(row)
この検証関数は、固定した入力形式を前提としています。キーの欠落、空の明細、SKUの存在確認、注文IDの重複などを網羅するAPI入力検証器ではありません。面接では「ここでは数量だけを検証し、実際の入力形式を広げるなら別の検証を追加します」と範囲を先に伝えると、どの例外を想定しているかも明確になります。
type(qty) is not intは、この練習で真偽値を数量として受け付けないための選択です。型の扱いを曖昧にしたまま、Trueが通るかどうかを出力だけで推測しないようにします。独自の数値型を受け入れる要件なら、この条件から見直します。
実装前に確認したいのは「O12が不正だったとき、O11を残してよいか」です。一件ずつ反映する、全件の検証が終わってから反映する、有効な行だけ反映して不正な行を報告する。この三つは別の契約なので、後で例外処理を足すだけでは同じ結果になりません。
copyした辞書の明細は誰のものか
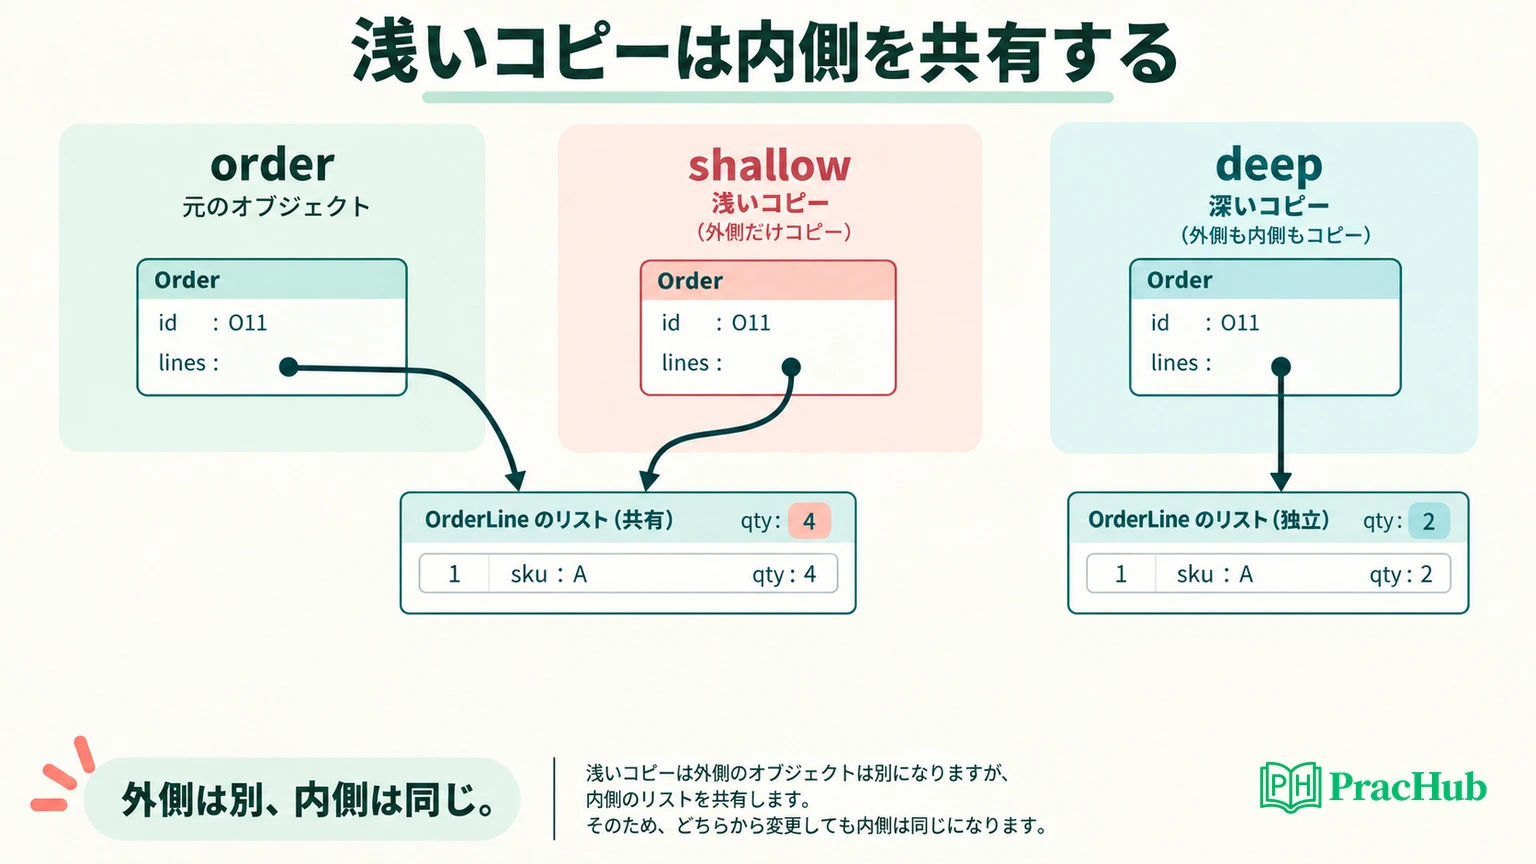
公式仕様: 代入はオブジェクトを複製せず、名前とオブジェクトを結びつけます。浅いコピーは外側を新しく作りますが、内側のオブジェクトへの参照を引き継ぎます。深いコピーは内側も再帰的にコピーします。Python公式のcopy資料で確認できます。
次のコードは、元の注文、浅いコピー、深いコピーを同じ時点で作ってから、浅いコピー側の数量を変更します。実行前に、最後の二行の結果を予測してください。
order = source()[0]
shallow = order.copy()
deep = deepcopy(order)

shallow["lines"][0]["qty"] = 4
print(order["lines"][0]["qty"])
print(deep["lines"][0]["qty"])
4
2
ローカル検証結果: shallow is orderは偽ですが、shallow["lines"] is order["lines"]は真です。外側の辞書が別でも、明細リストとその中の辞書を共有しています。一方、先に作ったdeepの数量は2のままです。
ここでshallow["id"] = "OTHER"と代入し直すと、元のorder["id"]はO11のままです。内側の辞書を書き換える操作と、外側の辞書で値を結び直す操作を、同じ「変更」という言葉で済ませないことが説明のポイントになります。
「SKUは文字列で変更不能だから安全です」という答えにも、確認が必要です。このデータでは、変更可能な明細辞書とリストが文字列を包んでいます。注文全体の変更可能性は、一つの値だけでは決まりません。どの階層を誰が変更できるかを図で示せれば、コピーが必要な境界も説明できます。
設計上の判断: このケースでは、検証済みの注文を入力側の後続変更から切り離すため、validate_orderが深いコピーを返します。公式資料も、深いコピーが共有すべき情報まで複製し得ることを説明しています。すべての処理へ無条件にdeepcopyを追加する提案にはしません。入力の所有者、データ量、共有したい要素を確認し、必要な階層だけ新しく作る設計とも比較します。
ジェネレータが止まる位置を一回ずつ追う
公式仕様: ジェネレータは呼び出すとイテレータを返し、next()で本体を進めます。yieldで値を渡して停止し、その後の呼び出しで再開します。処理が終了するとStopIterationになります。内部で処理されなかった例外が外へ出た場合、そのジェネレータの実行は終了します。公式のジェネレータの説明が根拠です。
it = checked_orders(source())
print(next(it)["id"])

try:
    next(it)
except ValueError as exc:
    print(exc)

print(list(it))
O11
O12: qty must be a positive int
[]
最後がO13にならない理由を、順番で説明しましょう。最初のnext()はO11を検証して返します。二回目はO12の検証中にValueErrorが外へ出ます。呼び出し側は例外を捕まえますが、終了したジェネレータの内部をO13から再開することはできません。
| 呼び出し | 到達した入力 | 呼び出し側が受け取るもの | 同じitを次に読むと |
|---|---|---|---|
checked_orders(...) | 本体の読み取りは未開始 | ジェネレータ | O11の検証へ進む |
一回目のnext(it) | O11 | 検証済みO11 | O12の検証へ進む |
二回目のnext(it) | O12 | ValueError | StopIteration |
例外後のlist(it) | 新たな注文には到達しない | 空リスト | 以後も終了状態 |
ここでの遅延実行は、checked_orders本体の検証についての話です。source()という引数の式は、その前に評価されます。また、ジェネレータ式の外側の入力評価まで、何でも遅延するという一般化は避けます。
ローカル検証では、入力を読むたびにIDを記録する補助ジェネレータも使いました。生成直後の記録は空で、一回目のnext()後はO11、例外後はO11とO12でした。O13が未処理であることを、出力先の件数とは別に確認しています。
例外は追加済みのO11を取り消すか
次は、一件ずつ出力先へ追加する実装です。destは呼び出し側が用意するメモリ上のリストとします。
def import_stream(rows, dest):
    for order in checked_orders(rows):
        dest.append(order)

dest = []
try:
    import_stream(source(), dest)
except ValueError:
    print([row["id"] for row in dest])
['O11']
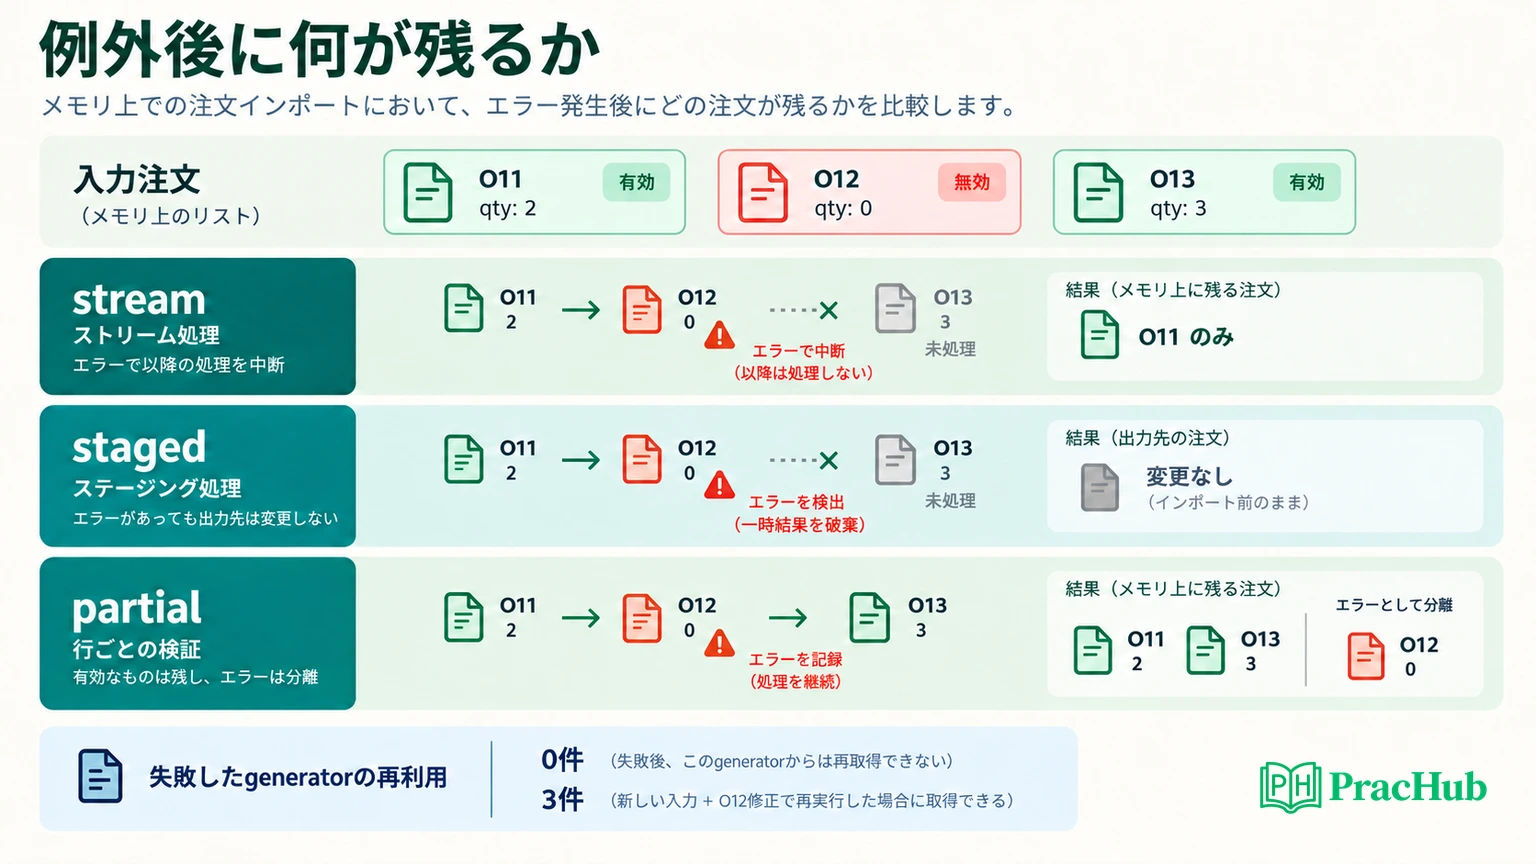
ローカル検証結果: O11の追加は、O12の検証より前に終わっています。例外を捕まえても、過去のappendを自動で元に戻す処理はありません。O13も追加されません。例外を表示した後も、出力先の内容が元に戻ったかは、リストを見て別に確認する必要があります。
面接では「失敗したので何も保存されません」と言い切る前に、副作用が起きる行を指します。この実装ならappendが境界です。さらに、返す注文が入力から独立しているかも確認します。本例では深いコピーを追加しているため、後で元のO11の数量を99に変えても、出力先の数量は2でした。
既存の注文がdestに入っている場合、例外時にdest.clear()を呼ぶ修正は要注意です。今回の呼び出しより前に存在したデータまで消してしまいます。どのデータを誰が所有し、今回追加した分だけ戻すのか、そもそも検証完了まで追加しないのかを確認してから、反映方法を選びます。これはケースから導いた設計上の助言です。
全件検証してから反映すると何が変わるか
「数量が不正なら、今回の呼び出しでは出力先を変更しない」という契約なら、先に検証結果を一時リストへ集める方法を比較できます。
def import_staged(rows, dest):
    pending = list(checked_orders(rows))
    dest.extend(pending)
    return len(pending)
ローカル検証結果: O12で想定したValueErrorが起きると、list(...)が完了しないため、dest.extendへ到達しません。空の出力先は空のままで、既存注文OLDを一件入れた出力先も、内容とその注文オブジェクトの同一性を保ちました。O13の検証は行われていません。
一時リストにはO11まで追加されていますが、それを出力先へ反映する行はまだ実行されていません。「途中結果がどこにも存在しない」ではなく、「途中結果を出力先へ公開していない」と説明すると、状態を正確に追えます。
この変更にはコストもあります。検証済み注文をまとめて保持するので、入力が大きいほど一時的なメモリが必要です。また、ここで確認したのは、検証中の数量エラーに対するメモリ上の出力先の状態だけです。extend中のメモリ不足、同時更新、プロセス終了、データベースや外部APIへの反映が同じ保証を持つとは確認していません。
外部へ書き込む課題に変わったら、トランザクションの範囲、途中結果の公開方法、再送時の識別方法を新たに設計します。Pythonの一時リストだけを根拠に、永続化まで原子的だとは答えません。
同じイテレータで再実行すると0件になる
次の呼び出しは、見た目だけなら「失敗後にもう一度試す」コードです。実際に何を再利用しているかを確認してください。
failed = checked_orders(source())
dest = []
try:
    import_staged(failed, dest)
except ValueError:
    pass

print(import_staged(failed, dest))
print(dest)
0
[]
ローカル検証結果: 最初の処理でfailedは終了しています。二回目はその同じイテレータから何も取得できず、空の一時リストを反映して0を返します。「例外が出なかった」という観察だけなら、空の処理を成功と見誤る可能性があります。
再実行の準備には、もう一度読める入力が必要です。ただし、新しくsource()を呼んでもO12の数量は0のままなので、同じエラーになります。本例では、新しい入力を用意し、O12の数量を1へ修正してから、三件が入力順に反映されることを確認しました。
fixed = source()
fixed[1]["lines"][0]["qty"] = 1
print(import_staged(fixed, dest))
print([row["id"] for row in dest])
3
['O11', 'O12', 'O13']
ここでも再実行と重複防止は別です。同じ修正済みの三件をもう一度反映すると、この実装では六件になります。注文IDで同じ処理を識別する仕組みは実装していません。面接で「再実行して安全です」と答えるなら、入力を読み直せることに加え、すでに反映したO11などを重複させない方法まで説明が必要です。
実際の入力がファイルやネットワークなら、入力を再取得できるか、内容が同じか、読み取り位置を復元できるかも確認します。これは次の設計課題であり、このリストの実行結果だけでは答えられません。
有効な注文を残すなら例外を捕まえる位置を変える
「O11とO13を受け付け、O12だけ不正として返す」という契約なら、行ごとに検証を呼び、その行のエラーを記録します。失敗するジェネレータの外側で捕まえる構造とは異なります。
def import_partial(rows, dest):
    errors = []
    for row in rows:
        try:
            order = validate_order(row)
        except ValueError as exc:
            errors.append((row["id"], str(exc)))
        else:
            dest.append(order)
    return errors
ローカル検証結果: 元の三件に対して、出力先はO11とO13、エラー一覧はO12の一件でした。この実装では、入力を回すループが検証エラー後も続く構造になっています。O13へ到達したことが、先ほどの方式との違いです。
公式の例外処理: tryの範囲と捕まえる例外型によって、どの失敗を処理するかが決まります。elseはtryが例外なく完了した場合に実行されます。公式のエラーと例外の説明を参照できます。
本例ではappendをelseへ置き、数量検証のValueErrorを捕まえる範囲を狭くしています。想定外のキー欠落などは、このエラー一覧へ変換していません。広いexcept Exceptionで何でも不正な数量として扱うと、入力契約の問題と実装の不具合が同じ報告になります。
部分受け付けを採用する場合は、利用者へ何を返すかも仕様です。成功件数だけでなく、どの注文が失敗し、修正後に何を再送するかが必要になります。全件を再送すると、すでに受け付けたO11とO13が重複し得ます。このコードが満たすのは行単位の検証と結果の分離までで、再送の運用は追加の判断です。
実行結果を使って面接の答えを組み立てる
このケースでは、CPython 3.12.14の標準ライブラリだけを使い、37項目を検証しました。浅いコピーの共有、遅延実行、例外後の終了、出力先の途中状態、同じイテレータの再利用、修正済み入力の読み直し、再反映による重複、行単位の失敗分離を含みます。数量の真偽値、負数、小数、文字列も拒否することを確認しました。実際の企業システムや面接の採点基準を検証した数値ではありません。
答えを練習するときは、最初に結果を予測し、実行後に違った箇所だけを説明し直します。たとえば、次の順序なら短い回答でも状態が伝わります。
O11は先に追加されます。O12の検証で例外が外へ出るため、ジェネレータは終了し、O13は未処理です。例外を捕まえてもO11は残ります。数量エラー時に出力先を変更しない要件なら、先に全件検証します。ただし再試行には新しい入力が必要で、二重反映の防止は別途設計します。
続く質問に備え、同じケースの条件を一つ変えます。O12を正常にするとどうなるか。出力先に既存データがあるとどうなるか。入力の数量を反映後に変えるとどうなるか。この三つを実行すると、成功例だけでは見えない所有権と失敗時の契約を確認できます。
さらに練習するなら、次の問題をこの順に比較できます。問題のタイトルは英語ですが、回答は日本語で「予測した状態、観察した結果、変更する理由」を説明してみてください。
| PracHubの問題 | このケースから持ち込む問い |
|---|---|
| Explain Python Immutability, Tuples, Hash Tables, and Caller-Level Errors | 外側の変更不能性と内側の参照、呼び出し側で扱うエラーを分けられるか |
| From Take-Home Script to Production: Python Trade-offs and Hardening a Data Job | メモリ上の検証から外部反映へ進むと、何を追加で保証する必要があるか |
| Integer Set with O(1) Snapshot Iterators Unaffected by Later Changes | 作成後の変更から、読み取り側が見る状態をどう分離するか |
| Design a Resumable Iterator with Checkpoint and Restore | 同じイテレータを再利用することと、位置を復元することはどう違うか |
| Implement a Python test harness | 成功件数だけでなく、失敗後の入力位置と出力先をどう検証するか |
O12で停止した状態を手元で確認してから、再開可能なイテレータの問題で、今回のfailedが持たない情報を挙げてみましょう。単にもう一度呼ぶだけでは復元できない理由を、注文IDと読み取り位置を使って説明する練習になります。
Sources and Further Reading
- Python 3.12: copy — Shallow and deep copy operations — 代入、浅いコピー、深いコピーの公式仕様。
- Python 3.12: Generator-iterator methods — 再開、終了、例外の伝播の公式説明。
- Python 3.12: Errors and Exceptions — try、except、elseの公式説明。
Comments (0)