Questions d’entretien DevOps : diagnostiquer un déploiement et défendre ses choix
Quick Overview
Cas original de diagnostic DevOps en français : Pod Running non prêt à cause du chemin de sonde, modèle explicite de capacité et matrice de lecture v1/v2 sur trois schémas. Laboratoire HTTP local et SQLite avec24vérifications, contre-exemple d’écriture ancienne laissant total_cents NULL et sommes divergentes. Pas de cluster, PostgreSQL, rollback ou test de charge exécuté ; recommandations conditionnelles, questions rapportées distinctes des faits officiels.
Pour préparer les questions d’entretien DevOps, entraînez-vous à transformer un symptôme en décision vérifiable : qui est affecté, quel contrat est rompu, quelle observation distingue vos hypothèses et quelle intervention limite le risque. Reliez chaque commande à une question précise et au résultat qui guidera votre prochain geste.
Nous suivrons un déploiement fictif où le nouveau Pod fonctionne, mais sa sonde vise une route inexistante. Le deuxième piège concerne les données : une ancienne application peut lire une table étendue tout en produisant des écritures incompatibles avec la nouvelle version. Vous pouvez prolonger cet exercice avec les questions DevOps de PracHub.
Frontière des preuves : la documentation officielle étaye les mécanismes cités. Le dossier, les horaires et les décisions sont des constructions pédagogiques originales. Les questions PracHub sont des exercices rapportés, sans prédiction sur une entreprise, ses étapes ou son barème.
Commencez par l’opération qui échoue
Le service du cas expose GET /orders/summary, qui additionne des montants de commandes. Il est en lecture seule dans le scénario initial. La région A reçoit les erreurs après le déploiement ; nous ne disposons d’aucune observation concernant les autres régions. Il faut donc annoncer ce périmètre sans le généraliser.
Demandez le nombre de requêtes affectées, leur fenêtre temporelle et la forme de l’échec. Un 503 à la passerelle, une requête SQL refusée et un HTTP 200 contenant une somme incorrecte conduisent à des investigations différentes. Conservez aussi la révision et la configuration réellement utilisées, plutôt que le seul nom du dernier commit.
Proposition pour ce cas : suspendre l’expansion de la nouvelle version pendant la collecte des preuves. Cette action limite les changements supplémentaires ; elle ne restaure pas les réplicas retirés et ne répare aucune réponse. Distinguez cet effet limité de l’objectif final : rétablir une opération correcte pour les utilisateurs.
Lisez la chronologie sans inventer de causalité
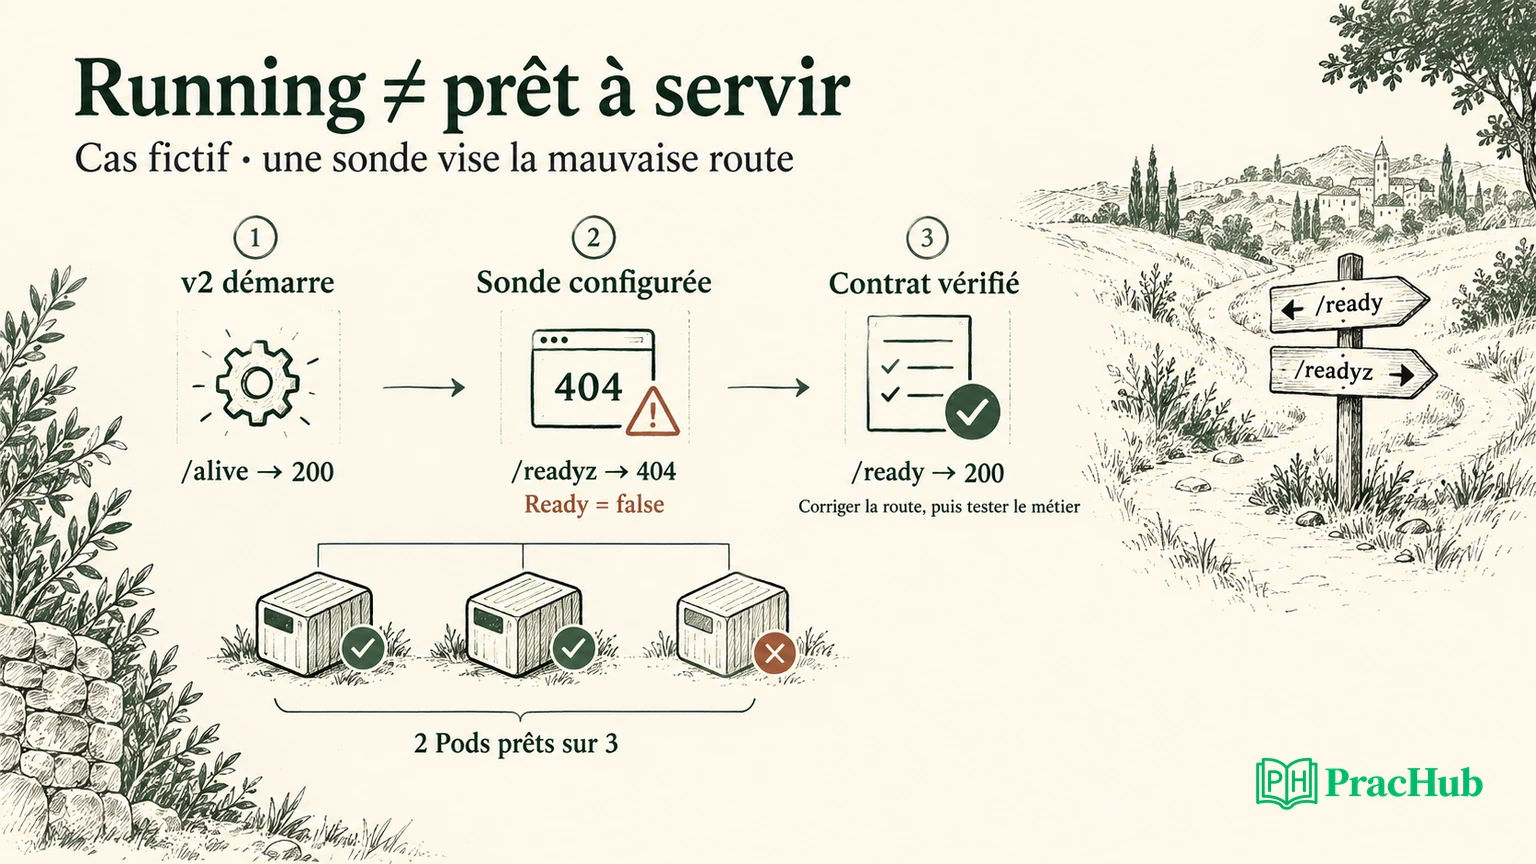
Le dossier téléchargeable fixe trois réplicas souhaités, maxUnavailable: 1 et maxSurge: 0. Avant la mise à jour, trois anciens Pods sont prêts. Dans l’état fictif retenu, un ancien Pod a été remplacé par un nouveau qui reste non prêt ; deux anciens continuent à servir.
| Heure fictive | Changement ou observation | Question suivante |
|---|---|---|
| 10:00 | v1, schéma S1, trois Pods prêts | Quelle opération sert de référence ? |
| 10:02 | S2 ajoute une colonne et recopie les montants | Quelles versions lisent ce schéma ? |
| 10:04 | v2 démarre ; deux Pods restent prêts | Pourquoi le troisième est-il exclu ? |
| 10:05 | /alive répond 200 ; /readyz répond 404 | Quel chemin la sonde doit-elle appeler ? |
Nous supposons ensuite 900 requêtes par minute et une capacité de 300 par Pod prêt. Le calcul max(0, 900 − 2 × 300) donne 300 requêtes au-delà de la capacité supposée. Avec trois Pods prêts, il donne zéro. Ce modèle arithmétique n’est pas un test de charge, ni une prédiction du nombre exact de 503 dans Kubernetes : files, équilibrage et retries sont absents.
Cette limite est utile en entretien. Elle permet de soutenir l’hypothèse d’une capacité devenue insuffisante, puis de demander les vraies mesures. Une proximité temporelle avec le déploiement reste une piste à confronter aux changements de trafic, aux dépendances et aux événements du cluster.
Séparez processus vivant, disponibilité et réponse correcte
Fait officiel : les sondes Kubernetes ont des rôles différents. La readiness détermine l’aptitude configurée à recevoir du trafic via un Service ; son échec ne signifie pas automatiquement redémarrage. La liveness peut provoquer un redémarrage après les échecs configurés. La startup probe protège la phase de démarrage avant les autres sondes.
Dans notre dossier, restartCount=0, le processus est vivant et le nouveau Pod n’est pas prêt. Le laboratoire local reproduit trois réponses HTTP : /alive vaut 200, /readyz vaut 404 et /ready vaut 200. Ces routes sont le contrat de notre application fictive, pas des chemins imposés par Kubernetes.
La distinction élimine une intervention peu fondée : redémarrer tous les Pods ne crée pas la route manquante. Cela peut également supprimer une partie de la capacité restante et effacer des indices utiles. Vérifiez d’abord le manifeste appliqué, le port et les routes réellement exposées par cette version.
Un 200 sur /ready ne certifie toutefois pas la somme renvoyée par /orders/summary. La sonde répond à son propre contrat. Le test métier doit vérifier le contenu, et le suivi utilisateur doit vérifier que les requêtes atteignent effectivement des instances capables de servir.
Choisissez une lecture qui départage deux hypothèses
La documentation officielle de diagnostic des Pods présente notamment l’inspection du statut, des événements et des logs. Pour l’exercice, les commandes suivantes sont des exemples à adapter à un environnement autorisé ; elles n’ont pas été exécutées sur un cluster.
kubectl -n staging get pods -l app=orders -o wide
kubectl -n staging describe pod orders-v2-example
kubectl -n staging logs orders-v2-example --tail=100
kubectl -n staging get deployment orders -o yaml
kubectl -n staging get endpointslices -l kubernetes.io/service-name=orders
La première lecture distingue phase et readiness. Les événements permettent de rechercher un échec de sonde ; les logs relient une requête à un chemin. Le manifeste confirme ce qui est appliqué, et les EndpointSlices aident à examiner les adresses et conditions associées au Service. Le résultat attendu doit précéder la commande.
Supposons que le log montre GET /readyz 404 route_not_found image=v2. Cela prouve qu’une requête a atteint un serveur qui a répondu à ce chemin ; cela ne prouve pas que tous les accès réseau fonctionnent. Si le chemin attendu répond aussi 404, vérifiez plutôt l’image, le préfixe ou la configuration des routes.
Si l’observation devient un timeout, reprenez les hypothèses : port, écoute, filtrage et dépendances peuvent entrer en jeu. Expliquez ce changement de branche. Pendant cette collecte, préférez des références et versions de configuration aux valeurs de secrets ; une comparaison de contrat n’exige généralement pas d’afficher des identifiants.
Réparez le contrat plutôt que le voyant
Dans le scénario établi, la sonde demande /readyz, alors que v2 expose /ready. La correction proposée porte sur ce chemin, après vérification du port et de la réponse attendue. Désactiver la sonde ferait disparaître un signal sans établir que l’application peut servir.
Annoncez aussi comment vous attribuerez le résultat. Une modification isolée du contrat de sonde permet de vérifier si le nouveau Pod devient prêt ; changer simultanément image, schéma et limites CPU rend l’explication plus difficile. En urgence, plusieurs changements peuvent être nécessaires, mais il faut alors nommer l’incertitude introduite.
Pour évaluer une exposition progressive, le Google SRE Workbook sur les canaries recommande des signaux qui permettent de comparer les populations pertinentes. Notre application au cas : séparez les versions, les routes et les régions, puis regardez aussi le volume. Une nouvelle version qui ne reçoit rien peut afficher zéro erreur sans avoir été validée.
Définissez avant la reprise les critères de poursuite et d’arrêt : succès du parcours, contenu correct, latence acceptable et absence du symptôme ciblé sur un trafic représentatif. Les seuils et la durée dépendent du service. Aucun pourcentage ni nombre de minutes du dossier n’est un standard d’entretien.
Testez ce que signifie réellement « rollback compatible »
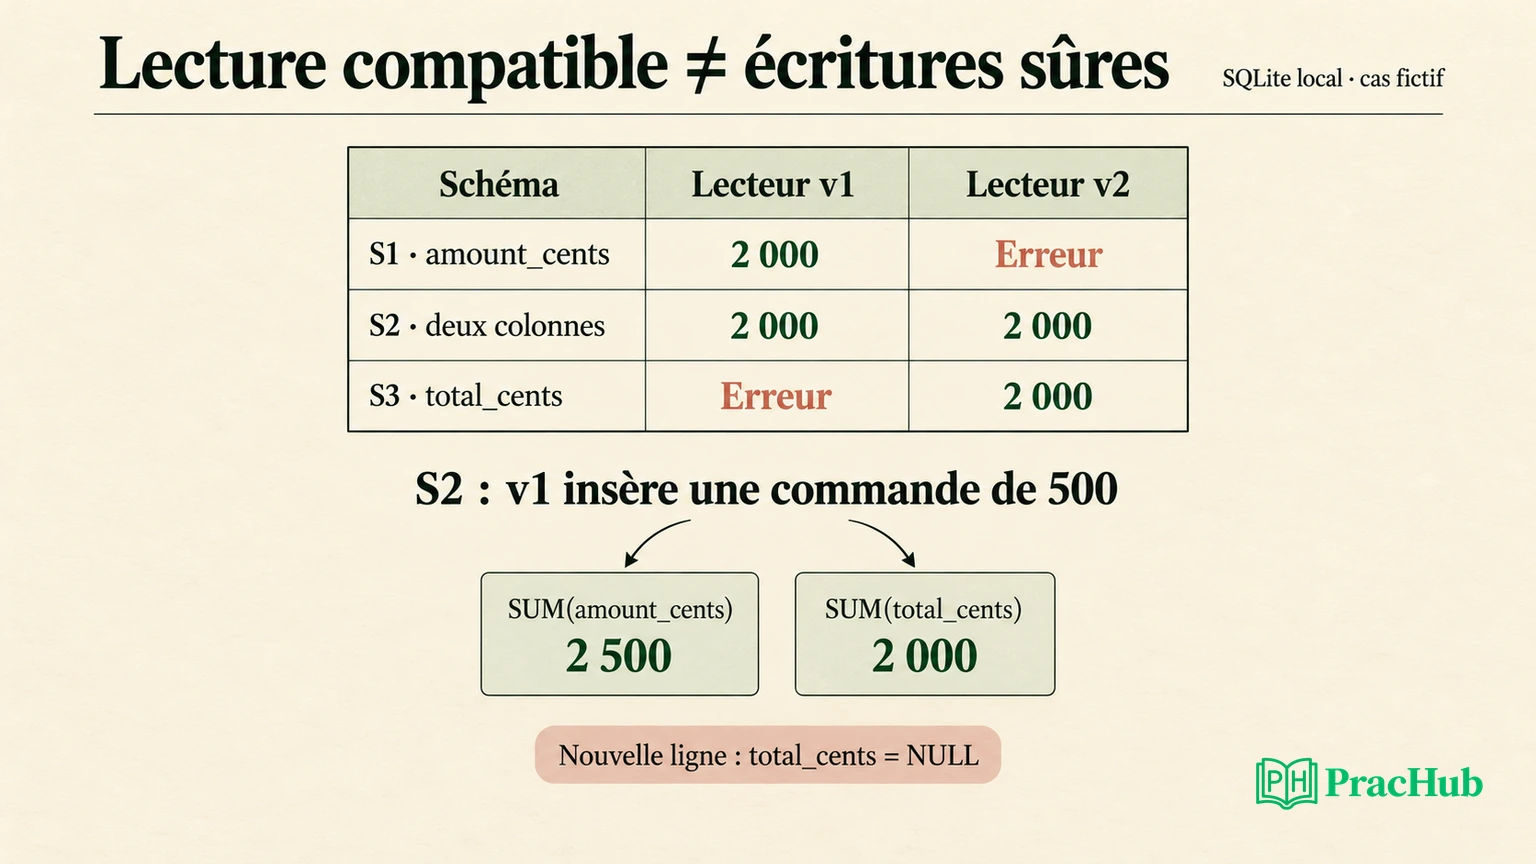
Le laboratoire contient deux commandes de 1 200 et 800 centimes. v1 additionne amount_cents ; v2 additionne total_cents. S1 possède seulement l’ancienne colonne. S2 ajoute la nouvelle puis y recopie les valeurs existantes : ce remplissage rétroactif est le backfill. S3 retire l’ancienne. Chaque cellule ci-dessous correspond à une lecture SQL effectivement exécutée dans SQLite.
| Schéma local | Lecture v1 | Lecture v2 |
|---|---|---|
S1 : amount_cents | 2 000 | Erreur de colonne |
| S2 : deux colonnes, valeurs recopiées | 2 000 | 2 000 |
S3 : total_cents seulement | Erreur de colonne | 2 000 |
Sur S3, revenir au lecteur v1 casse donc l’opération. Fait officiel distinct : PostgreSQL documente la suppression de colonne, qui retire ses données et peut affecter des dépendances. Notre expérience n’a utilisé ni PostgreSQL ni ses mécanismes de verrouillage ; elle illustre seulement un contrat SQL devenu impossible pour l’ancien lecteur.
S2 semble plus rassurant, mais ajoutons une commande de 500 avec l’ancien écrivain. Celui-ci renseigne seulement amount_cents. La nouvelle colonne reste NULL : v1 calcule 2 500, tandis que v2 calcule 2 000, car SQLite additionne les valeurs non NULL pour SUM. Les deux requêtes réussissent, avec des résultats différents.
Une matrice de lectures compatibles ne suffit donc pas à déclarer un rollback sûr pour un service qui écrit. Dans la séquence locale, un backfill explicite puis une insertion renseignant les deux colonnes rétablissent les sommes attendues sur nos quatre commandes seulement. Cela ne démontre aucune synchronisation concurrente, aucun rattrapage exhaustif ni résistance à un arrêt entre deux écritures.
Défendez une décision conditionnelle
Pour le service initial en lecture seule, S2 permet les deux lectures vérifiées. Une réparation du chemin de sonde peut être une intervention ciblée ; un retour à v1 reste une option à examiner avec les autres dépendances. Sur S3, le retour à v1 est incompatible avec notre requête, même si son image démarre parfaitement.
Si l’intervieweur ajoute une écriture, changez votre conclusion. Demandez quels producteurs restent actifs : anciennes instances, jobs, consommateurs et traitements différés. Vérifiez aussi les contraintes, les formats de messages et les effets externes que le retour d’une image ne peut pas annuler.
Une formulation exploitable serait : « Je suspends l’expansion. Les réponses 404 sur le chemin configuré orientent vers un contrat de sonde incorrect. Je vérifie la route attendue et propose une correction isolée. Avant un rollback, je teste les opérations de l’ancienne version sur l’état actuel, y compris les écritures ajoutées à l’énoncé. »
Si la compatibilité reste inconnue, présentez une mesure de limitation du risque et l’information manquante plutôt qu’une certitude. Le choix entre réparer en avançant, revenir en arrière ou limiter certaines opérations doit préciser l’effet utilisateur, le responsable et la condition qui ferait changer de décision.
Vérifiez la reprise et entraînez la restitution
Le dossier local à télécharger fournit cinq fichiers : programme, résultats, matrice CSV, chronologie fictive et README. Exécutez python3 deploy_lab.py depuis son dossier. Il ouvre puis ferme un serveur HTTP local, utilise des bases SQLite en mémoire et réécrit les reçus. Les 24 vérifications ont été exécutées avec CPython 3.12.14 et SQLite 3.53.4 ; chaque valeur attendue et obtenue figure dans results.json.
Elles couvrent les trois routes, les six couples lecteur/schéma, les montants attendus, la divergence après écriture ancienne, le rattrapage explicite et le modèle de capacité. Elles ne valident pas un rollout réel, un rollback, la concurrence ou une performance de production. Modifiez une hypothèse, puis expliquez quel résultat devrait changer avant de relancer.
Après une intervention réelle, reprenez le parcours initial : contenu de la somme, succès par version, trafic, latence et travail différé éventuel. Des Pods prêts constituent un indice nécessaire au routage configuré, pas le verdict final. Conservez la chronologie et proposez un garde-fou qui reproduit le défaut : vérifier la route de sonde avant exposition, ou comparer les sommes après une écriture ancienne.
Les exercices PracHub suivants sont des questions rapportées pour la pratique. Leurs titres complets ouvrent les sujets ; ils n’établissent pas les procédures actuelles des entreprises citées dans leurs fiches.
| Question complète PracHub | Prolongement de ce cas |
|---|---|
| Design and operate a monolith on Kubernetes | Relier exploitation, capacité et contrats de service |
| Describe how you use Kubernetes | Expliquer une décision avec son indice observable |
| Debug Kubernetes crashes and review Python ingestion script | Distinguer crash, readiness et erreur de données |
| Diagnose failures via SSH and large logs | Chercher une ligne qui départage deux hypothèses |
| Reason About Concurrency, CAP Trade-Offs, and Kubernetes Scaling | Ajouter concurrence et capacité sans les confondre |
Ouvrez ensuite une question DevOps sur PracHub et formulez une réponse contestable : observation, hypothèse, lecture suivante, intervention et vérification. En révélant ensuite une écriture ou une colonne supprimée, votre partenaire pourra vérifier si votre décision évolue avec les preuves.
Comments (0)