Вопросы на собеседовании SQL: задачи с проверяемыми результатами
Quick Overview
Оригинальный набор подписок и доставок счетов: текущая версия, неизвестные суммы, сохранение строк, рейтинги и оконные рамки с выполненными запросами.
Запрос выполняется без ошибки и возвращает сумму. Это ещё не означает, что число отвечает на вопрос: повторно доставленный счёт мог попасть в сумму дважды, исправленная версия — остаться рядом со старой, а отсутствие платежей — смешаться с неизвестной суммой. На собеседовании SQL полезно уметь показать такую ошибку на нескольких строках и назвать точный ожидаемый результат.
Разберите авторскую задачу о подписках и счетах. Сначала определим смысл строки, затем проверим очистку, внешнее соединение, агрегирование и равные места в рейтинге. Продолжить практику можно с Deduplicate events and rank products with SQL: там потребуется перенести рассуждение на другой набор событий.
Граница доказательств: семантика SQL опирается на официальную документацию PostgreSQL. Данные, правила выбора версии и ожидаемые результаты придуманы для упражнения. Скрипт в PostgreSQL18.6 сравнил полные результаты десяти запросов с заранее заданными ожиданиями; все сравнения совпали. Это не производственная биллинговая система и не пересказ заданий конкретной компании. Отчёты кандидатов здесь не используются.
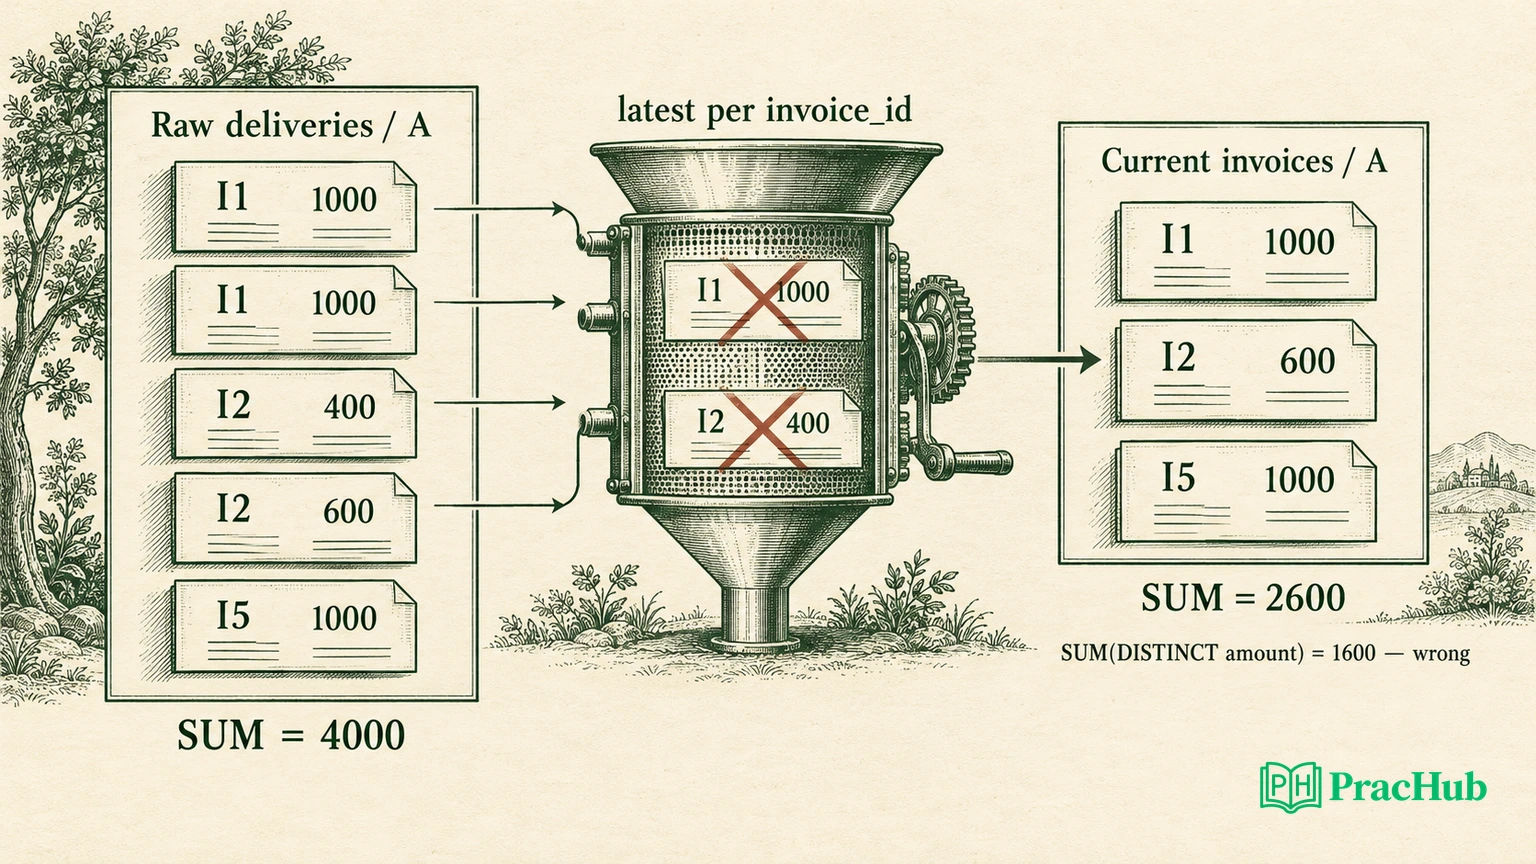
Что именно считается одной строкой?
Таблица subscriptions содержит подписку, тариф и признак активности. В invoice_raw строка означает доставку записи о счёте, а не уникальный счёт. Идентификатор invoice_id задаёт логическую сущность; seq различает доставки. amount выражен в условных целых денежных единицах одной валюты. NULL означает неизвестную сумму, а не ноль.
Авторский контракт выбирает последнюю доставку по received_at, затем по seq. Это упрощение, которое нужно согласовать до написания запроса. В реальной системе время получения сообщения может не совпадать с порядком бизнес-версий. Наличие такого поля само по себе не доказывает, что наиболее поздняя доставка всегда наиболее правильная.
Период отчёта — октябрь2026 по issued_on, интервал от первого октября включительно до первого ноября исключительно. Учитываются только текущие счета paid и активные подписки. Статус void исключается. Не пересчитываем валюты, не распределяем оплату по дням и не называем сумму признанной бухгалтерской выручкой.
CREATE TEMP TABLE subscriptions(
  id text PRIMARY KEY, plan text NOT NULL, active boolean NOT NULL
);
INSERT INTO subscriptions VALUES
('A','pro',true),('B','pro',true),('C','basic',true),
('D','pro',true),('E','basic',false);
CREATE TEMP TABLE invoice_raw(
  seq integer PRIMARY KEY, invoice_id text, subscription_id text,
  status text, amount integer, issued_on date, received_at timestamp
);
INSERT INTO invoice_raw VALUES
(1,'I1','A','paid',1000,'2026-10-01','2026-10-01 10:00'),
(2,'I1','A','paid',1000,'2026-10-01','2026-10-01 10:01'),
(3,'I2','A','paid',400,'2026-10-02','2026-10-02 10:00'),
(4,'I2','A','paid',600,'2026-10-02','2026-10-02 11:00'),
(5,'I3','B','paid',2600,'2026-10-03','2026-10-03 10:00'),
(6,'I4','C','paid',NULL,'2026-10-02','2026-10-02 10:00'),
(7,'I5','A','paid',1000,'2026-10-03','2026-10-03 11:00'),
(8,'I6','D','void',700,'2026-10-04','2026-10-04 10:00'),
(9,'I7','E','paid',800,'2026-10-04','2026-10-04 10:00');
Первый вопрос к данным: сколько доставок относится к A и какова их сырая сумма? Ответ показывает, суммируете ли вы счета или повторные доставки ещё до JOIN.
SELECT count(*) AS rows,sum(amount)AS total FROM invoice_raw WHERE subscription_id='A';
rows | total
5 | 4000
Пять строк и4000 — корректный результат этого запроса, но неверный ответ на вопрос о сумме текущих счетов A. Успех выполнения и правильность бизнес-смысла проверяются отдельно.
Повторная доставка и исправленная версия — разные случаи
Для I1 доставки одинаковы по бизнес-полям: повтор не должен увеличить сумму. Для I2 значения400 и600 различаются: здесь нужно выбрать версию, а не просто удалить одинаковые строки. Официальное описание оконных функций PostgreSQL определяет row_number как нумерацию строк внутри раздела. В упражнении используем её для явного выбора одной доставки.
CREATE TEMP VIEW invoice_current AS
SELECT invoice_id, subscription_id, status, amount, issued_on
FROM (
  SELECT *, row_number() OVER (
    PARTITION BY invoice_id ORDER BY received_at DESC, seq DESC
  ) AS rn
  FROM invoice_raw
) r
WHERE rn = 1;

CREATE TEMP VIEW paid_october AS
SELECT * FROM invoice_current
WHERE status = 'paid'
  AND issued_on >= DATE '2026-10-01'
  AND issued_on < DATE '2026-11-01';
seq обеспечивает однозначный порядок доставок при одинаковом received_at в рамках нашего набора. Выбор не становится бизнес-истиной только благодаря детерминированности. Если источник допускает конфликтующие версии с одинаковым номером, нужен отдельный способ регистрации и разбора конфликта.
SELECT invoice_id,amount FROM invoice_current WHERE subscription_id='A' ORDER BY invoice_id;
invoice_id | amount
I1 | 1000
I2 | 600
I5 | 1000
Остались I1=1000, I2=600 и I5=1000. Два разных счёта законно имеют одинаковую сумму1000. Поэтому идея «убрать дубли через SUM(DISTINCT amount)» теряет реальные деньги:
SELECT sum(amount)AS ordinary,sum(DISTINCT amount)AS wrong FROM paid_october WHERE subscription_id='A';
ordinary | wrong
2600 | 1600
Обычная сумма очищенных счетов равна2600, сумма различных значений amount —1600. DISTINCT не знает, что такое повторная доставка счёта. Покажите два разных счёта по1000: потеря одного из них сразу объясняет, почему DISTINCT по сумме неверен.
Как сохранить подписку без подходящих счетов?
Официальная документация табличных выражений описывает внешний JOIN и применение WHERE к результату соединения. Для нашей задачи нужно сохранить активную D, даже если единственный её счёт имеет статус void. Поэтому правую сторону заранее ограничиваем текущими paid-счетами октября.
CREATE TEMP VIEW report AS
SELECT s.id, s.plan,
       count(i.invoice_id)::int AS invoice_count,
       count(i.amount)::int AS known_count,
       CASE WHEN count(i.invoice_id) = count(i.amount)
            THEN coalesce(sum(i.amount), 0)
            ELSE NULL END AS total
FROM subscriptions s
LEFT JOIN paid_october i ON i.subscription_id = s.id
WHERE s.active
GROUP BY s.id, s.plan;
Мы группируем по подписке, а не по каждой доставке. invoice_id в этом конечном наборе всегда заполнен, поэтому его COUNT показывает количество подходящих счетов. Если разрешить NULL идентификатор счёта, это допущение придётся пересмотреть. Учебная таблица не задаёт полный комплект производственных ограничений целостности.
SELECT * FROM report ORDER BY id;
id | plan | invoice_count | known_count | total
A | pro | 3 | 3 | 2600
B | pro | 1 | 1 | 2600
C | basic | 1 | 0 | NULL
D | pro | 0 | 0 | 0
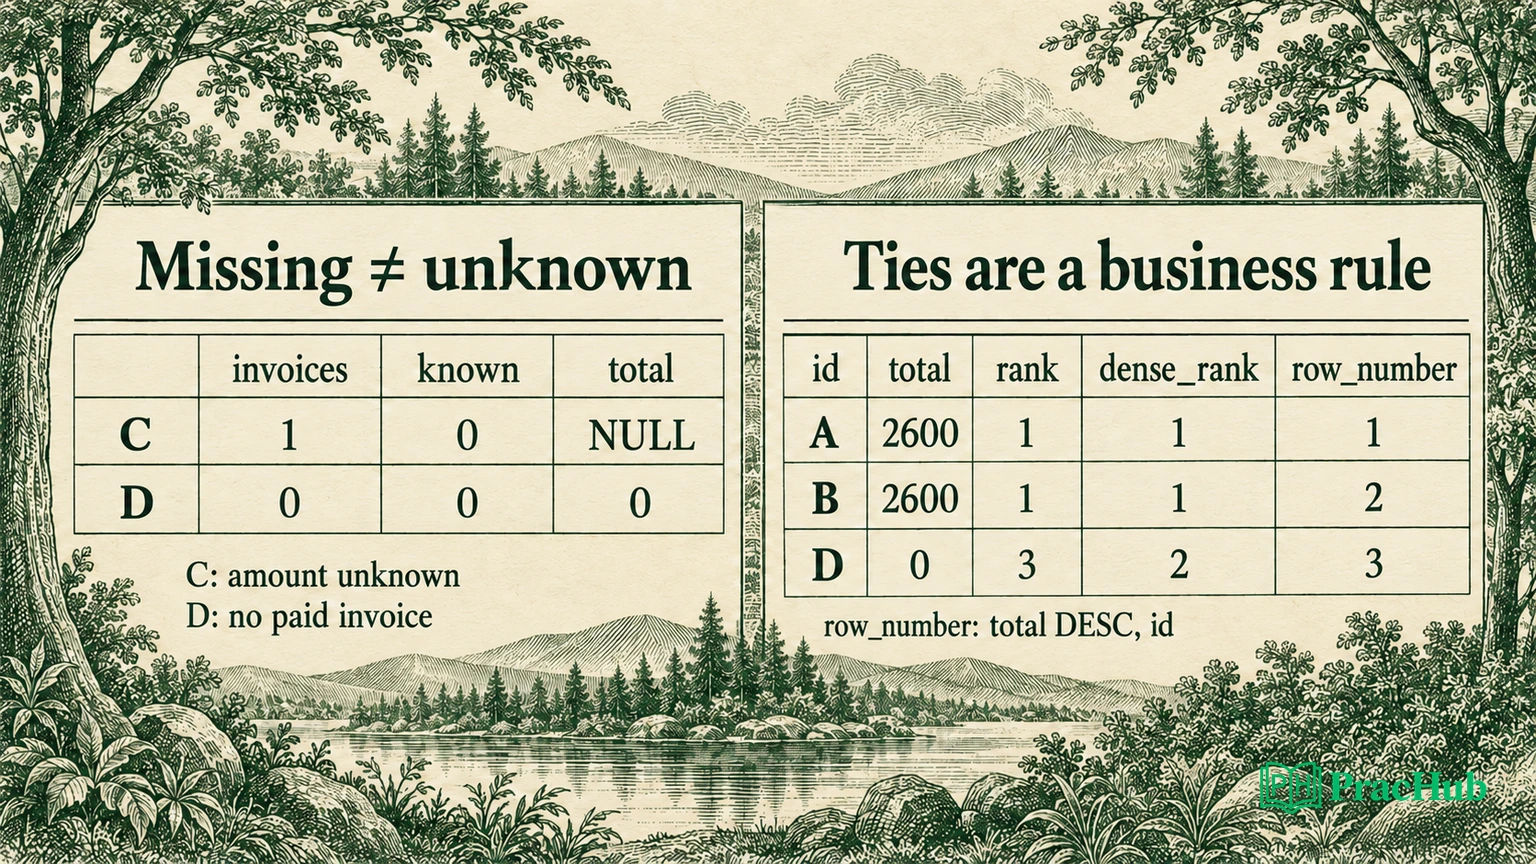
E не попала в отчёт, потому что неактивна. D сохранилась с нулём подходящих счетов. C сохранилась с одним счётом, но его сумма неизвестна. Неактивная подписка, отсутствие paid-счёта и неизвестная сумма требуют разных объяснений в отчёте.
Почему перенос условия в WHERE теряет D?
Рассмотрим соединение со всеми текущими счетами, после которого статус paid проверяется в WHERE:
SELECT DISTINCT s.id FROM subscriptions s LEFT JOIN invoice_current i ON i.subscription_id=s.id WHERE s.active AND i.status='paid' ORDER BY s.id;
id
A
B
C
Полный результат содержит A, B, C. D исчезает: её строка успешно соединилась с I6, но статус void не прошёл фильтр. В этой таблице нет добавленной внешним JOIN пустой строки для D, потому что совпадение уже существовало.
Популярная попытка исправить выражение добавлением OR i.invoice_id IS NULL здесь не помогает:
SELECT DISTINCT s.id FROM subscriptions s LEFT JOIN invoice_current i ON i.subscription_id=s.id WHERE s.active AND (i.status='paid' OR i.invoice_id IS NULL) ORDER BY s.id;
id
A
B
C
Результат снова A, B, C. Контрпример особенно полезен, если кандидат объясняет LEFT JOIN исключительно словами «слева всё останется». Он должен назвать, на каком этапе исчезает строка и почему проверка NULL не восстанавливает её после несовпадения статуса.
В нашем правильном отчёте ограничение правой стороны сделано до соединения. Альтернатива — перенести соответствующие условия в ON. Выбор формы должен сохранять тот же контракт, а не просто давать четыре строки на случайном наборе.
Отсутствие счёта и неизвестная сумма
Согласно официальному описанию агрегатов PostgreSQL, COUNT выражения учитывает не-NULL значения, а SUM игнорирует NULL. Поэтому одно только coalesce(sum(amount),0) скроет различие между C и D. У C есть paid-счёт с неизвестной суммой; у D нет paid-счёта вообще.
Авторское правило отчёта такое: если хотя бы одна сумма подходящего счёта неизвестна, итог подписки тоже NULL. Если счетов нет, итог0. Это выбор смысла показателя. Другой продукт может показывать известный минимум и отдельный флаг неполноты — тогда запрос и подписи результата должны измениться вместе.
SELECT sum(total)AS known_subtotal,count(*)FILTER(WHERE total IS NULL)::int AS unknown_subscriptions FROM report;
known_subtotal | unknown_subscriptions
5200 | 1
5200 здесь — известный подытог A, B и D; неизвестна одна подписка. Называть5200 полной суммой всех активных подписок нельзя. Суммирование итогов снова пропускает NULL, поэтому индикатор неизвестности нужен и на следующем уровне агрегации.
Чтобы найти активные подписки вообще без paid-счетов октября, используем NOT EXISTS относительно той же очищенной правой стороны:
SELECT s.id FROM subscriptions s WHERE s.active AND NOT EXISTS(SELECT 1 FROM paid_october i WHERE i.subscription_id=s.id)ORDER BY s.id;
id
D
Ответ только D. C не подходит, потому что её счёт существует, хотя amount неизвестен. Если изменить вопрос на «без известной суммы», получится другой набор и понадобится другой предикат.
Как объяснить равные места, не скрыв ничью?
В pro-тарифе A и B имеют одинаковый итог2600, D —0. Для рейтинга с сохранением равенства сортируем оконную функцию только по total. Для технического выбора одной строки добавляем id. Не подмешивай id в ORDER BY функции RANK, если равные суммы должны считаться ничьей.
SELECT id,total,rank()OVER(ORDER BY total DESC)AS r,dense_rank()OVER(ORDER BY total DESC)AS dr,row_number()OVER(ORDER BY total DESC,id)AS rn FROM report WHERE total IS NOT NULL AND plan='pro' ORDER BY id;
id | total | r | dr | rn
A | 2600 | 1 | 1 | 1
B | 2600 | 1 | 1 | 2
D | 0 | 3 | 2 | 3
У A и B rank=1, затем D получает3. dense_rank оставляет их на первом месте, но D получает2. row_number присваивает1 и2 двум лидерам согласно id. Оно обеспечивает одну строку на номер, но не делает A экономически лучше B.
Перед запросом Top-1 уточни, нужен ли один победитель или все лидеры. При первом контракте нужен явный критерий разрешения ничьей; при втором фильтр по rank=1 вернёт обе подписки. Мы исключили неизвестные total из этого рейтинга осознанно, а не позволили порядку NULL случайно определить лидера.
Одинаковая дата меняет накопительный итог
В очищенных paid-счетах A и B на третье октября приходятся I3=2600 и I5=1000. Если упорядочить накопительную сумму только по дате, эти строки равны по ключу сортировки. Официальная документация оконных функций описывает значение рамки и строки-равные по ORDER BY. В нашем запросе сравниваем рамку по умолчанию с явной последовательностью строк.
SELECT invoice_id,amount,sum(amount)OVER(ORDER BY issued_on)AS default_frame,sum(amount)OVER(ORDER BY issued_on,invoice_id ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW)AS explicit_frame FROM paid_october WHERE subscription_id IN('A','B')ORDER BY issued_on,invoice_id;
invoice_id | amount | default_frame | explicit_frame
I1 | 1000 | 1000 | 1000
I2 | 600 | 1600 | 1600
I3 | 2600 | 5200 | 4200
I5 | 1000 | 5200 | 5200
В колонке default_frame обе строки третьего октября получают5200. В explicit_frame сначала I3 даёт4200, затем I5 даёт5200. Это не арифметическая ошибка: отличаются рамка и порядок обработки равных дат. Технический invoice_id задаёт последовательность внутри дня; он не заменяет точное бизнес-время операции.
Если требуется итог на конец каждого дня, одинаковое дневное значение может быть правильным. Если требуется пошаговая лента счетов, нужна явная рамка и однозначный порядок. Назови нужный результат до исправления синтаксиса.
Что проверено и что спросить об индексе
Все десять показанных запросов выполнены на одном наборе временных таблиц. Проверка сравнивает полный упорядоченный результат, включая NULL и значения рангов. Она обнаружит замену600 на400, потерю D, ошибочную сумму1600 и исчезновение ничьей. Это полезные условия приёмки, а не количество строк кода ради отчёта.
Время выполнения и планы на производственном объёме не измерялись. На девяти исходных доставках нельзя доказать пользу индекса или преимущество определённого плана JOIN. Для следующего шага запроси объём истории, распределение invoice_id, частоту исправлений и требования к актуальности отчёта. Затем сравни планы на репрезентативных данных. Предложение индекса остаётся гипотезой до такого измерения.
Также не проверялись конкурентная загрузка, конфликт версий, смена валюты и транзакционная согласованность нескольких запросов отчёта. При обсуждении production выдели их отдельными задачами. Учебный результат2600 подтверждает конкретную семантику нашего набора, а не надёжность всей системы расчётов.
Пять упражнений для следующего разбора
Ссылки ведут к англоязычным заданиям PracHub. Сначала объясни решение по-русски на нашем наборе, затем перенеси принцип на другое условие. Не копируй правило «последняя доставка» туда, где требуется иной ключ дедупликации.
| Полный заголовок задания | Что потренировать |
|---|---|
| Deduplicate events and rank products with SQL | Отделить ключ события от значения и определить порядок версий. |
| Compare ROW_NUMBER, RANK, and DENSE_RANK for Top-k Results | Уточнить контракт ничьей до выбора функции. |
| Write SQL for rankings, state, and aggregations | Согласовать гранулярность состояния и итоговой таблицы. |
| Write conditional aggregates with CASE WHEN | Сохранить смысл неизвестного значения при агрегировании. |
| Write SQL using joins and window functions | Предсказать число строк после каждого этапа. |
Начни с Deduplicate events and rank products with SQL. Хороший ответ связывает три вещи: что означает строка, какое правило выбирает результат и какой маленький контрпример опровергает неправильный запрос.
Sources and Further Reading
- PostgreSQL18: Table Expressions — внешние соединения и фильтры.
- PostgreSQL18: Window Functions — ранги, равные строки и оконные рамки.
- PostgreSQL18: Aggregate Functions — COUNT, SUM и NULL.
Comments (0)