SQL — pytania rekrutacyjne i zadania z wynikami zapytań
Quick Overview
Polskie zadania rekrutacyjne SQL na autorskim zbiorze zamówień, pozycji, zapasów w magazynach i rezerwacji. Pełny kod PostgreSQL i sprawdzone wyniki pokazują mnożenie wierszy, COUNT, brak danych, filtry złączeń zewnętrznych, remisy w rankingu i NOT EXISTS. Dziewięć zapytań wykonano w PostgreSQL 18.6; przykład raportowania nie jest implementacją bezpiecznych rezerwacji.
Poprawne składniowo zapytanie SQL może zwrócić błędną liczbę sztuk. Dwie pozycje zamówień połączone z dwoma magazynami dają cztery dopasowane wiersze. Jeżeli dopiero potem zsumujesz zamówioną ilość, zsumowany popyt wzrośnie wraz z liczbą pasujących magazynów, choć zamówienia się nie zmieniły.
Przygotowując się do pytań rekrutacyjnych z SQL, ćwicz przewidywanie konkretnych wierszy, a nie tylko definicje JOIN i GROUP BY. Poniższy zestaw prowadzi od liczności złączenia przez NULL i rezerwacje do remisów w rankingu. Przed każdą odpowiedzią nazwij jednostkę wyniku: zamówienie, SKU czy para SKU–magazyn. Ten sposób rozumowania przećwiczysz też w zadaniu o złączeniach z powtarzającymi się kluczami.
Granica dowodów: reguły języka opisujemy na podstawie oficjalnej dokumentacji PostgreSQL sprawdzonej 11 października 2026 r. Dane, zadania i proponowane kryteria odpowiedzi są autorskimi przykładami dydaktycznymi. Dziewięć zapytań oraz ich oczekiwane wyniki wykonaliśmy w PostgreSQL 18.6. To nie jest relacja kandydata ani lista pytań gwarantowanych w konkretnej firmie.
Dane do uruchomienia: zamówienia i zapasy w dwóch magazynach
Otwórz połączenie z dostępną bazą PostgreSQL i uruchom poniższy kod w jednej sesji. Tabele są tymczasowe, więc kolejne zapytania wykonuj w tym samym połączeniu. Nie potrzebujesz danych klienta ani istniejącego schematu aplikacji.
CREATE TEMP TABLE orders (
  id int PRIMARY KEY, status text NOT NULL
);
CREATE TEMP TABLE items (
  order_id int REFERENCES orders(id), sku text NOT NULL,
  qty int NOT NULL CHECK (qty > 0), PRIMARY KEY(order_id, sku)
);
CREATE TEMP TABLE stock (
  sku text, warehouse text, on_hand int CHECK (on_hand >= 0),
  PRIMARY KEY(sku, warehouse)
);
CREATE TEMP TABLE reservations (
  id int PRIMARY KEY, order_id int REFERENCES orders(id),
  sku text NOT NULL, warehouse text NOT NULL,
  qty int NOT NULL CHECK(qty > 0), status text NOT NULL
);
INSERT INTO orders VALUES
  (1,'open'),(2,'open'),(3,'open'),(4,'cancelled'),(5,'open');
INSERT INTO items VALUES
  (1,'A',2),(1,'B',1),(2,'A',1),(2,'E',1),(3,'C',4),(4,'A',9);
INSERT INTO stock VALUES
  ('A','W1',3),('A','W2',3),('B','W1',0),
  ('C','W1',NULL),('C','W2',5),('D','W1',8);
INSERT INTO reservations VALUES
  (11,1,'A','W1',1,'active'),(12,1,'A','W2',1,'active'),
  (13,2,'A','W1',1,'expired'),(14,3,'C','W2',2,'active'),
  (15,4,'A','W1',1,'active');
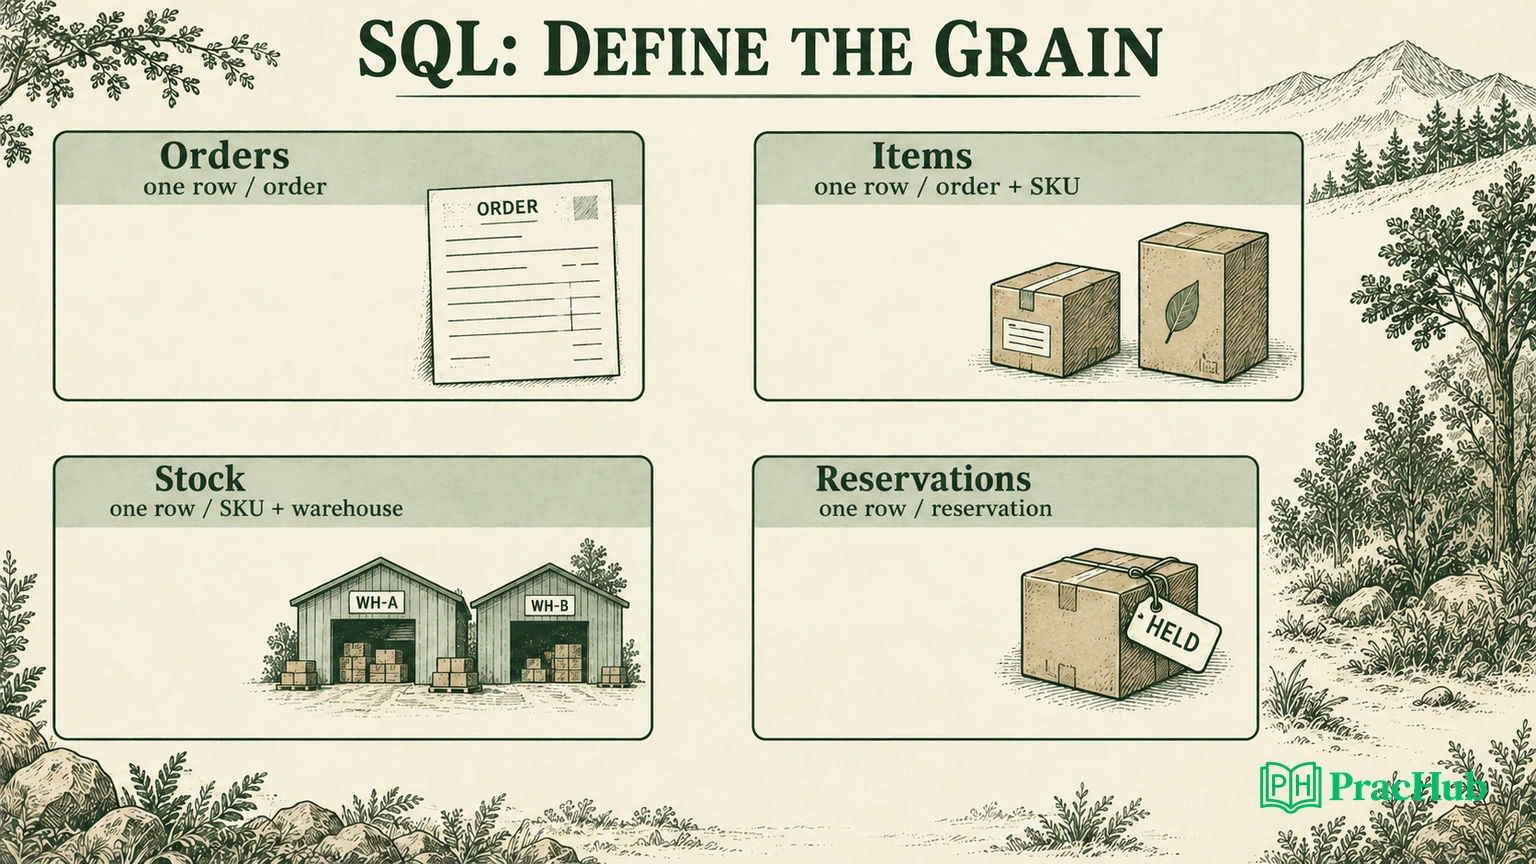
W tym modelu items ma jeden wiersz na parę zamówienie–SKU, a stock na parę SKU–magazyn. Rezerwacja ma własny identyfikator: jedno zamówienie może rezerwować ten sam produkt w kilku magazynach. Klucze główne ograniczają duplikaty tylko na podanym poziomie; nie czynią SKU unikalnym w całej tabeli stock.
Przyjmujemy następującą umowę zadania: liczymy popyt tylko z zamówień open; odejmujemy tylko rezerwacje active przypisane do takich zamówień. NULL w on_hand oznacza nieznaną liczbę, a brak rekordu zapasu jest osobnym brakiem danych. To założenia naszego przykładu, nie uniwersalne zasady systemów magazynowych.
Zamówienie 4 jest anulowane, lecz pozostawiliśmy jego pozycję i rezerwację jako przypadek kontrolny. Zamówienie 5 jest otwarte i puste. Produkt E ma popyt bez rekordu zapasu; D ma zapas bez popytu. Dzięki tym przypadkom sprawdzisz osobno filtrowanie anulowanych zamówień, zachowanie pustych zamówień i obsługę brakujących zapasów.
Zadanie 1: dlaczego puste zamówienie ma COUNT(*) równe jeden?
Pytanie brzmi: ile pozycji ma każde otwarte zamówienie, również puste? Zanim uruchomisz kod, zapisz wynik obu liczników.
SELECT o.id, COUNT(*) AS joined_rows, COUNT(i.sku) AS item_rows
FROM orders o LEFT JOIN items i ON i.order_id=o.id
WHERE o.status='open' GROUP BY o.id ORDER BY o.id;
| id | joined_rows | item_rows |
|---|---|---|
| 1 | 2 | 2 |
| 2 | 2 | 2 |
| 3 | 1 | 1 |
| 5 | 1 | 0 |
Zgodnie z oficjalnym opisem złączeń, LEFT JOIN zachowuje niedopasowany wiersz lewej strony, uzupełniając prawą wartościami NULL. W naszym wyniku dla zamówienia 5 nadal istnieje jeden wiersz złączenia. Dokumentacja agregatów rozróżnia COUNT(*), który liczy wiersze, i COUNT(wyrażenie), który pomija wartości NULL.
Liczymy i.sku, ponieważ w rzeczywistym wierszu pozycji jest NOT NULL. Gdyby wybrana kolumna mogła być pusta także w istniejącej pozycji, wynik zero nie dowodziłby braku pozycji. W odpowiedzi warto więc wskazać nie tylko funkcję, ale też własność liczonej kolumny.
Zmiana na INNER JOIN usunie zamówienie 5. Może być poprawna przy innym poleceniu, lecz nie przy wymaganiu „również puste”. Oceniaj zapytanie względem pytania, a nie ogólnej preferencji dla jednego rodzaju złączenia.
Zadanie 2: znajdź mnożenie popytu po JOIN
Ktoś chce obliczyć popyt i dopina tabelę zapasów, aby później porównać liczby. Dlaczego poniższe zapytanie jest błędne?
SELECT i.sku, SUM(i.qty) AS demand
FROM orders o JOIN items i ON i.order_id=o.id
LEFT JOIN stock s ON s.sku=i.sku
WHERE o.status='open' GROUP BY i.sku ORDER BY i.sku;
Zwraca A=6, B=1, C=8, E=1. Tymczasem popyt z otwartych zamówień wynosi A=3, B=1, C=4, E=1. Każda pozycja A dopasowuje się do dwóch magazynów, podobnie C. LEFT JOIN nie gwarantuje zachowania liczby wierszy lewej tabeli, gdy po prawej jest kilka dopasowań.
Nie naprawiaj tego przez SUM(DISTINCT i.qty). Dla A wartości ilości wynoszą 2 i 1, więc przypadkiem otrzymasz 3. Jeśli dwa różne zamówienia zawierałyby po jednej sztuce A, usunięcie powtarzającej się wartości 1 zgubiłoby prawidłowy popyt. Duplikat wartości nie jest tym samym co powielony rekord biznesowy.
Nasza rekomendacja redakcyjna: przed złączeniem sprowadź każdą stronę do jednostki docelowego raportu. Tutaj jest nią SKU. Najpierw agregujemy pozycje, zapasy i rezerwacje osobno, a dopiero potem łączymy trzy wyniki. To rozwiązanie problemu liczności; samo w sobie nie jest obietnicą szybszego planu wykonania.
Zadanie 3: odróżnij zero, nieznany stan i brak rekordu
Zbuduj raport dla SKU, na które istnieje popyt. Potrzebujemy ilości zamówionej, liczby rekordów zapasu, sumy znanych stanów, liczby nieznanych stanów, rezerwacji i dostępności.
WITH demand AS (
 SELECT i.sku, SUM(i.qty) AS needed FROM items i
 JOIN orders o ON o.id=i.order_id WHERE o.status='open' GROUP BY i.sku
), supply AS (
 SELECT sku, COUNT(*) AS stock_rows, SUM(on_hand) AS known_stock,
 COUNT(*) FILTER (WHERE on_hand IS NULL) AS unknown_rows
 FROM stock GROUP BY sku
), held AS (
 SELECT r.sku, SUM(r.qty) AS reserved FROM reservations r
 JOIN orders o ON o.id=r.order_id
 WHERE r.status='active' AND o.status='open' GROUP BY r.sku
)
SELECT d.sku, d.needed, COALESCE(s.stock_rows,0) AS stock_rows,
 s.known_stock, COALESCE(s.unknown_rows,0) AS unknown_rows,
 COALESCE(h.reserved,0) AS reserved,
 CASE WHEN s.sku IS NULL OR s.unknown_rows>0 THEN NULL
      ELSE s.known_stock-COALESCE(h.reserved,0) END AS available
FROM demand d LEFT JOIN supply s ON s.sku=d.sku
LEFT JOIN held h ON h.sku=d.sku ORDER BY d.sku;
| sku | needed | stock_rows | known_stock | unknown_rows | reserved | available |
|---|---|---|---|---|---|---|
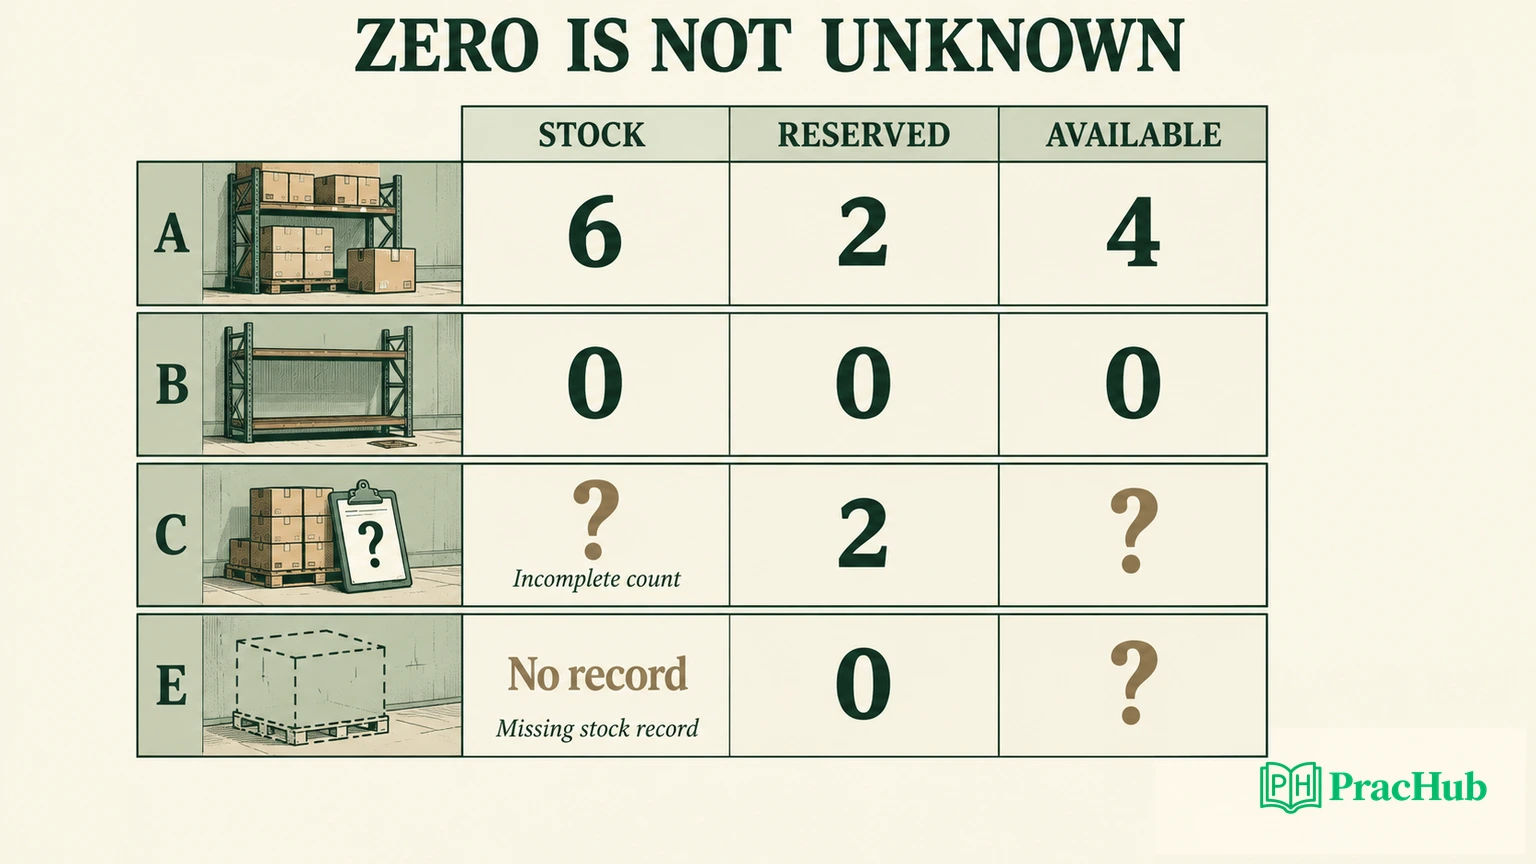
| A | 3 | 2 | 6 | 0 | 2 | 4 |
| B | 1 | 1 | 0 | 0 | 0 | 0 |
| C | 4 | 2 | 5 | 1 | 2 | NULL |
| E | 1 | 0 | NULL | 0 | 0 | NULL |
Dla A dostępność to sześć sztuk minus dwie aktywne rezerwacje. needed zawiera również sztuki już zarezerwowane, a available oznacza wolną pulę. Nie wymagaj ponownego pokrycia całego needed z tej puli: najpierw ustal popyt jeszcze niepokryty rezerwacjami w tym samym zakresie. Wygasła rezerwacja zamówienia 2 i aktywna rezerwacja anulowanego zamówienia 4 nie wchodzą do odejmowanej sumy. Dla B znamy stan zero; to konkretny brak dostępnych sztuk.
Dla C known_stock=5 jest sumą znanych stanów z tej migawki, nie potwierdzonym stanem całego produktu. Jeden magazyn ma NULL, dlatego przy naszej umowie nie podajemy jednej liczby dostępności. Dla E stock_rows=0 oznacza brak rekordu, a unknown_rows=0 mówi jedynie, że nie policzono żadnego istniejącego wiersza z nieznaną wartością. Nie oznacza potwierdzonego zapasu zero.
Dokumentacja agregatów wyjaśnia, że SUM pomija wartości NULL, a dla pustego zbioru zwraca NULL. Właśnie dlatego przechowujemy dodatkowe liczniki. Bez nich COALESCE zastosowane wszędzie mogłoby zamienić dwa różne braki informacji w pozornie pewne zero.
COALESCE(h.reserved,0) jest tutaj uzasadnione umową: brak aktywnej rezerwacji w kompletnym zbiorze oznacza zero zarezerwowanych sztuk. To inne założenie niż „brak pomiaru zapasu oznacza pusty magazyn”. Na rozmowie wypowiedz tę różnicę, zamiast tłumaczyć każdy NULL tak samo.
D nie pojawia się w raporcie, bo punktem wyjścia jest demand. Jeżeli polecenie wymaga całego katalogu, potrzebna będzie inna tabela bazowa lub odpowiednie połączenie zbiorów. Brak D jest więc zamierzony; brak E byłby błędem. Kierunek raportu powinien wynikać z polecenia.
Zadanie 4: filtr aktywności w ON czy w WHERE?
Chcemy zachować wszystkie otwarte zamówienia i zsumować ich aktywne rezerwacje. Poprawna wersja dla tego wymagania:
SELECT o.id, COUNT(r.id) AS reservation_rows,
 COALESCE(SUM(r.qty),0) AS reserved
FROM orders o LEFT JOIN reservations r
 ON r.order_id=o.id AND r.status='active'
WHERE o.status='open' GROUP BY o.id ORDER BY o.id;
Wynik to (1,2,2), (2,0,0), (3,1,2), (5,0,0) w kolejności kolumn id, reservation_rows, reserved. Zamówienie 2 ma wyłącznie wygasłą rezerwację, a 5 nie ma żadnej. Oba pozostają w raporcie.
Jeśli warunek r.status='active' przeniesiesz z ON do WHERE, po złączeniu odrzucisz wiersze bez aktywnego dopasowania. Zostaną zamówienia 1 i 3. Oficjalny opis wyrażeń tabelowych pokazuje, dlaczego ograniczenie dopasowania i filtrowanie wyniku złączenia zewnętrznego mogą dawać różne rezultaty.
Nie używaj jako automatycznej naprawy WHERE r.status='active' OR r.id IS NULL. Zamówienie 2 ma dopasowany wiersz wygasły, więc złączenie nie tworzy dla niego zastępczego wiersza z NULL. Warunek nadal je odrzuci. Najpierw ustal, które rezerwacje mają być dopasowywane.
Zadanie 5: czy przy remisie zwrócić oba magazyny?
Dla każdego SKU wybierz magazyny z największym znanym stanem. A ma remis: W1 i W2 mają po trzy sztuki.
WITH ranked AS (
 SELECT sku, warehouse, on_hand,
 DENSE_RANK() OVER (PARTITION BY sku ORDER BY on_hand DESC) AS pos
 FROM stock WHERE on_hand IS NOT NULL
)
SELECT sku,warehouse,on_hand FROM ranked WHERE pos=1 ORDER BY sku,warehouse;
Wynik zawiera A/W1/3, A/W2/3, B/W1/0, C/W2/5, D/W1/8. Dokumentacja funkcji okna opisuje grupy równorzędnych wierszy: przy naszym porządku oba magazyny A otrzymują ten sam DENSE_RANK.
Jeśli polecenie wymaga dokładnie jednego magazynu, potrzebujesz reguły rozstrzygającej remis. W tym przykładzie może nią być porządek identyfikatora:
ROW_NUMBER() OVER (
  PARTITION BY sku ORDER BY on_hand DESC, warehouse
)
Po odfiltrowaniu pozycji 1 wybierze A/W1. Nie oznacza to, że W1 jest biznesowo lepszy lub bliższy klientowi. To jawna techniczna reguła dla zadania. Dodanie warehouse do ORDER BY w DENSE_RANK zmieniłoby natomiast definicję remisu, więc nie rób tego, jeśli chcesz zachować wszystkich zwycięzców według samego stanu.
Końcowe ORDER BY sku,warehouse porządkuje wyświetlany wynik. Porządek wewnątrz okna służy obliczeniu rankingu; nie zastępuje porządku końcowego raportu. Bez końcowego sortowania nie zakładaj stałej kolejności wierszy. Tę granicę opisuje dokumentacja sortowania.
Filtr usuwający nieznane stany sprawia, że wynik dotyczy tylko pomiarów znanych. C/W2 nie jest dowodem, że drugi magazyn C ma mniej sztuk. Ranking i ocena kompletności danych odpowiadają na różne pytania.
Zadanie 6: zamówienia bez aktywnej rezerwacji i pułapka NOT IN
Szukamy otwartych zamówień bez aktywnej rezerwacji:
SELECT o.id FROM orders o WHERE o.status='open'
AND NOT EXISTS (SELECT 1 FROM reservations r
 WHERE r.order_id=o.id AND r.status='active') ORDER BY o.id;
Otrzymujemy 2 i 5. NOT EXISTS sprawdza brak dopasowanego wiersza spełniającego oba warunki. Zwróć uwagę, że „bez aktywnej rezerwacji” nie jest tym samym co „bez żadnej rezerwacji”: zamówienie 2 ma rezerwację wygasłą.
Przeczytaj również ten celowo problematyczny wariant:
SELECT id FROM orders WHERE status='open'
AND id NOT IN (SELECT x FROM (VALUES(1),(3),(NULL::int)) v(x)) ORDER BY id;
Nie zwraca żadnego wiersza. Dla 2 i 5 brak równej wartości w zbiorze zawierającym NULL nie daje wyniku TRUE. Dokumentacja podzapytań opisuje tę semantykę NOT IN. W naszym kontrolnym zbiorze celowo dodaliśmy NULL; nie twierdzimy, że taki rekord istnieje w tabeli rezerwacji.
Nie wynika z tego zakaz używania NOT IN. Przy odpowiednich ograniczeniach i świadomym traktowaniu wartości pustych może odpowiadać wymaganiu. Na rozmowie pokaż, jakie dane dopuszcza prawa strona i co ma się stać w przypadku braku informacji.
Jak wyjaśnić rozwiązanie, zanim zaczniesz je optymalizować
Dobra odpowiedź do tych zadań zawiera polecenie, jednostkę wiersza, filtr statusu, zachowanie braków i oczekiwany wynik. Następnie wskazuje przypadek, który obala łatwą, ale błędną wersję: pusty numer 5, wygasłą rezerwację numeru 2, dwa magazyny A lub nieznany stan C.
Wykonane kontrole porównały pełne wyniki dziewięciu zapytań, również błędnych wariantów, z zapisanymi oczekiwaniami. Weryfikacja nie obejmowała pomiaru wydajności dużej bazy ani planów wykonania na danych produkcyjnych. Mały zestaw danych dowodzi zachowania pokazanych przypadków, a nie uniwersalnej przewagi CTE czy konkretnego indeksu.
Raport jest też migawką, nie mechanizmem bezpiecznego przydzielania zapasu. Dwie sesje mogłyby odczytać tę samą dostępność i próbować ją wykorzystać. Jeżeli rozmówca przejdzie od raportowania do rezerwowania, trzeba osobno omówić transakcję, konflikt i regułę aktualizacji. Nie przedstawiaj samego SELECT jako gotowego rozwiązania współbieżności.
Pięć pytań PracHub do dalszej praktyki
Te pełne tytuły prowadzą do zweryfikowanych stron ćwiczeń. Część jest po angielsku; nie stanowią raportu o polskim pracodawcy ani obietnicy identycznego zadania na rozmowie.
| Pytanie PracHub | Co sprawdzić po naszym przykładzie |
|---|---|
| Illustrate SQL Join Results with Duplicate Keys | Policz dopasowania, zanim dodasz agregację |
| Compare SQL counts, windows, and NULL semantics | Rozróżnij liczbę wierszy, wartości i grup równorzędnych |
| Debug SQL join that drops rows | Wskaż dokładnie, który filtr usuwa niedopasowany rekord |
| Write SQL to compute current product stock | Ustal, co oznacza stan i z jakiej chwili pochodzi |
| Design an Inventory Service: SQL Schema, Safe Stock Reservations and Analytics | Oddziel raport dostępności od bezpiecznej operacji rezerwacji |
Zacznij od złączeń z powtarzającymi się kluczami. Zapisz oczekiwane wiersze przed wykonaniem kodu, a po uruchomieniu wyjaśnij każdą różnicę. To pozwoli sprawdzić, czy rozumiesz wynik, a nie tylko pamiętasz działającą składnię.
Comments (0)