Entrevista de analista de datos: transforma una pregunta de negocio en un análisis defendible
Quick Overview
ActualPG18.6/psycopg3.3.6/CPython3.12.14 28checks/independentPython8matureflags.12usersA-C-B4each; snapshotOct10/7dayhalfopen A-Cmature B1/4provisional. Afrontend3events2users/backend2; Cfrontend2C1events1user25 vsbackendC1C2twoactive50 withC2duplicate; C2missingfrontend. Presignup/exact7day/orphan/zeroactivity; wrongLEFTJOINWHEREdenomA1A2C1 false100. Unknownoutcomebounds25-100notCI. Backendauthoritystipulatednotinferred. No realinstrumentationinvestigation/experiment/rootcause/causality/financialimpact/loadproof.
«La conversión cayó; ¿revertimos el nuevo flujo?» parece una pregunta de producto, pero primero exige un contrato de datos. Puedes escribir un SQL correcto sobre eventos duplicados, comparar usuarios con ventanas incompletas y terminar defendiendo una decisión que las cifras no permiten tomar.
Para preparar una entrevista de analista de datos, resolveremos un caso sintético de activación a siete días. Ejecutamos 28 comprobaciones PostgreSQL y contrastamos los indicadores por usuario con un cálculo Python independiente. La guía de presentación de análisis de PracHub ayuda a comunicar después la recomendación; aquí construiremos la evidencia que la sostiene.
Límite de evidencia. Las fuentes oficiales respaldan mecanismos de cálculo y contexto analítico. Los usuarios, fechas y decisiones son un ejercicio original. No investigamos un despliegue real ni estimamos un efecto causal. Las preguntas reportadas de práctica no establecen el contenido o proceso actual de una entrevista.
Convierte la petición en una decisión comprobable
La petición ficticia es decidir si la activación justifica revertir un flujo. Antes de comparar porcentajes, pregunta qué acción contará como activación, quién puede realizarla, en cuánto tiempo y qué fuente confirma que ocurrió. «Usuarios activos» no es una definición suficiente.
En este contrato, un usuario activa si completa al menos una operación válida durante los siete días posteriores al alta. El backend registra esa finalización y se declara autoridad para el ejercicio. El frontend recoge señales del mismo hecho, pero puede repetirlas o no registrarlas.
Esa autoridad es una premisa, no una conclusión obtenida porque el backend tenga más registros. En un sistema real tendrías que verificar el significado, cobertura y estados de ambos eventos. Un click de interfaz y una operación terminada podrían medir cosas distintas; no los igualarías sin confirmarlo.
La salida buscada es una fila por cohorte con población elegible y usuarios activados. Conserva aparte los recuentos de eventos: sirven para diagnosticar instrumentación, pero no sustituyen el numerador definido. Una persona con dos eventos sigue contando una sola vez.
Fija población, reloj y madurez antes de agregar
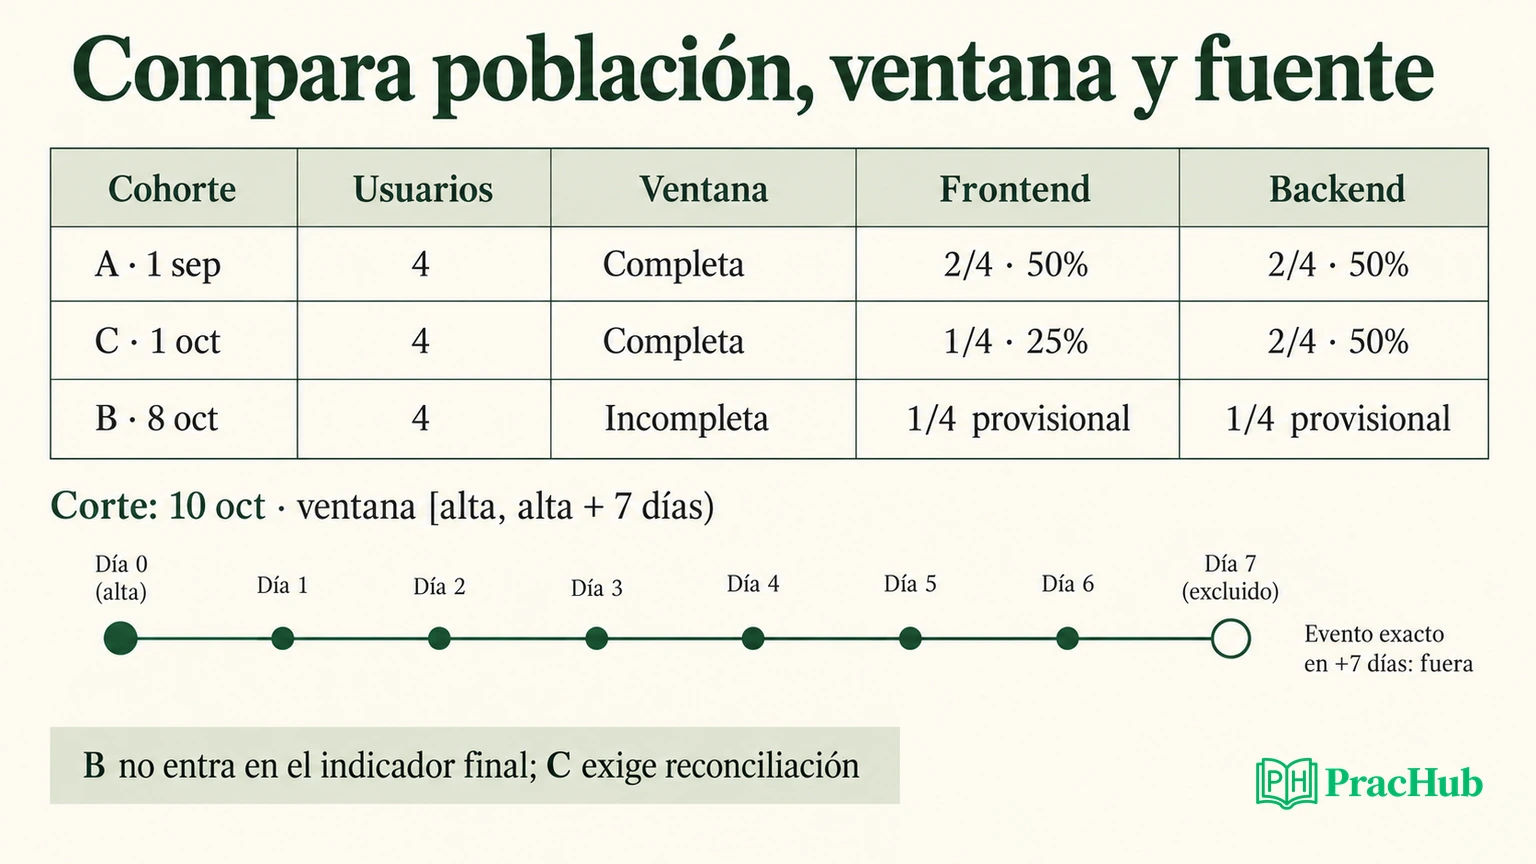
Hay 12 usuarios, cuatro por cohorte. A se registra el 1 de septiembre; C, el 1 de octubre; B, el 8 de octubre. Todos los instantes de la fixture son UTC. El corte de observación es el 10 de octubre a las 00:00.
La ventana es [alta, alta + 7 días): incluye el instante del alta y excluye el borde exacto de siete días. Solo publicamos la tasa final de usuarios cuya ventana completa termina como máximo en el corte: alta + 7 días <= corte. A y C tienen su ventana completa; B todavía no.
En B observamos un usuario activado entre cuatro. Ese 1/4 describe lo registrado hasta el corte, no su activación final a siete días. No rellenamos como fracasos definitivos los tres usuarios que aún tienen tiempo para completar la operación.
Inferencia de preparación: muestra B como provisional y sepáralo de la comparación final. Si negocio necesita una señal temprana, define otra métrica con un horizonte comparable más corto. No cambies silenciosamente la ventana mientras mantienes el mismo nombre del indicador.
La consulta también conserva usuarios sin actividad. A4 no tiene eventos, pero pertenece al denominador maduro. Eliminarlo convertiría falta de actividad en desaparición de la población y mejoraría artificialmente el porcentaje.
Filtra eventos válidos antes de elegir el primero
A1 tiene un evento anterior al alta y dos admisibles después. A3 tiene otro exactamente en el borde +7 días. El evento previo y el del borde deben quedar fuera. El programa añade además un evento huérfano, sin usuario elegible, para registrarlo como problema de calidad separado.
Hecho oficial. PostgreSQL documenta que las funciones de ventana operan sobre las filas que sobreviven al filtrado de la consulta. En valid_front, primero limitamos eventos al usuario y ventana; después numeramos sus filas:
SELECT u.user_id, e.event_id, e.event_at,
       ROW_NUMBER() OVER (
         PARTITION BY u.user_id
         ORDER BY e.event_at, e.event_id
       ) AS rn
FROM users u
JOIN frontend e USING (user_id)
WHERE e.event_at >= u.signup_at
  AND e.event_at < u.signup_at + INTERVAL '7 days'
  AND e.event_at < TIMESTAMPTZ '2026-10-10 00:00:00+00';
El resultado rn=1 representa el primer evento válido por usuario, con event_id como desempate. Para A1 es el 2 de septiembre, no el evento previo al alta. Elegir MIN sobre todos sus eventos y filtrar después podría descartar a un usuario con actividad admisible posterior.
Para comprobar «al menos uno», puedes usar EXISTS; el ranking añade la identidad del primer evento válido. Aquí usamos el ranking para inspeccionar cuál fue el primer evento aceptado; luego flags convierte su existencia en un booleano por usuario.
Mantén el denominador aunque no haya eventos
flags comienza con users y consulta si existe actividad válida en cada fuente. Así conserva sus 12 identidades, incluidas las que no activaron. Añade mature como condición separada de la existencia del evento.
El laboratorio reproduce una consulta defectuosa: LEFT JOIN seguido de condiciones sobre la fecha del evento en WHERE. Esas condiciones eliminan los usuarios sin evento. El filtro deja A1, A2 y C1: dividir tres activados por esos mismos tres usuarios produce el falso 100%.
El JOIN no basta para describir qué población conserva la consulta. Comparar los identificadores antes y después del filtro permite detectar qué usuarios sin actividad desaparecieron del denominador. La corrección debe recuperar ocho usuarios maduros, no simplemente ejecutar sin error.
Hecho oficial. La documentación de agregados PostgreSQL distingue agrupación y filtrado de entradas. Sobre flags, una fila ya significa un usuario, por lo que podemos contar población y sumar sus booleanos:
SELECT cohort,
       COUNT(*) AS eligible,
       SUM(frontend_active::int) AS frontend_users,
       SUM(backend_active::int) AS backend_users
FROM flags
WHERE mature
GROUP BY cohort
ORDER BY cohort;
La segunda consulta está incluida en report.sql y se ejecuta dentro del laboratorio, con las vistas instaladas por analyze.py. No es una consulta autónoma contra tablas desconocidas: el paquete muestra cómo se construye cada dependencia y limpia su schema después.
Reconciliar totales no basta: abre los identificadores
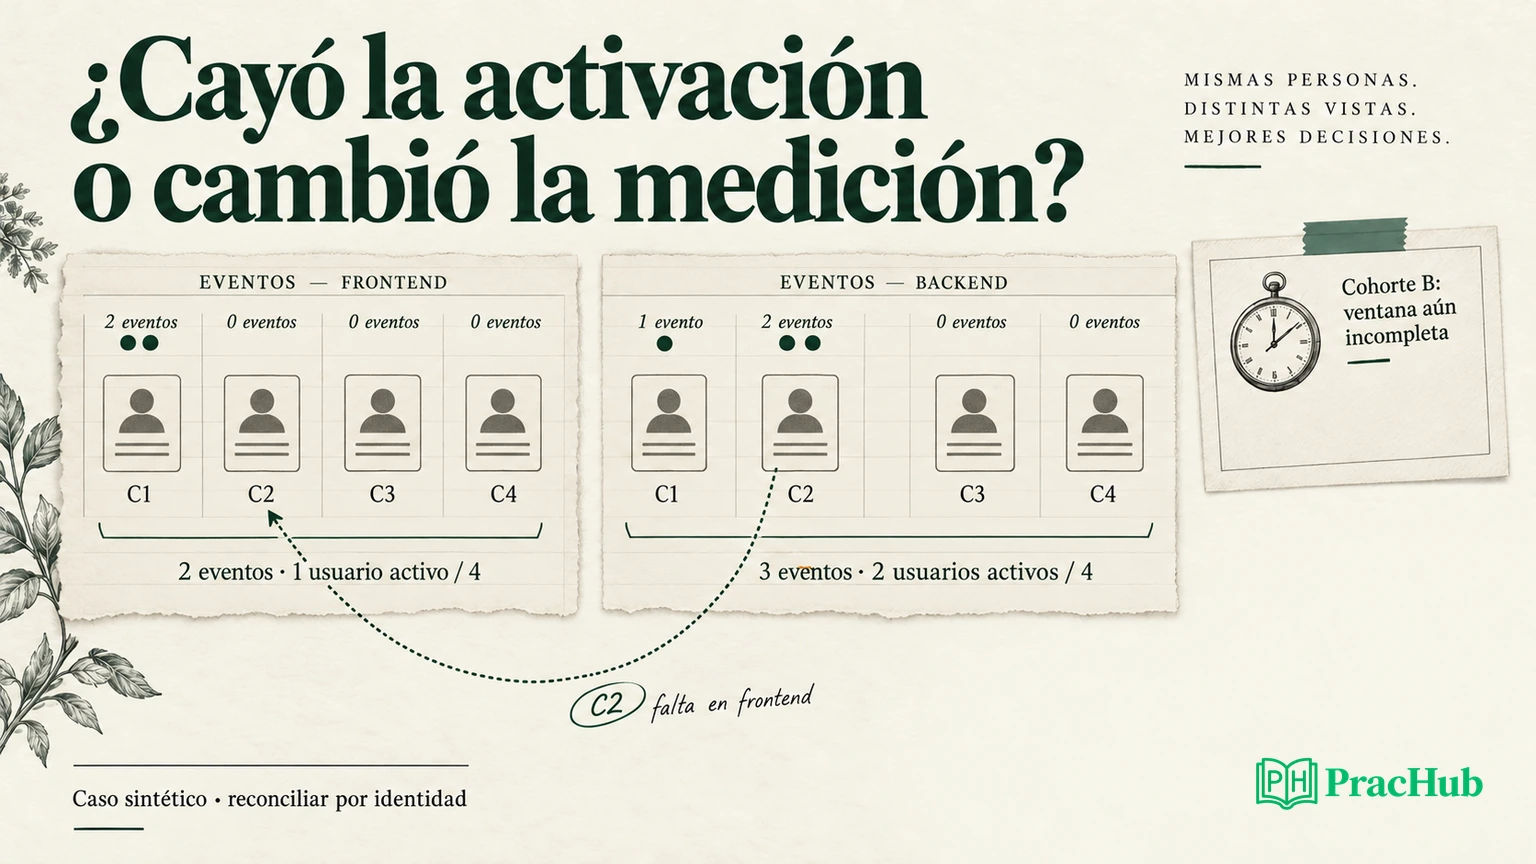
En A, tres eventos frontend válidos corresponden a dos usuarios activados: A1 y A2. Contar eventos produciría 3/4, o 75%, en vez de 2/4, o 50%. El backend también confirma esos dos usuarios bajo la misma ventana.
C tiene una coincidencia engañosa. Frontend contiene dos eventos de C1; backend contiene actividad de C1 y C2, con dos registros para C2. El número de eventos frontend, dos, coincide con el número de usuarios backend, también dos. El indicador parecería correcto por casualidad si compararas solo esos totales.
Al deduplicar por identidad, frontend da 1/4, o 25%; backend da 2/4, o 50%. La conciliación encuentra exactamente C2 como usuario maduro con finalización backend y sin señal frontend. No hay usuarios maduros activos únicamente en frontend en este juego.
| Cohorte | Población | Madurez al corte | Frontend por usuario | Backend por usuario |
|---|---|---|---|---|
| A: 1 de septiembre | 4 | Completa | 2/4: 50% | 2/4: 50% |
| C: 1 de octubre | 4 | Completa | 1/4: 25% | 2/4: 50% |
| B: 8 de octubre | 4 | Incompleta | 1/4 provisional | 1/4 provisional |
El descenso frontend entre A y C es de 25 puntos porcentuales. El indicador definido con backend permanece en 50% para ambas cohortes. Eso describe las filas del caso; no demuestra que el producto real no tenga problemas ni identifica la causa técnica de la ausencia.
Separa el hallazgo de las hipótesis de causa
Observación del laboratorio: C2 está en backend y falta en frontend. Hipótesis no ejecutadas: un cambio del SDK, una interrupción de red o un camino alternativo podrían explicar una ausencia semejante en un sistema real. Aquí construimos esa ausencia; no rastreamos requests ni diagnosticamos ninguna de esas causas.
La siguiente investigación propuesta seguiría C2 por identidad, ventana, tipo de evento y estado de operación. Después contrastaría cobertura por versión o dispositivo si existieran esos campos. Nuestro dataset no los tiene; no inventes una segmentación cuyos resultados no puedes calcular.
Tampoco concluyas que «el nuevo flujo causó la caída». La comparación de cohortes no asigna usuarios aleatoriamente a una versión y no contiene un tratamiento verificable. Puede orientar una investigación de medición, pero no estima lo que ocurriría al revertir.
Contexto oficial. Microsoft Research presenta su plataforma de experimentación como trabajo sobre experimentos controlados en línea. Propuesta del ejercicio: si se plantea una intervención futura, definir población, asignación, resultado y guardrails antes de observarla. No hemos ejecutado ese experimento.
Comunica qué incertidumbre sigue abierta
Antes de reconciliar, solo sabes que C1 aparece activo en frontend. Si la fuente puede omitir resultados, los otros tres usuarios son desconocidos respecto a esa medición. Bajo ese supuesto, la activación de C podría estar entre 1/4 y 4/4: 25% a 100%.
Son límites deterministas sobre resultados no observados, no un intervalo de confianza ni una predicción. Una vez aplicada la autoridad backend estipulada para el caso, conocemos dos activos y dos inactivos en C. La conciliación aporta información; no convierte el límite anterior en un análisis estadístico inferencial.
Los cuatro usuarios por cohorte son una población sintética finita, creada para revisar la lógica. No calculamos significancia, poder ni incertidumbre sobre clientes reales. La guía de técnicas cuantitativas de NIST es lectura adicional para distinguir esas herramientas del control de calidad efectuado aquí.
No dimensionamos ingresos o ahorro. Activación, compra, retención y beneficio son variables diferentes. Si negocio necesita una decisión económica, pide importes, costes y una relación evaluable entre la intervención y el resultado antes de multiplicar porcentajes por facturación.
Entrega una recomendación con condiciones para cambiarla
Una nota defendible puede comenzar así: «No recomiendo revertir el producto basándome en la caída frontend sin reconciliar. A y C tienen 2/4 activados según la fuente de finalización definida; frontend pierde C2 y repite C1. B no completó todavía su ventana».
La recomendación inmediata del ejercicio es investigar el indicador y mantener separada la decisión sobre el flujo. El responsable de datos puede verificar C2 y la cobertura de las fuentes; producto debe conocer qué parte del resultado es provisional. No presentamos como realizada esa investigación propuesta.
Añade una condición que cambiaría tu recomendación: una fuente validada muestra una degradación material con población y ventana comparables, o aparece evidencia de un fallo que requiere mitigación inmediata. El umbral de materialidad no está dado; necesitarías acordarlo según impacto y tolerancia al riesgo.
Para cada dato pendiente, nombra la comprobación, su responsable y la decisión que permitirá tomar. Nuestro paquete de análisis incluye una nota sintética, SQL, entradas CSV, programa, resultados y README para rastrear esa cadena.
Defiende el análisis bajo preguntas de seguimiento
Las 28 comprobaciones se ejecutaron con CPython 3.12.14, psycopg 3.3.6 y PostgreSQL 18.6. El cálculo Python independiente coincide con los ocho usuarios maduros y con sus dos indicadores booleanos, frontend y backend. Eso verifica la implementación finita; no prueba calidad de instrumentación, rendimiento a escala ni explicación causal.
Si te preguntan por B, muestra su fecha de alta y la de corte: todavía no puedes publicar su tasa final a siete días. Si preguntan por duplicados, muestra C1 y explica por qué dos eventos no son dos personas. Si cuestionan backend, reconoce que su autoridad es una premisa que necesita validación fuera de esta fixture.
Los siguientes destinos son preguntas reportadas de práctica. Sus registros pertenecen a roles Data Scientist, pero estas tareas SQL de cohortes y denominadores también sirven al razonamiento analítico aquí; no afirmamos que representen una entrevista específica de Data Analyst.
| Pregunta completa | Qué límite comprobar |
|---|---|
| Write SQL for retention, conversion, and churn | Unidad de usuario, ventana y población elegible. |
| Produce dating profile funnel report by cohort | Diferencia entre alta, evento y cohorte madura. |
| Compute cohort GMV and payer rate with edge cases | Diferencia entre importe, usuarios y repetición de registros. |
| Compute signup rate and retention from raw logs | Cobertura y trazabilidad de los logs. |
| Write SQL for profit, growth, retention | Qué dato adicional exige una conclusión económica. |
Continúa con Produce dating profile funnel report by cohort. Antes de escribir SQL, fija la decisión y predice qué usuarios deben permanecer en el denominador. Como siguiente ejercicio, introduce una repetición y una llegada tardía; vuelve a comprobar la ventana y conserva la distinción entre hallazgo y causa.
Comments (0)