Amazon AI 辅助编程 OA 2026:仓库 Bug、提示词与隐藏测试
本文译自 PracHub 的英文原文阅读英文原文
内容概览
Amazon AI 辅助编程 OA 指南 2026:仓库 Bug、AI 提示词与隐藏测试,在原有的题型和流程说明之外,新增了一组来源明确的 PracHub 练习题。新增部分列出每道题实际对应的公司、题库中记录的轮次、难度、题目形式和限时做题流程,并不保证真实测评会原题复用。
你打开了一个陌生的代码仓库,好几个测试在报错,旁边还有一个 AI 助手等着你下指令。难点不在于让 AI「把代码修好」,而在于你要先把系统看懂,才能判断该问什么、答案对不对、隐藏测试还可能暴露什么问题。
这就是 2026 年多位 Amazon 候选人反馈的新挑战。Amazon 并没有公布统一的 AI 辅助 OA 格式,所以本文把官方说明和候选人反馈分开写,并给你一套备考方法:就算具体的计时、仓库或 bug 数量变了,这套方法依然管用。
先从 PracHub 的 Amazon 真实面试题 入手,尤其是当前的软件工程基础和编程面经。然后用下面的流程,把这些题变成仓库级别的调试练习。
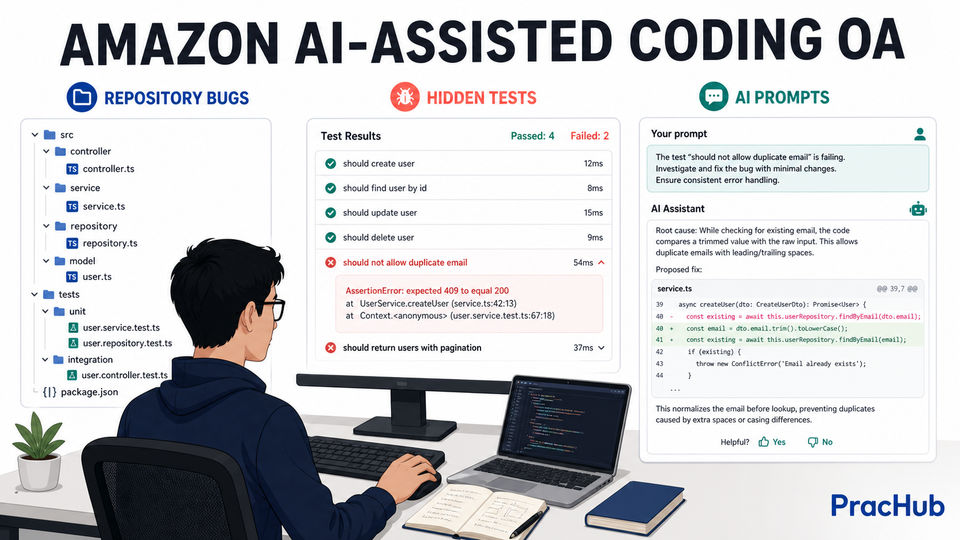
最强的候选人始终掌控诊断过程、AI 生成的 diff 和最终的验证证据。
快速结论
把 Amazon 的 AI 辅助编程题当成「带 AI 工具的调试测评」,而不是写提示词比赛。 近期的候选人反馈描述的场景是:陌生代码库、已损坏的功能、内置助手,以及可见或隐藏测试。具体结构似乎因岗位和地区而异。
最好的循环是:复现失败,追踪代码路径,提出假设,问一个范围明确的问题,检查 diff,运行测试,并自己验证接口约定。
只使用测评明确提供或允许的工具。Amazon 目前的校招 OA 说明提到,浏览器活动可能被记录,并提醒候选人不要复制粘贴;最终以你的邀请邮件和测试环境里的说明为准。
Amazon AI 辅助编程 OA 是什么?
Amazon 官方的 SDE 测评页面仍然说明,编程测评因岗位而异,并让候选人查看邀请邮件了解具体结构。校招页面说格式可能因国家而不同,SDE II 页面则介绍了更传统的两道编程题。
另外,2026 年有多位候选人反馈了一种带内置 AI 助手的新型仓库题。反馈中常提到 修复现有应用里的几个 bug 并通过测试集。有些候选人拿到的是传统算法题加仓库题;也有人反馈顺序、计时和测试数量都不一样。
| 证据级别 | 能支持什么 | 不能证明什么 |
|---|---|---|
| Amazon 官方说明 | OA 因岗位而异;编程、解决问题以及健壮、经过测试的代码都很重要 | 统一的 AI 仓库格式、计时或通过分数 |
| 多位 2026 年候选人的反馈 | 部分 SDE 候选人收到了 AI 辅助的仓库调试题 | 每个团队、国家或级别都用同一版本 |
| 你的邀请邮件和测评界面 | 你的各个部分、时间限制、允许使用的资源和诚信规则 | 其他候选人的测评是怎么配置的 |
实际结论: 按反馈中的仓库题格式去准备,但不要死记某一位候选人的数字。把你的邀请邮件当作考试说明来读。
与传统 DSA 题有什么不同
普通的编程题会给你一个简洁的接口约定,让你设计算法。仓库题给你的是一个只能部分运行的系统,要你先把接口约定还原出来,再做安全的修改。
| 维度 | 传统 DSA 题 | AI 辅助仓库题 |
|---|---|---|
| 起点 | 函数签名和约束条件 | README、项目目录树、测试和现有代码 |
| 主要挑战 | 选择并实现一个算法 | 定位出错的路径,并在不引入回归的前提下修复行为 |
| 上下文 | 通常只有一个文件 | controller、service、model、repository、配置和测试 |
| AI 的角色 | 通常没有 | 可能帮你查看或修改代码,具体取决于测评规则 |
| 证明方式 | 复杂度加测试用例 | 复现过程、聚焦的 diff、通过的测试和对接口约定的推理 |
算法也别丢。候选人反馈显示,这类新题可能和常规编程题一起出现,而且后续的 Amazon 面试仍然会考编程基础。用 PracHub 的 Amazon 软件工程师编程题 来保持这一块的手感。
这类题可能在考什么
Amazon 没有公布这种反馈中的题型的评分标准。结合题目设计、官方强调的健壮且经过测试的代码,以及候选人的反复描述,下面这些能力是合理的备考目标,而不是已经确认的评分权重。
| 可能的考察点 | 做得好是什么样 |
|---|---|
| 仓库导航 | 修改之前,先找到相关入口并追踪数据流 |
| 调试判断 | 根据失败信息和需求,提出可验证的假设 |
| 指挥 AI | 提示词范围窄、证据充分、有约束 |
| 代码审查 | 检查 AI 生成的每一处改动,拒绝不必要的改动范围 |
| 验证 | 先跑聚焦的测试,再跑更大范围的测试,并在脑中或代码里补充边界用例 |
| 责任感 | 你能解释清楚补丁为什么满足接口约定,既不甩锅给工具,也不盲信工具 |
共同点是对工程的掌控力。AI 可以加快探索,但诊断和提交的代码仍然由你负责。
仓库调试的七步循环
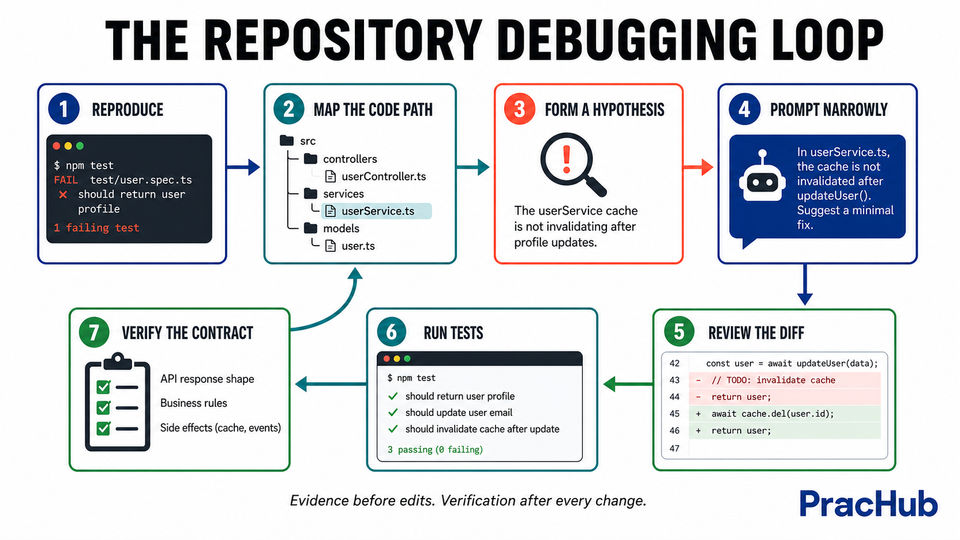
每个循环都要足够小,这样你才能把证据、改动和结果对应起来。
1. 先读接口约定,再看实现
浏览任务描述、README、测试命令、项目结构和可见测试。用一句话写下预期行为。失败的测试是证据,但不一定是完整的需求。
2. 复现一个失败
运行最小的相关测试或操作。记下准确的断言、异常、状态码或状态不一致的地方。如果所有测试都挂了,就挑一条有代表性的路径,不要让助手去修整个仓库。
3. 追踪执行路径
沿着请求或函数调用,从入口一直看到数据访问。搜索出错的符号、相关的 model 字段和相邻的测试。画出一条简短的路径,比如 route -> controller -> service -> repository。
4. 提出假设
写下你认为哪里有问题,以及什么观察结果能推翻这个假设。这样可以避免随手乱改,也让 AI 助手的排查范围有边界。
5. 一次提示只做一件事
让助手检查某条具体路径、解释某个条件,或给出最小的补丁。附上需求、观察到的失败、相关文件和约束。不要为了让测试变绿而让它去改测试。
6. 检查 diff
检查每一行改动。留意有没有改变公开行为、吞掉错误、重复逻辑、无关的重构、凭空捏造的 API,或者过宽的异常处理。无法自圆其说的改动,一律还原。
7. 先小范围验证,再大范围验证
先重跑最初的失败。然后跑周边的测试,时间允许的话再跑完整测试集。最后,测一个样例里没有出现的边界。
想多练这种思路,可以用 PracHub 的 现有代码库面试指南。
如何写出更好的 AI 提示词
好的提示词能减少不确定性,同时不放弃自己的判断。差的提示词把你的思路藏起来,还会招来一个很大、很难审查的补丁。
| 差的提示词 | 更好的提示词 | 好在哪里 |
|---|---|---|
| "Fix this repository." | "The reset-password test expects an expired token to be rejected. Trace the validation path and identify the smallest likely defect. Explain before editing." | 点明了行为、证据、范围和要求的动作 |
| "Why do tests fail?" | "Test fundLoan_rejectsOverfunding fails with an updated balance. Inspect only the service and repository calls involved and list two hypotheses." | 引导排查,但不预设答案 |
| "Make all tests pass." | "Propose a minimal patch for the confirmed boundary bug. Do not edit tests or public interfaces. Show the diff and name the edge cases it covers." | 限定了范围,也让审查成为可能 |
一个可以反复使用的提示词格式是:上下文 + 预期行为 + 观察到的证据 + 范围 + 要求的动作 + 约束。拿到回复后,自己去看代码。一段写得漂亮的解释不等于证明。
实例:AI 很容易误诊的一个 bug
设想一个给贷款出资的服务。可见测试只检查一笔正常转账,但隐藏测试可能会试零金额、超过贷款剩余额度的金额,或者一条记录写入成功、另一条失败的情况。
async function fundLoan(userId: string, loanId: string, amount: number) {
  const user = await users.find(userId);
  const loan = await loans.find(loanId);

  if (user.balance < amount) throw new Error("insufficient balance");

  user.balance -= amount;
  loan.funded += amount;
  await users.save(user);
  await loans.save(loan);
}
最明显的检查已经有了,但接口约定并不完整。优秀的候选人会问:amount 可以是零或负数吗?出资额可以超过贷款剩余额度吗?任何一个实体不存在时会怎样?两次写入必须是原子的吗?
一个范围明确的提示词可以这样写:"The funding service passes the happy path but the contract requires a positive amount, no overfunding, and no partial state update. Inspect this method and its repository API. Propose the smallest change that enforces those invariants without changing tests."
然后用 amount = 0、负数、刚好等于剩余额度、比剩余额度多一个单位、用户资金不足、实体缺失,以及模拟的持久化失败,来验证提出的补丁。助手可以给你代码建议,但只有你自己的测试才能让你有把握。
隐藏测试通常会考什么
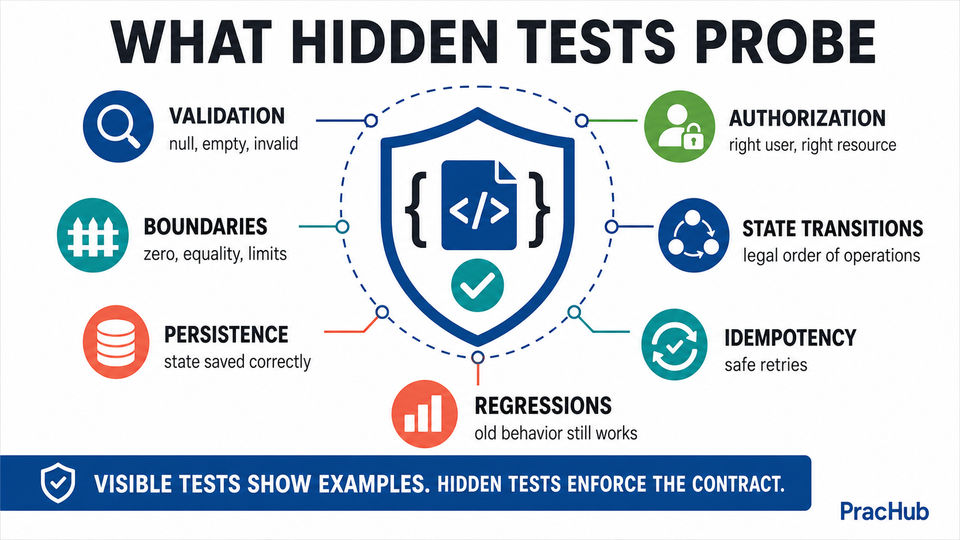
把每条需求都转化成至少一个正常用例、一个边界用例和一个失败用例。
| 隐藏测试类型 | 要问自己的问题 |
|---|---|
| 校验 | 输入是 null、空、零、负数、格式错误或未知值时会怎样? |
| 边界 | 相等、过期、容量上限和最后一个元素的情况处理对了吗? |
| 持久化 | 预期的状态真的保存了吗?是不是只保存了一次? |
| 授权 | 一个用户能修改另一个用户的资源吗? |
| 状态转换 | 操作能在非法状态下执行,或在完成后重复执行吗? |
| 幂等与重试 | 重复请求会造成重复处理或把汇总数据搞错吗? |
| 回归 | 补丁有没有把相邻的、原本正常的路径改坏? |
隐藏测试通常不是脑筋急转弯。它们编码的是需求和工程上的不变量,而可见样例没有完全覆盖这些内容。PracHub 的 编程测评隐藏测试用例指南 提供了更全面的边界检查清单。
最浪费时间的五个错误
还没复现就开始写提示词。 没有真实的失败信息,助手只能根据表面模式瞎猜。
一次改太多。 跨多个文件的重构,会让你分不清是哪处改动修好了 bug,哪处引入了回归。
改测试去迎合代码。 除非题目明确说某个测试有误,否则测试和书面的接口约定都是要满足的证据,不是要清除的障碍。
相信可见测试全绿。 只测正常路径的测试集,仍然可能漏掉授权、回滚、边界和幂等方面的问题。
练习题: Debug a Node.js car-rental backend: leaked cars, missing new cars, lost edits (Amazon · 软件工程师)
使用未经许可的外部工具。 平时练习可以用任何合法的工具,但正式 OA 期间只能使用 Amazon 和测评平台允许的资源。不要把测评的私密内容粘贴到外部服务里。
七天备考计划
| 天数 | 重点 | 产出 |
|---|---|---|
| 1 | 限时的 Amazon 编程诊断题 | 一道 DSA 题加一份错误记录 |
| 2 | 梳理仓库 | 把三个功能从入口一路追踪到持久化 |
| 3 | 复现 bug | 不用 AI 修复两个预埋的 bug |
| 4 | 范围明确的提示 | 用 AI 做诊断,然后检查它提出的每一行代码 |
| 5 | 设计隐藏测试 | 补充校验、边界、状态和回归用例 |
| 6 | 完整模拟 | 限时完成一道算法题和一道仓库调试题 |
| 7 | 轻量复习和环境准备 | 确认邀请邮件里的规则、环境、语言和测试命令 |
用 PracHub 的 Amazon 题库 做诊断题和算法练习。到了后面的行为面试阶段,把技术准备和 Amazon 领导力准则面试题 以及 Amazon OA 工作模拟指南 搭配起来。
用 PracHub 的真实题目练习
这些都是 Amazon 题库里的真实记录,并不是对你实际测评的预测。我们优先选择提到 OA 的来源面经,再使用 PracHub 中记录的技术电面、Onsite 和 Take-home 轮次。表格里保留了题库中记录的轮次,避免证据被改标成别的类型。
| 题目 | 证据 | 难度 | 主要考点 |
|---|---|---|---|
| Q1: Highest Average-Salary Team in an Org Chart | Amazon · 技术电面 | 中等 | 滑动窗口 |
| Q2: Merge Overlapping Time Ranges | Amazon · 技术电面 | 中等 | 区间 |
| Q3: Caesar Cipher with Translation-Table Optimization | Amazon · 技术电面 | 中等 | 字符串 |
| Q4: Detect and Break a Cycle in a Singly Linked List | Amazon · 技术电面 | 中等 | 图 |
这些题目实际在问什么
Q1. Highest Average-Salary Team in an Org Chart
题库证据:Amazon,技术电面,中等。 组织架构图中平均薪资最高的团队。公司的汇报关系是一个单一的层级结构。每位员工都有唯一的整数 id、姓名、整数薪资,以及 managerid,即其汇报对象的 id。恰好有一位员工(CEO)的 managerid = null,表示没有上级。
Q2. Merge Overlapping Time Ranges
题库证据:Amazon,技术电面,中等。 合并重叠的时间段。你在为一间共享会议室开发排期后端。每一条已提交的预订都记录为一对整数时间戳(epoch 秒)[start, end],其中 start <= end。
Q3. Caesar Cipher with Translation-Table Optimization
题库证据:Amazon,技术电面,中等。 实现凯撒密码。给定字符串 text 和整数 shift,返回一个新字符串:其中每个字母都在各自的大小写范围内向前移动 shift 位,并在字母表末尾循环回绕;所有非字母字符保持不变。
Q4. Detect and Break a Cycle in a Singly Linked List
题库证据:Amazon,技术电面,中等。 给你一个单链表的头节点。链表中可能有环,也可能没有:某个节点的 next 指针可能指回前面的节点,形成一个环。要做两件事:1. 检测链表是否有环。2.
像正式测评一样做这一组题
- 先把四道题都读一遍。 给每道题估一个难度,写代码之前先定好顺序。
- 先别看答案。 打开编辑器之前,先写下不变量、复杂度目标和三个边界用例。
- 只用一个计时器。 最后留五分钟,用来测试边界、平局、大规模数据和输出格式。
- 记录失败模式。 记下被破坏的不变量或漏掉的边界用例,而不是只写题目名称。
Amazon AI 辅助编程 OA 常见问题
现在每个 Amazon SDE OA 都有 AI 辅助的仓库题吗?
Amazon 没有任何公开页面确认这一点。多位 2026 年的候选人反馈拿到了这种题,包括 SDE I、应届生、实习生和部分 SDE II 流程的候选人,但格式各不相同。请以你的邀请邮件里写明的结构为准。
有多少个 bug 和隐藏测试?
候选人反馈中提到的 bug 数量和测试数量各不相同。不要围着某一个数字来备考。练好一套可以重复使用的「调试加验证」循环,不管仓库里有两个缺陷还是好几个,都能用。
内置的助手是 Amazon Q 吗?
不要想当然。Amazon 对 Amazon Q Developer 有公开文档,但这并不能说明测评内置助手的身份和能力。请使用测评里给出的界面和帮助文字。
OA 期间可以用 ChatGPT、Claude 或其他外部 AI 吗?
只有测评说明明确允许才可以。Amazon 的校招 OA 说明提到,浏览器使用情况可能被记录,并提醒不要复制粘贴。保险的做法是,只使用内置助手和你的测评明确允许的资源。
如果 AI 给出的补丁通过了可见测试怎么办?
检查 diff,并自己测试接口约定。检查非法输入、边界、持久化、授权、重试和相邻行为。就算部分代码是工具生成的,提交的实现也由你负责。
全部测试通过就保证能拿到面试吗?
Amazon 没有公布这种反馈中的题型的统一分数线或权重。官方的 OA 页面介绍的是更全面的评估,可能包括编程、解决问题、工作风格和其他因岗位而异的部分。每个必做的部分都要认真完成。
最后的总结
2026 年的 Amazon AI 辅助编程 OA 改变的是界面,不是工程标准。你仍然需要理解需求、在陌生代码里导航、定位缺陷、做出小而站得住脚的改动,并证明它在正常路径之外也能工作。
两条线一起练:用 PracHub 的 Amazon 编程题 练算法速度,再用最新的 Amazon 面经和文字版解答 来练调试、测试和整轮面试的判断力。目标不是让 AI 看起来很能干,而是证明你才是掌控全局的那个工程师。
来源与延伸阅读
练习 Amazon 面试题
练习 Amazon 面试题相关文章(英文)
Roblox Robots Assessment: How to Practice Problem Solving and Iteration
Prepare for the Roblox Robots assessment with official practice links, controlled experiments, failure analysis, and clear limits on community scoring claims.
NVIDIA Ignite Internship 2027: Eligibility, Interview Process, and Preparation
NVIDIA Ignite Internship 2027 guide: eligibility, application timing, interview stages, resume tips, coding preparation, and current official updates.
Stripe SWE Intern OA 2027: One Long Coding Problem, Input Parsing, and Clean Code
Stripe SWE Intern OA 2027 guide to the reported 60-minute coding problem, parsing, hidden tests, clean code, practice questions, and next rounds.
Capgemini AI-Assisted Coding Assessment: Practice Debugging, Feature Changes, and Verification
Prepare for reported Capgemini AI-assisted coding variants with an original debugging task, owner-filter feature, bounded prompts, and regression checks.